

Puntos clave
- Un Fabric data agent sin instrucciones y sin consultas de ejemplo acertó 19 de 20 preguntas y respondió una con otra lectura razonable, sobre un esquema sintético limpio. Ese es el problema: parece terminado.
- El único fallo no fue un SQL malo. El agente eligió una lectura de "cliente más grande" en su propia reformulación de la pregunta y después escribió un SQL correcto para esa lectura.
- Puntúa la pregunta reformulada y el SQL generado, no solo el texto de la respuesta. Las dos cosas vienen en la respuesta si llamas al agente desde código.
- Calcula las respuestas de referencia fuera del agente, sobre la misma instantánea de datos, y apunta todas las lecturas de cada pregunta ambigua antes de ejecutarla.
- El uso de tokens que devuelve la respuesta da una estimación que probablemente es un mínimo, no la factura. Confírmalo en la Capacity Metrics app antes de dar una cifra.
- Vuelve a ejecutar el mismo conjunto después de cada cambio de runtime, modelo, instrucciones o ejemplos. El próximo despliegue del runtime empieza el 2 de noviembre.
Imagina un equipo que un viernes conecta un data agent a un lakehouse, le hace diez preguntas cuyas respuestas ya conoce y acierta las diez. El lunes se lo pasa al negocio. El martes alguien pregunta "¿quién es nuestro cliente más grande?", recibe un nombre seguro y bien formateado y lo pone en una diapositiva. Nadie preguntó a qué "más grande" se refería, y nadie se daría cuenta de que el agente tampoco lo preguntó.
Quería saber qué detecta de verdad una línea base antes de cualquier ajuste, así que hice una. Este post cuenta el método, los números y lo que cambiaría antes de fiarme del resultado.
Modelo con nombre: referencia → sembrar → leer → repetir
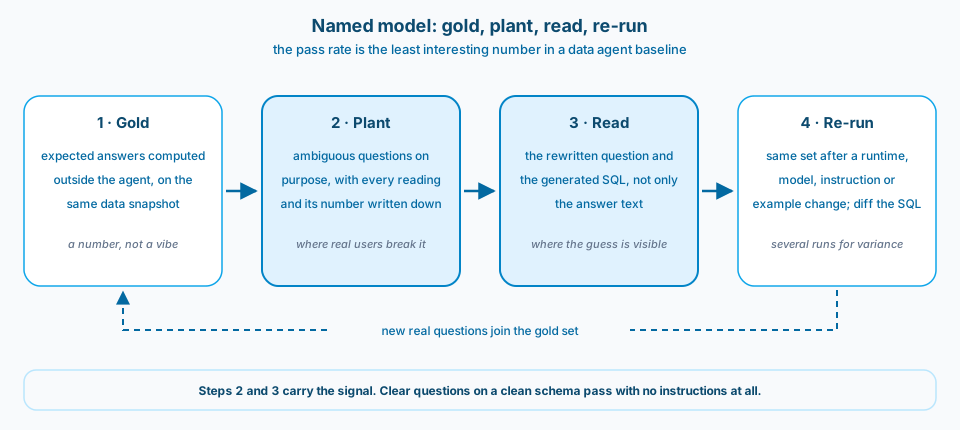
Figura 1. El porcentaje de aciertos es el resultado menos interesante. Los pasos 2 y 3 son los que justifican una línea base.
Contexto y restricción
Qué es y qué no es. Es una prueba propia con datos sintéticos: un esquema derivado de TPC-H con un factor de escala aproximado de 1, generado con un generador de Spark con semilla en lugar de la herramienta oficial dbgen y cargado en un lakehouse como siete tablas Delta. No son datos oficiales de TPC-H y nada de esto es un resultado TPC auditado. Es una ejecución por pregunta, en la capacidad de pago más pequeña, con preguntas en inglés sobre un esquema sencillo y con buenos nombres. No es una afirmación sobre la precisión en producción, y 20 preguntas son un smoke test, no un benchmark. Toma cada número de abajo como "lo que muestra una tarde cuidadosa", no como "lo que saca un data agent".
La configuración. Un lakehouse, un data agent, las siete tablas seleccionadas, sin instrucciones del agente, sin instrucciones de la fuente de datos, sin consultas de ejemplo y publicado. Las respuestas de la API indicaban el modelo gpt-5.1. El agente estaba en el runtime estándar (lo leí en la configuración del agente después de la ejecución): el interruptor del runtime en preview no está activado. Llamé al agente publicado desde un script de Python con el SDK de Python para Fabric data agents, con una conversación nueva por pregunta, para que ninguna respuesta pudiera apoyarse en la anterior. Cada pregunta tuvo una respuesta de referencia calculada con DuckDB sobre la misma instantánea Delta, no con el agente ni con el SQL endpoint que usa el agente.
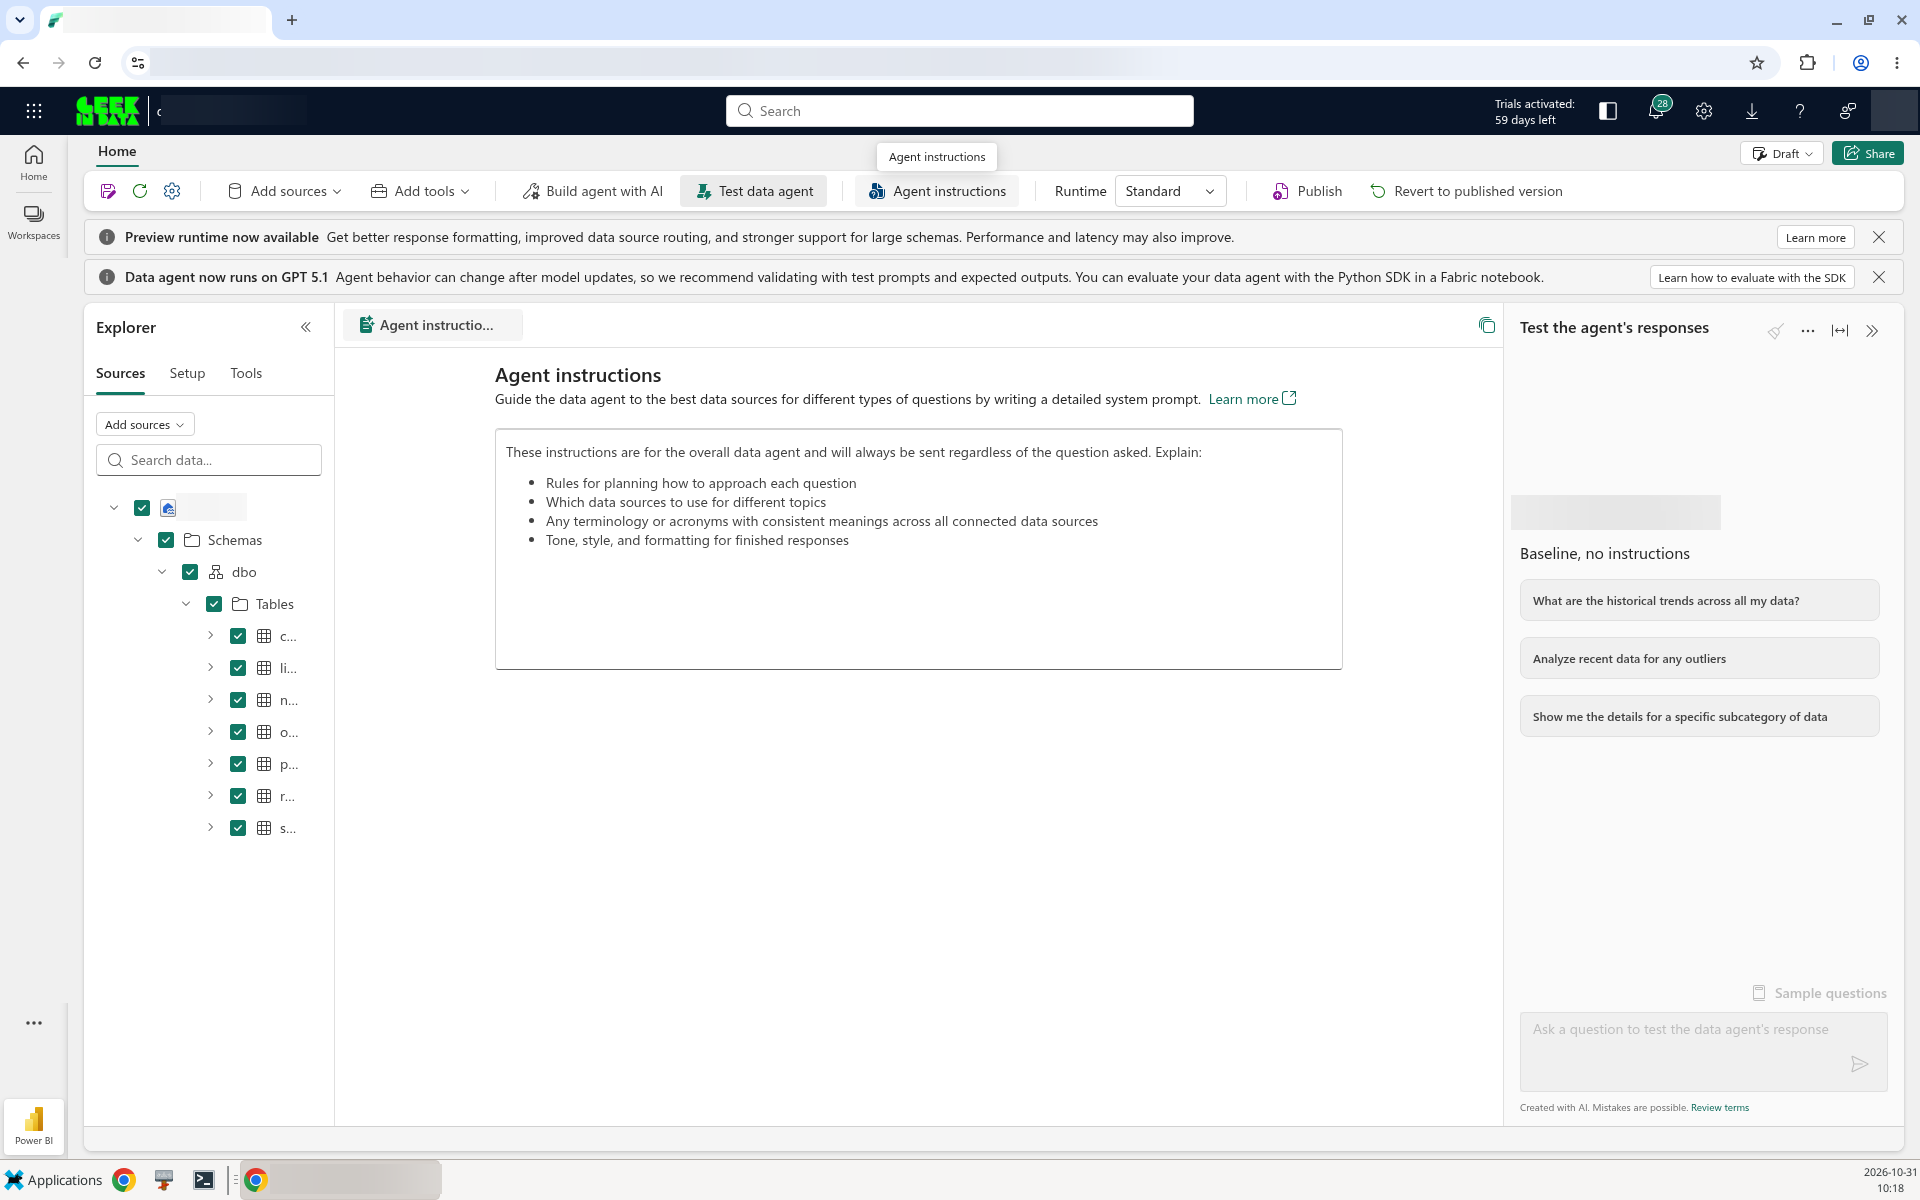
Figura 2. La configuración de la línea base: las siete tablas seleccionadas y el cuadro de instrucciones todavía vacío, así que todas las respuestas de abajo vienen del agente sin instrucciones. Capturada en mi capacidad de prueba después de la ejecución. La configuración no ha cambiado desde que publiqué el agente. Los nombres de las tablas se cortan por lo estrecho del panel.
El conjunto de preguntas. Veinte preguntas: recuentos y sumas sobre una tabla, joins de dos a cinco tablas, filtros de fecha, un top N, el mes con más pedidos y dos preguntas sembradas a propósito para que fueran ambiguas.
Cómo están redactadas las preguntas. Esto importa para todos los números de abajo. Dieciocho de las veinte usan el vocabulario del propio esquema. Cuatro de ellas escriben la fórmula de ingresos ("extended price times one minus discount"), cinco usan valores literales de columnas, como un modo de envío, una marca de devolución o una prioridad de pedido, y cinco dicen cómo redondear. Solo las dos preguntas ambiguas están formuladas como las haría un usuario de negocio. Eso hace que las 18 sean más fáciles que las preguntas reales, y en parte de eso se trata: un porcentaje de aciertos alto con preguntas así dice más de la redacción que del agente.
Las cifras principales.
| Medida | Resultado |
|---|---|
| Correctas | 19 de 20 |
| Otra lectura razonable | 1 (la pregunta del "cliente más grande") |
| Incorrectas | 0 |
| SQL generado capturado | 20 de 20 |
| Latencia, mediana | 7.6 s |
| Latencia, p90 | 11.4 s |
| Latencia, la más rápida y la más lenta | 5.3 s y 15.7 s |
| Tiempo de capacidad de toda la ejecución | unos 7 minutos |
Medido en mi capacidad F2 el 30 de octubre de 2026, una ejecución por pregunta.
La llamada más lenta, de 15.7 s, fue la primera petición después de publicar. Empezó 22 segundos después de volver a publicar el agente y no tenía nada en la caché de prompts, así que tómala como una primera petición tras publicar, no como un arranque en frío en general. Sin ella, la mediana es de 7.55 s y el p90 de 10.8 s. Con una ejecución por pregunta no se puede saber si pasa siempre.
Diseño
1. Las respuestas de referencia vienen de fuera del agente
El conjunto de referencia es toda la prueba, así que no puede compartir ruta de código con lo que se está probando. Escribí una sentencia SQL por pregunta y la ejecuté con DuckDB sobre los mismos archivos Delta. Si el agente y la referencia no coinciden, quieres que la discrepancia diga algo del agente, no de dos copias del mismo error.
Dos detalles de la puntuación importan más de lo que parece:
- Redondeo. Un total de ingresos llegó como 8,683,700,250.8999 frente a una referencia de 8,683,700,250.90. El mismo número con otra precisión. Una comparación estricta de cadenas lo daría por malo, así que mi evaluador compara números con una pequeña tolerancia, y esta la dio por buena él solo.
- Formato. La respuesta a "el mes con más pedidos" decía julio con 20,773 pedidos. Mi evaluador buscaba el mes como número, así que marcó la respuesta como parcial. Una revisión humana la marcó como correcta.
La segunda es la razón por la que cada respuesta parcial y cada respuesta incorrecta pasa por una revisión humana antes de contar. El evaluador se equivocó por el lado estricto, que es la dirección segura, pero se equivocó igualmente.
2. Siembra ambigüedad y apunta antes todas las lecturas
Dos preguntas eran ambiguas a propósito:
- "What were our total sales in 1995?" Apunté cinco lecturas defendibles: neto de descuento por fecha de pedido (mi referencia), neto de descuento por fecha de envío, bruto por fecha de pedido, bruto por fecha de envío y neto con impuestos por fecha de pedido. Con estos datos, las cinco van de 35.15 mil millones a 37.01 mil millones, con una diferencia de un 5 por ciento. Todas son un número de aspecto plausible sin ningún mensaje de error.
- "Who is our biggest customer?" puede significar más ingresos netos, más ingresos brutos, más pedidos o el saldo de cuenta más alto. Los ingresos netos y brutos dan el mismo cliente. Más pedidos y el saldo de cuenta más alto dan cada uno un cliente distinto.
Escribí todas esas lecturas, con sus cifras, en la prueba antes de ejecutarla. Ese es el paso que la gente se salta, y es el paso que convierte "la respuesta parecía bien" en una puntuación.
En la pregunta de ventas, el agente eligió neto de descuento por fecha de pedido, que coincidía con mi lectura de referencia. La conté como correcta, pero hay que ser honesto con lo que significa: coincidió con mi convención. Un equipo de finanzas que registra las ventas por fecha de envío habría recibido un número incorrecto para ellos, y la respuesta no decía qué definición había usado.
En la pregunta del cliente, el agente eligió el saldo de cuenta más alto. La respuesta sí decía "by account balance", que es mejor que nada, pero no preguntó. La conté como parcial: otra lectura razonable, y una que yo había apuntado, pero no la que el negocio quería decir con más probabilidad.
3. Lee la reformulación y el SQL, no solo la respuesta
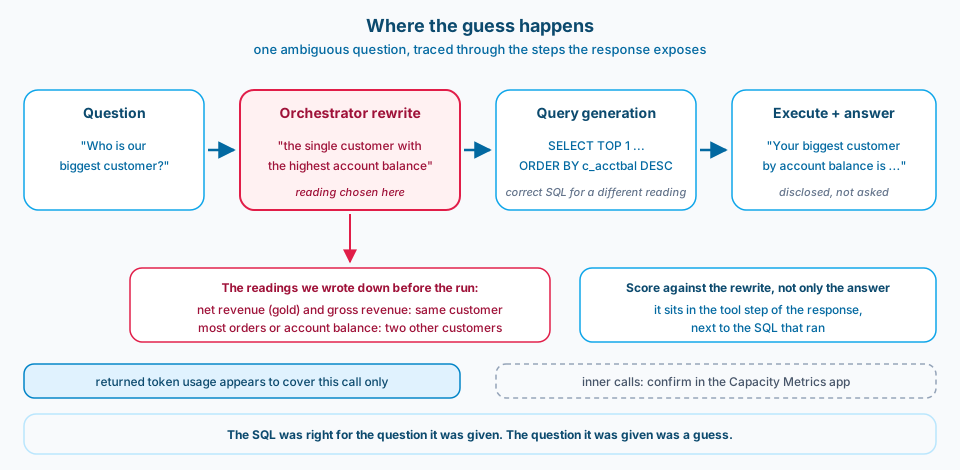
Figura 3. El SQL era correcto para la pregunta que recibió. La suposición se produjo un paso antes, en la reformulación.
Cuando llamas a un data agent publicado desde código, la respuesta incluye sus pasos de herramientas: la reformulación de tu pregunta en lenguaje natural, el SQL que generó y el resultado que ejecutó. En la pregunta del cliente, la reformulación ya decía "the single customer with the highest account balance". El paso de SQL hizo después exactamente lo que se le pidió. Si solo puntúas la respuesta final, ves un cliente equivocado. Si lees la reformulación, ves dónde se tomó la decisión, y eso te dice dónde corregirla: con una instrucción que defina "cliente más grande" o con una consulta de ejemplo que lo muestre.
Leer el SQL también saca a la luz cosas que hoy están bien y mañana son frágiles:
- Una consulta de los principales clientes agrupaba por el nombre del cliente en lugar de por la clave del cliente. En esta muestra todos los nombres son únicos, así que el resultado era exacto. Con datos reales y dos clientes con el mismo nombre, los fusionaría en silencio.
- Un filtro de trimestre usaba BETWEEN '1994-01-01' AND '1994-03-31'. Sobre una columna de fecha es correcto. Sobre una columna datetime se perdería la mayor parte del último día.
Ninguna de las dos cuesta un punto en el porcentaje de aciertos. Las dos merecen una instrucción o una consulta de ejemplo antes de que lleguen los usuarios reales.
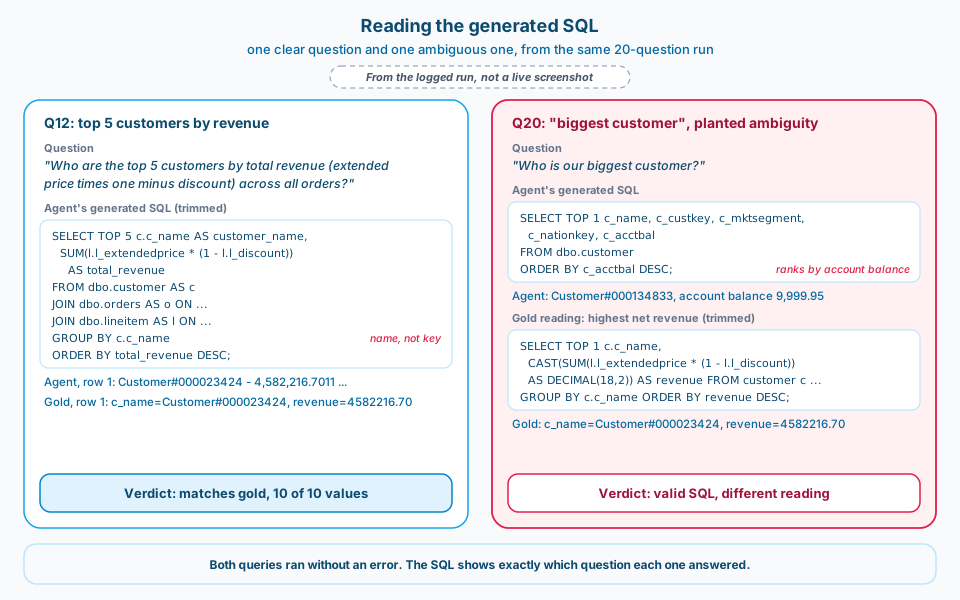
Figura 4. Construida a partir de la ejecución registrada, no es una captura en directo. Las dos consultas se ejecutaron sin errores. El SQL muestra exactamente qué pregunta respondió cada una: Q20 ordenó por saldo de cuenta y Q12 agrupó por nombre, algo exacto hoy y frágil mañana.
En las entradas de las herramientas apareció algo más. En ocho de las nueve preguntas con varias tablas, la traza muestra que el agente le pasa a su paso de SQL una lista de claves de join con la etiqueta "Verified ontology join path". Yo no había escrito ninguna instrucción. En la novena, esa lista estaba vacía y el SQL hizo el join de las tablas de todos modos. Este agente no tenía ninguna ontología asociada y la documentación de Microsoft no describe este paso, así que me limito a contar lo que muestra la traza. Si vuelvo a ejecutar el conjunto después de la actualización de noviembre, comprobaré si sigue ahí. Solo lo ves si lees los pasos.
4. Trata el uso de tokens devuelto como una estimación
La respuesta también devuelve el uso de tokens. Por petición mostraba unos 5,800 tokens de entrada, de los que 5,632 estaban en caché en 18 de las 20 llamadas, y entre 13 y 137 tokens de salida. La página Fabric operations recoge el uso de los data agents como la operación AI query y enlaza sus tarifas a la página Copilot consumption: 100 CU segundos por cada 1,000 tokens de entrada, 10 por cada 1,000 tokens de entrada en caché y 400 por cada 1,000 tokens de salida. Aplicado a los recuentos de tokens de la propia API, el coste de IA sale en unos 2,900 CU segundos para las 20 preguntas, unos 145 por pregunta. Probablemente es un mínimo. La cifra de Capacity Metrics llegará en una actualización el 1 de noviembre o después, porque la app va con retraso, y no doy una cifra en moneda hasta entonces.
Dos advertencias antes de que alguien copie esa cifra:
- La caché la mueve de cuatro a ocho veces. Las dos llamadas sin tokens en caché costaron unos 580 CU segundos cada una. Las que tenían caché costaron entre 75 y 140. Una de las llamadas sin caché fue la primera petición. La otra fue la quinta de 20, al principio de la ejecución, así que la caché es probable, no está garantizada.
- Probablemente no es la factura completa. Cada respuesta lleva un único objeto de uso, mientras que el paso que escribe el SQL muestra su propia generación sin recuentos de tokens, así que el uso devuelto parece cubrir solo la llamada del orquestador. El SQL que ejecuta el agente se factura aparte, como SQL Endpoint Query. En la Capacity Metrics app, el propio agente aparece como AI query bajo el tipo de elemento LlmPlugin, como operación en segundo plano, y esa es la cifra que hay que dar. Hasta que la tengas, llama a la cifra de tokens una estimación, probablemente un mínimo.
5. Repite después de cada cambio
Una línea base solo sirve como el "antes" de una comparación. Guarda el conjunto de preguntas, las respuestas de referencia y las lecturas en control de versiones, y vuelve a ejecutarlos después de cualquier cambio en las instrucciones, las consultas de ejemplo, las tablas seleccionadas, el modelo o el runtime.
Lo último no es hipotético. Un post del blog de Fabric del 19 de octubre de 2026 anunció la disponibilidad general de advanced NL2SQL y advanced DAX generation y dijo que las mejoras principales llegan al runtime estándar a partir del 2 de noviembre, con la previsión de terminar el 10 de noviembre y sin necesidad de activarlas. El runtime estándar también pasa a GPT-5.6 Terra. En la parte de SQL, la lista de lo que cambia menciona un mejor seguimiento de las consultas de ejemplo, la sustitución de valores de filtro y la exploración de datos. Hacer preguntas aclaratorias no está en esa lista: es uno de los modos de advanced NL2SQL, y la documentación lo sitúa en el runtime en preview. La página de Learn sobre fuentes SQL sigue mostrando hoy advanced NL2SQL como herramienta en preview del runtime en preview, mientras que el post del blog lo da por disponible de forma general, así que comprueba las dos antes de fiarte de cualquiera. No espero que el despliegue por sí solo arregle la pregunta del cliente. Hay prevista una nueva ejecución después del despliegue, pero aún sin fecha, y con una ejecución por pregunta podría mostrar un cambio, pero no demostrarlo. El mismo post recomienda volver a ejecutar un conjunto de ground truth y compararlo con tu línea base anterior, que es justo para lo que sirve este conjunto.
Para ejecuciones repetidas a escala, la vía del SDK documentada por Microsoft (en preview) es evaluate_data_agent, del paquete fabric-data-agent-sdk. Recibe pares de pregunta y respuesta esperada, necesita una F2 de pago o superior (o P1) y puntúa cada respuesta con un prompt de evaluación con LLM que puedes sustituir por el tuyo. Eso hace que el juez también sea un modelo, así que revisa a mano sus parciales y sus fallos del mismo modo. Un harness hecho a mano como el mío vale para 20 preguntas. No escala a los pocos cientos que necesita un dominio real.
Errores comunes
Probar solo preguntas que ya sabes que son claras. Un esquema limpio con buenos nombres de columna aprueba las preguntas fáciles sin ninguna instrucción. Eso demuestra que el esquema está limpio, no que el agente esté listo.
Usar el agente, o su SQL endpoint, para construir el conjunto de referencia. Así un error compartido parece un acuerdo. Calcula las respuestas esperadas por otra vía.
Puntuar solo la respuesta final. La respuesta te dice que algo ha ido mal. La reformulación y el SQL te dicen dónde y, por tanto, qué cambiar.
Contar como aprobada una pregunta ambigua que coincidió sin decirlo. Si la lectura del agente coincidió con la tuya, coincidió con tu convención. Apunta qué lectura eligió, para que una ejecución posterior que elija otra aparezca como un cambio.
Ejecutar una vez y llamarlo línea base. Una ejecución por pregunta no dice nada de la varianza. Planifica al menos tres ejecuciones por pregunta antes de comparar un antes y un después. Aquí hice una, y no compararía runtimes con ella.
Dar el CU de los tokens como coste. Probablemente deja fuera las llamadas internas y seguro que deja fuera el motor de consultas. Usa la Capacity Metrics app.
Úsalo tal cual o adáptalo
Úsalo tal cual:
- Los cuatro pasos: referencia desde fuera del agente, ambigüedad sembrada con las lecturas apuntadas, puntuar la reformulación y el SQL, y repetir después de cada cambio.
- Una conversación nueva por pregunta, para que las respuestas no puedan apoyarse unas en otras.
- Una revisión humana de cada parcial y de cada fallo antes de que cuente.
- Guardar la pregunta reformulada y el SQL junto a cada respuesta, para poder comparar dos ejecuciones.
Adáptalo antes de usarlo:
- Conjunto de preguntas. Veinte son un smoke test. Usa las preguntas que hacen de verdad tus usuarios y amplía el conjunto cada vez que una pregunta real te sorprenda.
- Ambigüedad. Siembra las ambigüedades que tiene de verdad tu negocio: año fiscal o natural, registrado o enviado, bruto o neto, qué jerarquía de clientes. Los datos de ejemplo no te dirán cuáles importan.
- Ejecuciones. Ejecuta cada pregunta varias veces con la misma configuración antes de comparar configuraciones.
- Coste. Sustituye la estimación de tokens por la cifra de la Capacity Metrics app para la misma ventana.
- Escala. Pasa del harness hecho a mano a evaluate_data_agent cuando el conjunto supere unas cuantas docenas de preguntas.
Pruébalo tú
La demo de la línea base del data agent de mi repo público tech-demos tiene las 20 preguntas, las respuestas de referencia y todas las lecturas alternativas, el evaluador y los resultados con el SQL generado, para que ejecutes la misma línea base contra tu propio agente y compares después de la actualización de noviembre.
Relacionado
- Siguiente en la serie de la prueba: Motores de Fabric con 1B filas: elige por forma de consulta (el mismo esquema derivado de TPC-H con mil millones de filas, cronometrado en cuatro motores)
- Fabric IQ: ¿está listo tu modelo semántico? (el trabajo de modelado que decide cuántas de estas preguntas puede responder un agente)
- Evaluaciones de agentes: ¿puede una puntuación bloquear un release? (convertir una línea base como esta en una puerta que puede parar un release)
- Preparación de data agents: ¿Genie (y los agentes de Fabric) es en realidad un problema de modelado? (la misma lección en otra plataforma: el agente solo es tan claro como el modelo de datos que tiene debajo)
Si solo cambias un hábito, que sea este: apunta todas las lecturas de tus preguntas ambiguas antes de ejecutarlas. Una línea base sin eso es un porcentaje de aciertos, y un porcentaje de aciertos con preguntas claras dice muy poco.