

Das Wichtigste in Kürze
- Ein Fabric Data Agent ohne Anweisungen und ohne Beispielabfragen hat auf einem sauberen synthetischen Schema 19 von 20 Fragen richtig beantwortet und eine mit einer anderen, vertretbaren Lesart. Genau das ist das Problem: Es sieht fertig aus.
- Der eine Fehler war kein schlechtes SQL. Der Agent hat in seiner eigenen Umformulierung der Frage eine Lesart von "größter Kunde" gewählt und dann korrektes SQL für diese Lesart geschrieben.
- Bewerte die umformulierte Frage und das erzeugte SQL, nicht nur den Antworttext. Beides steht in der Antwort, wenn du den Agent aus Code aufrufst.
- Berechne die Referenzantworten außerhalb des Agents auf demselben Datenstand und schreib jede Lesart jeder mehrdeutigen Frage auf, bevor du den Test startest.
- Die Token-Nutzung in der Antwort ergibt eine Schätzung, die wahrscheinlich eine Untergrenze ist, nicht die Rechnung. Prüf sie in der Capacity Metrics app, bevor du eine Zahl nennst.
- Führ denselben Satz nach jeder Änderung an Runtime, Modell, Anweisungen oder Beispielen erneut aus. Der nächste Runtime-Rollout beginnt am 2. November.
Stell dir ein Team vor, das an einem Freitag einen Data Agent mit einem Lakehouse verbindet, ihm zehn Fragen stellt, deren Antworten es schon kennt, und zehn richtige bekommt. Am Montag gibt es ihn an den Fachbereich weiter. Am Dienstag fragt jemand "Wer ist unser größter Kunde?", bekommt einen selbstsicheren, sauber formatierten Namen und packt ihn auf eine Folie. Niemand hat gefragt, welches "größter" gemeint war, und niemand würde bemerken, dass auch der Agent nie nachgefragt hat.
Ich wollte wissen, was eine Baseline vor jedem Tuning tatsächlich auffängt, also habe ich eine durchgeführt. Dieser Beitrag beschreibt die Methode, die Zahlen und das, was ich ändern würde, bevor ich dem Ergebnis vertraue.
Benanntes Modell: Referenz → platzieren → lesen → wiederholen
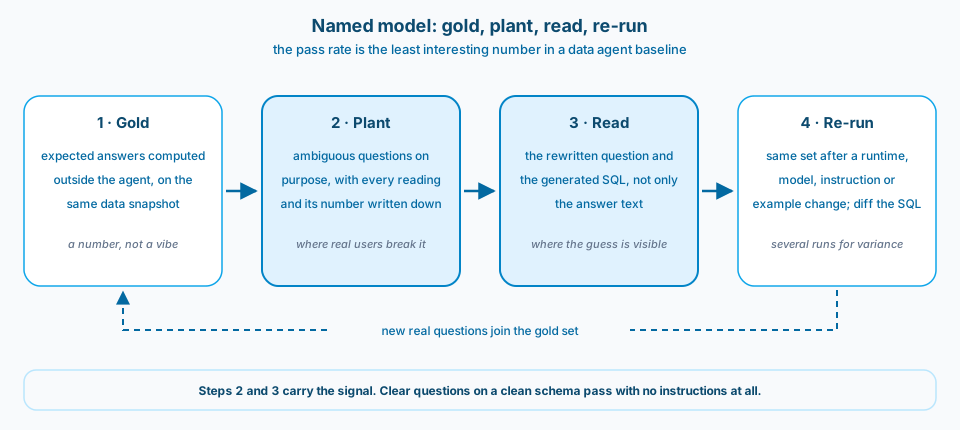
Abbildung 1. Die Erfolgsquote ist das uninteressanteste Ergebnis. In Schritt 2 und 3 verdient sich eine Baseline ihren Wert.
Kontext und Rahmenbedingung
Was das ist und was nicht. Das ist ein eigener Test auf synthetischen Daten: ein von TPC-H abgeleitetes Schema mit ungefähr Skalierungsfaktor 1, erzeugt mit einem Spark-Generator mit festem Seed statt mit dem offiziellen Tool dbgen und als sieben Delta-Tabellen in ein Lakehouse geladen. Es sind keine offiziellen TPC-H-Daten, und nichts hier ist ein geprüftes TPC-Ergebnis. Es ist ein Lauf pro Frage, auf der kleinsten bezahlten Kapazität, mit englischen Fragen gegen ein einfaches, gut benanntes Schema. Es ist keine Aussage zur Genauigkeit in Produktion, und 20 Fragen sind ein Smoke Test, kein Benchmark. Lies jede Zahl unten als "was ein sorgfältiger Nachmittag zeigt", nicht als "was ein Data Agent erreicht".
Das Setup. Ein Lakehouse, ein Data Agent, alle sieben Tabellen ausgewählt, keine Agent-Anweisungen, keine Anweisungen zur Datenquelle, keine Beispielabfragen, veröffentlicht. Die API-Antworten meldeten das Modell gpt-5.1. Der Agent lief auf der Standard-Runtime (nach dem Lauf aus den Agent-Einstellungen gelesen): Der Schalter für die Preview-Runtime ist nicht gesetzt. Ich habe den veröffentlichten Agent aus einem Python-Skript mit dem Python SDK für Fabric Data Agents aufgerufen, mit einer neuen Konversation pro Frage, damit sich keine Antwort auf eine vorherige stützen konnte. Jede Frage bekam eine Referenzantwort, berechnet mit DuckDB auf demselben Delta-Snapshot, nicht mit dem Agent und nicht mit dem SQL endpoint, den der Agent verwendet.
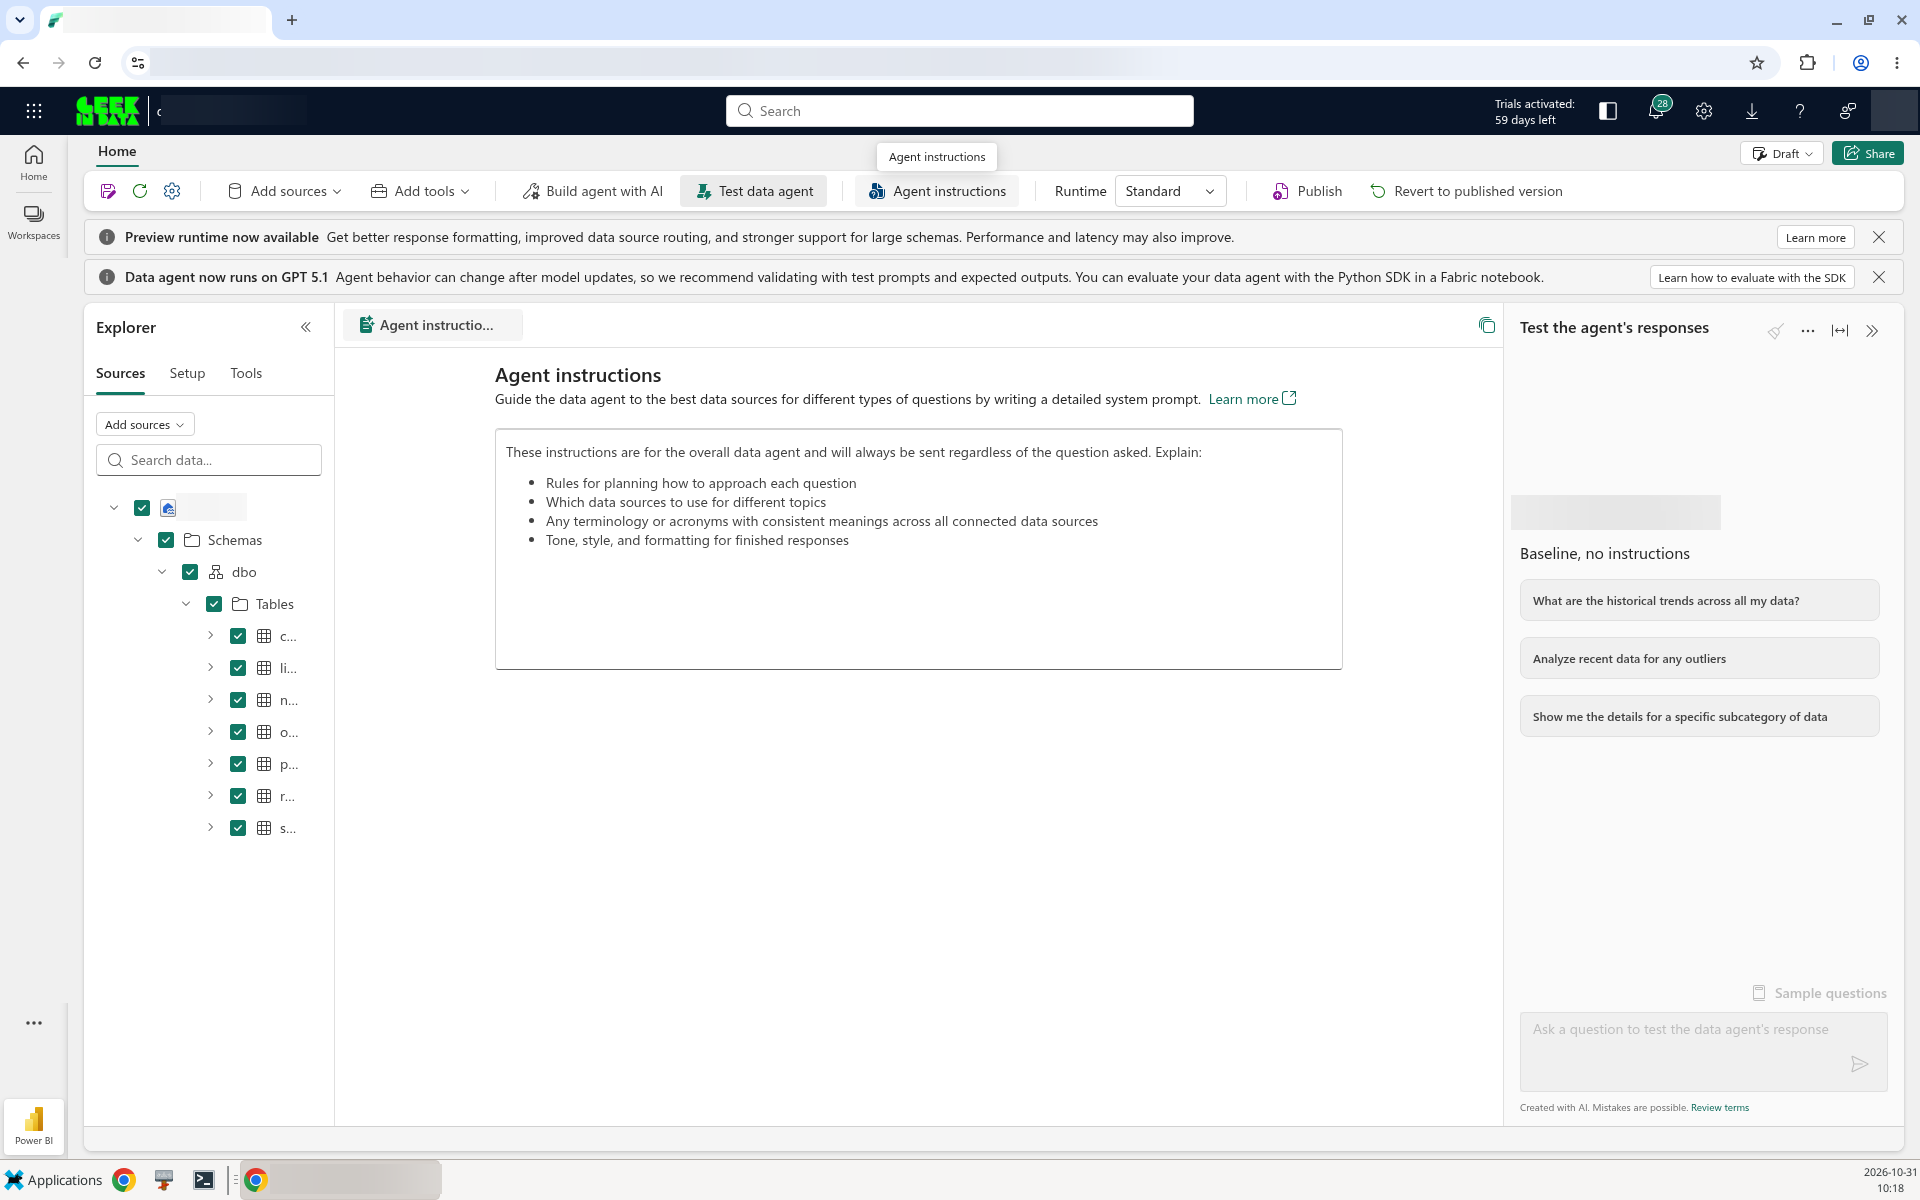
Abbildung 2. Das Baseline-Setup: alle sieben Tabellen ausgewählt und das Feld für Anweisungen noch leer, jede Antwort unten kommt also vom Agent ohne Anweisungen. Nach dem Lauf auf meiner Trial-Kapazität aufgenommen. Das Setup hat sich seit der Veröffentlichung des Agents nicht geändert. Die Tabellennamen sind wegen des schmalen Bereichs abgeschnitten.
Der Fragensatz. Zwanzig Fragen: Zählungen und Summen über eine Tabelle, Joins über zwei bis fünf Tabellen, Datumsfilter, ein Top N, ein Monat mit den meisten Bestellungen und zwei Fragen, die absichtlich mehrdeutig platziert wurden.
Wie die Fragen formuliert sind. Das ist für jede Zahl unten wichtig. Achtzehn der zwanzig verwenden das Vokabular des Schemas selbst. Vier davon schreiben die Umsatzformel aus ("extended price times one minus discount"), fünf verwenden wörtliche Spaltenwerte wie eine Versandart, ein Rückgabekennzeichen oder eine Bestellpriorität, und fünf sagen, wie gerundet werden soll. Nur die zwei mehrdeutigen Fragen sind so formuliert, wie ein Fachanwender fragen würde. Damit sind die 18 leichter als echte Fragen, und genau darum geht es zum Teil: Eine hohe Erfolgsquote bei solchen Fragen sagt mehr über die Formulierung als über den Agent.
Die wichtigsten Zahlen.
| Messgröße | Ergebnis |
|---|---|
| Richtig | 19 von 20 |
| Andere vertretbare Lesart | 1 (die Frage nach dem "größten Kunden") |
| Falsch | 0 |
| Erzeugtes SQL erfasst | 20 von 20 |
| Latenz, Median | 7.6 s |
| Latenz, p90 | 11.4 s |
| Latenz, schnellster und langsamster Aufruf | 5.3 s und 15.7 s |
| Kapazitätszeit für den ganzen Lauf | etwa 7 Minuten |
Gemessen auf meiner F2-Kapazität am 30. Oktober 2026, ein Lauf pro Frage.
Der langsamste Aufruf mit 15.7 s war die erste Anfrage nach dem Veröffentlichen. Er startete 22 Sekunden, nachdem ich den Agent neu veröffentlicht hatte, und hatte nichts im Prompt-Cache. Lies ihn also als erste Anfrage nach dem Veröffentlichen, nicht als allgemeinen Kaltstart. Ohne ihn liegt der Median bei 7.55 s und das p90 bei 10.8 s. Ein Lauf pro Frage kann nicht zeigen, ob das jedes Mal passiert.
Design
1. Referenzantworten kommen von außerhalb des Agents
Der Referenzsatz ist der ganze Test, also darf er keinen Codepfad mit dem teilen, was getestet wird. Ich habe pro Frage eine SQL-Anweisung geschrieben und sie mit DuckDB auf denselben Delta-Dateien ausgeführt. Wenn Agent und Referenz sich widersprechen, soll der Widerspruch etwas über den Agent aussagen, nicht über zwei Kopien desselben Fehlers.
Zwei Details der Bewertung sind wichtiger, als sie aussehen:
- Rundung. Eine Umsatzsumme kam als 8,683,700,250.8999 zurück, die Referenz war 8,683,700,250.90. Dieselbe Zahl, andere Genauigkeit. Ein strenger String-Vergleich nennt das falsch, deshalb vergleicht mein Bewerter Zahlen mit einer kleinen Toleranz, und er hat diese Antwort selbstständig als richtig gewertet.
- Formatierung. Die Antwort auf "Monat mit den meisten Bestellungen" nannte Juli mit 20,773 Bestellungen. Mein Bewerter suchte den Monat als Zahl und markierte die Antwort deshalb als teilweise richtig. Beim Lesen durch einen Menschen war sie richtig.
Das zweite Beispiel ist der Grund, warum jede teilweise richtige und jede falsche Antwort von einem Menschen gelesen wird, bevor sie zählt. Der Bewerter hat sich auf der strengen Seite geirrt, was die sichere Richtung ist, aber geirrt hat er sich trotzdem.
2. Mehrdeutigkeit platzieren und jede Lesart vorher aufschreiben
Zwei Fragen waren absichtlich mehrdeutig:
- "What were our total sales in 1995?" Ich habe fünf vertretbare Lesarten aufgeschrieben: netto nach Rabatt nach Bestelldatum (meine Referenz), netto nach Rabatt nach Versanddatum, brutto nach Bestelldatum, brutto nach Versanddatum und netto inklusive Steuer nach Bestelldatum. Auf diesen Daten reichen die fünf von 35.15 Milliarden bis 37.01 Milliarden, etwa 5 Prozent auseinander. Jede davon ist eine plausibel aussehende Zahl ohne Fehlermeldung.
- "Who is our biggest customer?" kann den höchsten Nettoumsatz, den höchsten Bruttoumsatz, die meisten Bestellungen oder den höchsten Kontostand bedeuten. Netto- und Bruttoumsatz nennen denselben Kunden. Die meisten Bestellungen und der höchste Kontostand nennen jeweils einen anderen.
Ich habe alle diese Lesarten mit ihren Zahlen vor dem Lauf in den Test geschrieben. Diesen Schritt lassen Leute aus, und genau dieser Schritt macht aus "die Antwort sah gut aus" eine Bewertung.
Bei der Umsatzfrage wählte der Agent netto nach Rabatt nach Bestelldatum, was meiner Referenzlesart entsprach. Ich habe das als richtig gezählt, aber sei ehrlich, was das heißt: Es entsprach meiner Konvention. Ein Finanzteam, das Umsatz nach Versanddatum bucht, hätte eine Zahl bekommen, die für es falsch ist, und die Antwort sagte nicht, welche Definition sie verwendet hat.
Bei der Kundenfrage wählte der Agent den höchsten Kontostand. Die Antwort sagte zwar "by account balance", was besser ist als nichts, aber sie hat nicht nachgefragt. Ich habe sie als teilweise richtig gezählt: eine andere vertretbare Lesart, die ich aufgeschrieben hatte, aber nicht die, die der Fachbereich am wahrscheinlichsten meinte.
3. Umformulierung und SQL lesen, nicht nur die Antwort
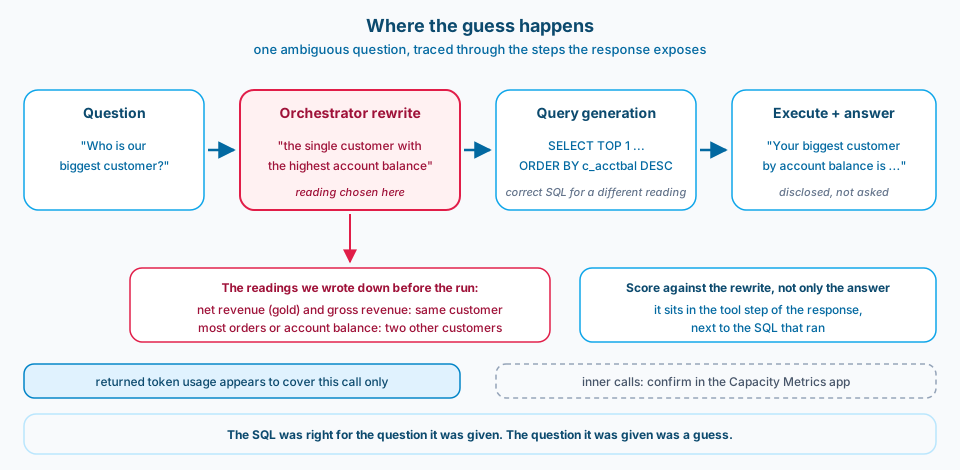
Abbildung 3. Das SQL war für die Frage, die es bekam, korrekt. Die Annahme passierte einen Schritt früher, bei der Umformulierung.
Wenn du einen veröffentlichten Data Agent aus Code aufrufst, enthält die Antwort seine Tool-Schritte: die Umformulierung deiner Frage in natürlicher Sprache, das erzeugte SQL und das Ergebnis, das ausgeführt wurde. Bei der Kundenfrage sagte die Umformulierung bereits "the single customer with the highest account balance". Der SQL-Schritt hat dann genau das getan, was ihm gesagt wurde. Wenn du nur die finale Antwort bewertest, siehst du einen falschen Kunden. Wenn du die Umformulierung liest, siehst du, wo die Entscheidung gefallen ist, und damit, wo du sie korrigierst: mit einer Anweisung, die "größter Kunde" definiert, oder mit einer Beispielabfrage, die es zeigt.
Das SQL zu lesen, bringt auch Dinge ans Licht, die heute richtig und morgen fragil sind:
- Eine Abfrage nach den Top-Kunden gruppierte nach Kundenname statt nach Kundenschlüssel. In dieser Stichprobe ist jeder Name eindeutig, das Ergebnis war also exakt. Auf echten Daten mit zwei gleichnamigen Kunden würde sie die beiden still zusammenlegen.
- Ein Quartalsfilter verwendete BETWEEN '1994-01-01' AND '1994-03-31'. Auf einer Datumsspalte ist das korrekt. Auf einer Datetime-Spalte würde es den Großteil des letzten Tages verlieren.
Keines von beiden kostet einen Punkt in der Erfolgsquote. Beide sind eine Anweisung oder eine Beispielabfrage wert, bevor echte Nutzer kommen.
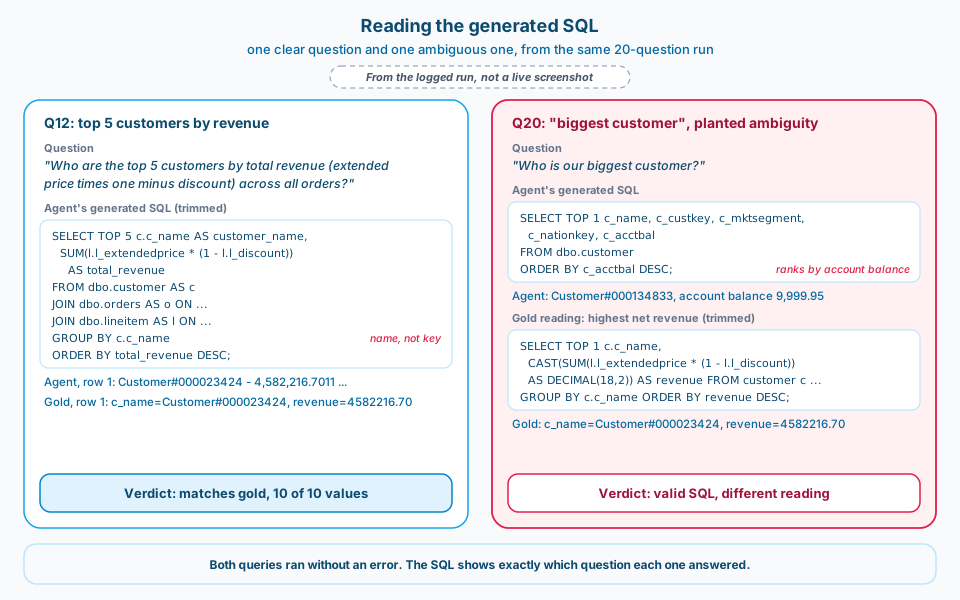
Abbildung 4. Aus dem protokollierten Lauf erstellt, kein Live-Screenshot. Beide Abfragen liefen ohne Fehler. Das SQL zeigt genau, welche Frage jede beantwortet hat: Q20 sortierte nach Kontostand, und Q12 gruppierte nach Name, was heute exakt und morgen fragil ist.
In den Tool-Eingaben zeigte sich noch etwas. Bei acht der neun Fragen über mehrere Tabellen zeigt der Trace, dass der Agent seinem SQL-Schritt eine Liste von Join-Schlüsseln mit der Bezeichnung "Verified ontology join path" übergibt. Ich hatte keine Anweisungen geschrieben. Bei der neunten war diese Liste leer, und das SQL hat die Tabellen trotzdem gejoint. An diesen Agent war keine Ontologie angehängt, und die Microsoft-Dokumentation beschreibt diesen Schritt nicht, also berichte ich nur, was der Trace zeigt. Wenn ich den Satz nach dem November-Update erneut ausführe, prüfe ich, ob er noch da ist. Du siehst ihn nur, wenn du die Schritte liest.
4. Zurückgegebene Token-Nutzung als Schätzung behandeln
Die Antwort gibt auch die Token-Nutzung zurück. Pro Anfrage zeigte sie ungefähr 5,800 Eingabetokens, von denen bei 18 der 20 Aufrufe 5,632 aus dem Cache kamen, und zwischen 13 und 137 Ausgabetokens. Die Seite Fabric operations führt die Nutzung von Data Agents als Operation AI query und verlinkt für die Tarife auf die Seite Copilot consumption: 100 CU-Sekunden pro 1,000 Eingabetokens, 10 pro 1,000 gecachten Eingabetokens und 400 pro 1,000 Ausgabetokens. Auf die Token-Zahlen der API selbst angewendet, ergibt das für die 20 Fragen etwa 2,900 CU-Sekunden an KI-Kosten, rund 145 pro Frage. Das ist wahrscheinlich eine Untergrenze. Der Wert aus Capacity Metrics folgt in einem Update am 1. November oder später, weil die App hinterherhinkt, und bis dahin nenne ich keinen Betrag in einer Währung.
Zwei Warnungen, bevor jemand diesen Wert übernimmt:
- Caching verschiebt ihn um das Vier- bis Achtfache. Die zwei Aufrufe ohne gecachte Tokens kosteten jeweils etwa 580 CU-Sekunden. Die gecachten kosteten zwischen 75 und 140. Einer der ungecachten Aufrufe war die erste Anfrage. Der andere war der fünfte von 20, früh im Lauf. Caching ist also wahrscheinlich, nicht garantiert.
- Es ist wahrscheinlich nicht die ganze Rechnung. Jede Antwort enthält ein einziges Nutzungsobjekt, während der Schritt, der das SQL schreibt, seine eigene Generierung ohne Token-Zahlen zeigt. Die zurückgegebene Nutzung scheint also nur den Aufruf des Orchestrators abzudecken. Das SQL, das der Agent ausführt, wird separat als SQL Endpoint Query abgerechnet. In der Capacity Metrics app erscheint der Agent selbst als AI query unter dem Item-Typ LlmPlugin, als Hintergrundoperation, und das ist die Zahl, die du nennen solltest. Bis du sie hast, nenn den Token-Wert eine Schätzung und wahrscheinlich eine Untergrenze.
5. Nach jeder Änderung erneut ausführen
Eine Baseline ist nur als "vorher" in einem Vergleich nützlich. Leg Fragensatz, Referenzantworten und Lesarten in die Versionskontrolle und führ sie nach jeder Änderung an Anweisungen, Beispielabfragen, ausgewählten Tabellen, Modell oder Runtime erneut aus.
Der letzte Punkt ist nicht hypothetisch. Ein Fabric-Blogbeitrag vom 19. Oktober 2026 hat Advanced NL2SQL und Advanced DAX Generation als allgemein verfügbar angekündigt und gesagt, dass die Kernverbesserungen ab dem 2. November auf die Standard-Runtime ausgerollt werden, voraussichtlich bis zum 10. November abgeschlossen und ohne Opt-in. Die Standard-Runtime wechselt außerdem auf GPT-5.6 Terra. Auf der SQL-Seite nennt die Liste dessen, was übernommen wird, eine bessere Befolgung von Beispielabfragen, das Ersetzen von Filterwerten und die Datenerkundung. Rückfragen stehen nicht auf dieser Liste: Sie sind einer der Modi von Advanced NL2SQL, und die Dokumentation ordnet sie der Preview-Runtime zu. Die Learn-Seite zu SQL-Quellen führt Advanced NL2SQL heute noch als Preview-Tool auf der Preview-Runtime, während der Blogbeitrag es allgemein verfügbar nennt. Prüf also beides, bevor du dich auf eins verlässt. Ich erwarte nicht, dass der Rollout allein die Kundenfrage löst. Ein erneuter Lauf nach dem Rollout ist geplant, aber noch nicht terminiert, und mit einem Lauf pro Frage könnte er eine Änderung zeigen, aber nicht beweisen. Derselbe Beitrag empfiehlt, einen Ground-Truth-Satz erneut auszuführen und mit der vorherigen Baseline zu vergleichen, und genau dafür ist dieser Satz da.
Für wiederholte Läufe in größerem Umfang ist der von Microsoft dokumentierte SDK-Weg (Preview) evaluate_data_agent im Paket fabric-data-agent-sdk. Es nimmt Paare aus Frage und erwarteter Antwort, braucht ein bezahltes F2 oder höher (oder P1) und bewertet jede Antwort mit einem LLM-Bewertungsprompt, den du durch deinen eigenen ersetzen kannst. Damit ist auch der Bewerter ein Modell, also prüf seine teilweise richtigen und falschen Urteile genauso von Hand. Ein selbst gebautes Harness wie meins reicht für 20 Fragen. Für die paar Hundert, die eine echte Domäne braucht, skaliert es nicht.
Häufige Fehler
Nur Fragen testen, von denen du schon weißt, dass sie klar sind. Ein sauberes Schema mit guten Spaltennamen besteht leichte Fragen ganz ohne Anweisungen. Das beweist, dass das Schema sauber ist, nicht dass der Agent bereit ist.
Den Agent oder seinen SQL endpoint verwenden, um den Referenzsatz zu bauen. Dann sieht ein gemeinsamer Fehler wie Übereinstimmung aus. Berechne erwartete Antworten über einen anderen Weg.
Nur die finale Antwort bewerten. Die Antwort sagt dir, dass etwas schiefgelaufen ist. Umformulierung und SQL sagen dir, wo, und damit, was du ändern musst.
Eine getroffene mehrdeutige Frage als bestanden zählen, ohne es zu sagen. Wenn die Lesart des Agents deiner entsprach, entsprach sie deiner Konvention. Halte fest, welche Lesart er gewählt hat, damit ein späterer Lauf, der eine andere wählt, als Änderung auffällt.
Einmal laufen lassen und es Baseline nennen. Ein Lauf pro Frage sagt nichts über die Streuung. Plane mindestens drei Läufe pro Frage, bevor du vorher und nachher vergleichst. Ich bin hier einen gelaufen und würde darauf keine Runtimes vergleichen.
Token-CU als Kosten nennen. Dieser Wert lässt wahrscheinlich die inneren Aufrufe aus und ganz sicher die Query Engine. Nimm die Capacity Metrics app.
So übernehmen oder anpassen
So übernehmen:
- Die vier Schritte: Referenz von außerhalb des Agents, platzierte Mehrdeutigkeit mit aufgeschriebenen Lesarten, Bewertung von Umformulierung und SQL, erneuter Lauf nach jeder Änderung.
- Eine neue Konversation pro Frage, damit sich Antworten nicht aufeinander stützen können.
- Ein Mensch liest jede teilweise richtige und jede falsche Antwort, bevor sie zählt.
- Die umformulierte Frage und das SQL neben jeder Antwort festhalten, damit sich zwei Läufe vergleichen lassen.
Vor dem Einsatz anpassen:
- Fragensatz. Zwanzig sind ein Smoke Test. Nimm die Fragen, die deine Nutzer tatsächlich stellen, und erweitere den Satz jedes Mal, wenn dich eine echte Frage überrascht.
- Mehrdeutigkeit. Platziere die Mehrdeutigkeiten, die dein Geschäft wirklich hat: Geschäftsjahr oder Kalenderjahr, gebucht oder versendet, brutto oder netto, welche Kundenhierarchie. Beispieldaten sagen dir nicht, welche davon zählen.
- Läufe. Führ jede Frage mehrmals auf derselben Konfiguration aus, bevor du Konfigurationen vergleichst.
- Kosten. Ersetze die Token-Schätzung durch den Wert aus der Capacity Metrics app für dasselbe Zeitfenster.
- Umfang. Wechsle vom selbst gebauten Harness zu evaluate_data_agent, sobald der Satz über ein paar Dutzend Fragen hinausgeht.
Probier es selbst aus
Die Demo zur Data-Agent-Baseline in meinem öffentlichen Repo tech-demos enthält die 20 Fragen, die Referenzantworten und jede alternative Lesart, den Bewerter und die Ergebnisse mit dem erzeugten SQL. So kannst du dieselbe Baseline gegen deinen eigenen Agent laufen lassen und nach dem November-Update vergleichen.
Verwandte Notizen
- Als Nächstes in der Trial-Serie: Fabric Engines mit 1B Zeilen: nach Abfrageform wählen (dasselbe von TPC-H abgeleitete Schema mit einer Milliarde Zeilen, auf vier Engines gemessen)
- Fabric IQ: Ist dein semantisches Modell bereit? (die Modellierungsarbeit, die entscheidet, wie viele dieser Fragen ein Agent überhaupt beantworten kann)
- Agent Evals: Kann ein Score ein Release blockieren? (wie aus einer Baseline wie dieser ein Gate wird, das ein Release stoppen kann)
- Data Agent Readiness: Sind Genie (und Fabric Agents) wirklich ein Modellierungsproblem? (dieselbe Lektion auf einer anderen Plattform: Der Agent ist nur so klar wie das Datenmodell darunter)
Wenn du nur eine Gewohnheit änderst, dann diese: Schreib jede Lesart deiner mehrdeutigen Fragen auf, bevor du sie ausführst. Eine Baseline ohne das ist eine Erfolgsquote, und eine Erfolgsquote bei klaren Fragen sagt sehr wenig.