
Das Wichtigste in Kürze
- Antworten von Fabric IQ in Microsoft 365 Copilot Chat sind allgemein verfügbar, und die zugehörige Admin-Einstellung ist standardmäßig aktiv. Deinen veröffentlichten Modellen kann man also schon Fragen stellen.
- Bring das Modell in Ordnung, bevor du Prompts schreibst. Ein reviewtes Measure schlägt jede Anweisung.
- Das AI data schema fokussiert Copilot. Es ist keine Sicherheitsfunktion, und manche Fähigkeiten ignorieren es.
- Verified Answers werden nicht zurückgegeben, wenn Fabric IQ aktiv ist. Bau die Korrektheit in Copilot Chat nicht darauf auf.
- Knüpf die Freigabe an ein Fragenset mit geprüften erwarteten Ergebnissen.
- Prep data for AI ist in Preview, braucht aktiviertes Q&A und nach einem Deploy über Git oder Pipeline einen Refresh im Service.
Ein hypothetisches, aber wahrscheinliches Szenario. Jemand fragt Copilot Chat, wie das Geschäft im letzten Quartal gelaufen ist. Copilot findet ein Modell, das niemand dafür vorbereitet hat, nimmt den Brutto- statt den Nettowert, rechnet mit Kalenderquartalen, wo das Unternehmen in Geschäftsquartalen berichtet, und antwortet mit voller Überzeugung. Kein Refresh ist fehlgeschlagen. Kein Bericht ist kaputt. Die Antwort ist trotzdem falsch.
Modelle wurden für Berichtsautoren gebaut, die das Geschäft schon kennen. Copilot kennt es nicht. Forme das Modell, grenz ein, was Copilot sieht, steuere es mit so wenig Text wie möglich und prüfe es, bevor du es freigibst.
Benanntes Modell: formen → eingrenzen → steuern → prüfen
- Formen: explizite Measures, echte Beziehungen, eine markierte Datumstabelle, klare Namen, Beschreibungen.
- Eingrenzen: ein AI data schema für den Fokus; Sicherheit auf Zeilen- und Objektebene (RLS, OLS) für den Zugriff.
- Steuern: kurze AI Instructions; Verified Answers nur dort, wo sie tatsächlich greifen.
- Prüfen: ein Fragenset mit erwarteten Ergebnissen, dann Approved for Copilot.
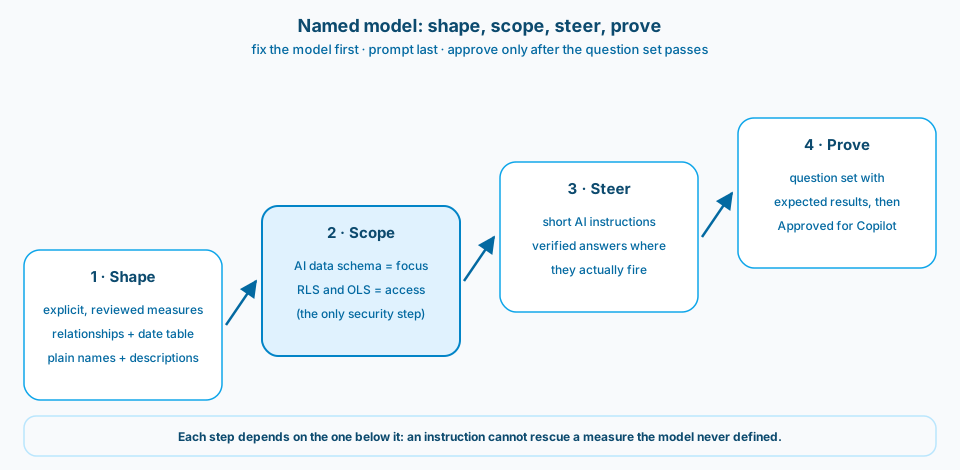
Abbildung 1. Nur der Schritt Eingrenzen trägt Sicherheit. Nur der Schritt Prüfen verdient das Freigabe-Flag.
Kontext und Rahmenbedingung
In Copilot Chat sucht Copilot nach einem passenden Bericht und antwortet aus dem darunterliegenden semantic model, mit den Berechtigungen der Nutzerin oder des Nutzers, RLS und OLS eingeschlossen. Die Antworten spiegeln den letzten erfolgreichen Refresh wider. Modelle auf Embedded-Kapazitäten (A oder EM) werden nicht unterstützt, und die Fragen müssen in einer Sprache gestellt werden, die Microsoft 365 Copilot unterstützt (Fabric IQ in Microsoft 365 Copilot Chat).
Wenn ich ein Modell mit Blick auf Copilot öffne, finde ich meist dieselben Dinge: Zahlen, die nur als implizite Spaltensummen existieren, kaum Beschreibungen, automatisch erzeugte Synonyme, die niemand kuratiert hat, und nichts, was für KI eingerichtet ist. Nichts davon blockiert einen Bericht. Alles davon verwirrt einen Chat. So würde ich ein solches Modell vorbereiten und freigeben. Beitrag 13 behandelt die Grundlagen der Modellierung; diese Notiz behandelt die Werkzeuge in Power BI und ihre Tücken.
Design
1. Das Modell formen, bevor du es promptest
Wenn Leute nach einer Zahl fragen, sollte sie als reviewtes Measure mit klarem Namen und Beschreibung existieren. Wenn Measure A netto und Measure B brutto ist und keines beschrieben ist, nimmt Copilot eines davon und sagt dir nicht, dass es geraten hat. Learn nennt kryptische Namen, fehlende Beschreibungen, gleichnamige Felder in mehreren Tabellen und nicht verbundene Tabellen wie Feldparameter als häufige Ursachen schlechter Antworten (Copilot with semantic models).
Eine Erwartung solltest du gleich richtig setzen: Beschreibungen fließen derzeit nur in DAX-Abfragen und Suchfunktionen ein (Prep data for AI FAQ). Schreib sie trotzdem, aber erwarte nicht, dass sie allein die Antworten reparieren.
2. Für den Fokus eingrenzen, mit RLS und OLS absichern
Prep data for AI ist in Preview (Prep data for AI), und die von Microsoft empfohlene Reihenfolge lautet: AI data schema, dann Verified Answers, dann AI Instructions (siehe FAQ oben). Das Schema schränkt ein, welche Felder Copilot bevorzugt. Das Beispiel in Learn entfernt ein konkurrierendes Measure, damit "Umsatz" auf das Measure auflöst, das das Team tatsächlich verwendet.
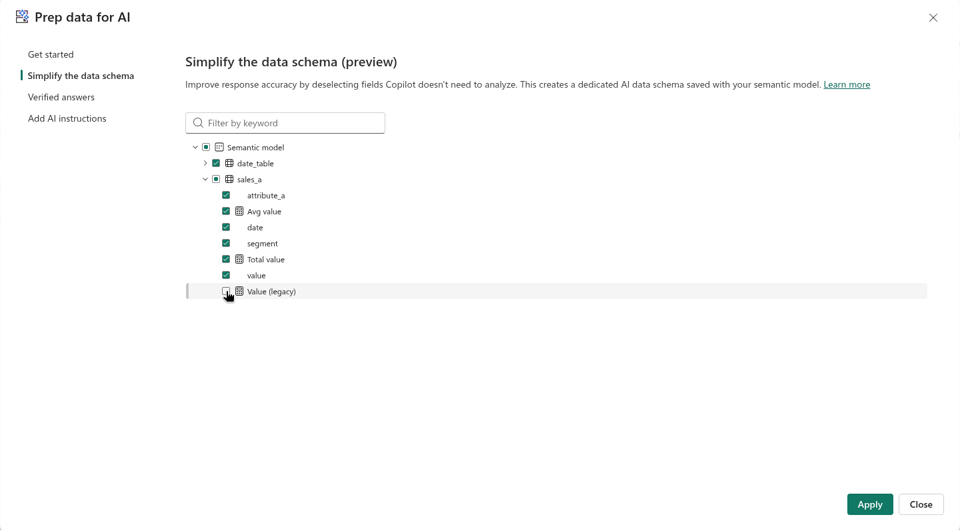
Abbildung 2. In einem kleinen Demo-Modell ist das konkurrierende Measure Value (legacy) abgewählt, damit das AI data schema Copilot auf Total value lenkt.
Die Tücke: Das Erstellen einer Berichtsseite oder das Schreiben einer DAX-Abfrage nutzt weiterhin das ganze Modell, nicht das Schema (AI data schemas). Ein Feld, das du aus dem Schema weglässt, ist vor niemandem verborgen. Wenn jemand es nicht sehen darf, ist das ein Fall für RLS oder OLS.
3. Mit kurzen Anweisungen steuern, die auf echte Objekte zeigen
AI Instructions sind auf 10,000 Zeichen begrenzt, und Learn sagt offen, dass es keine Garantie gibt, dass Copilot sie genau befolgt (AI instructions). Deshalb beschränke ich sie auf Standardwerte und Begriffsklärung, nach Themen gruppiert:
Metrics
- "Sales" without a qualifier means [Measure A] (net, after returns).
- Use [Measure B] only when the user asks for gross.

Dates
- Use the fiscal calendar on the Date table unless the user asks otherwise.

Ambiguity
- If "performance" could mean volume, value, or margin, ask which measure.
Jede Zeile nennt etwas, das das Modell bereits definiert. Eine Anweisung, die eine Berechnung beschreibt, die dem Modell fehlt, ist ein Measure, das du noch schuldig bist.
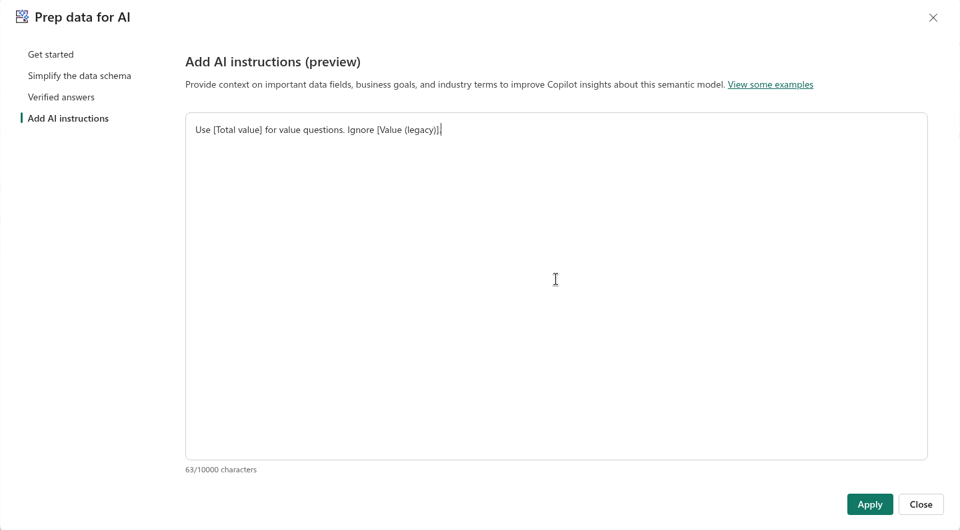
Abbildung 3. Für das Demo-Modell hat eine Zeile gereicht: das zu verwendende Measure nennen und das zu ignorierende.
4. Verified Answers dort einsetzen, wo sie greifen
Verified Answers ordnen Auslöserphrasen einem reviewten Visual zu. Die wichtigste Einschränkung steht auf derselben Learn-Seite wie die Einrichtungsschritte: Copilot gibt keine Verified Answers zurück, wenn Fabric IQ aktiviert ist (verified answers). Außerdem greifen sie nicht mehr, wenn ein verwendetes Feld ausgeblendet ist, funktionieren nicht mit Berichts-Measures, werden von Git-Integration und Deployment-Pipelines nicht mitgenommen und sind keine Sicherheitsfunktion für Daten unter RLS oder OLS.
Deshalb sehe ich sie als Werkzeug für den Copilot-Bereich im Bericht, für eine Handvoll häufig gestellter Fragen. Die Korrektheit in Copilot Chat steckt in Measures und Anweisungen.
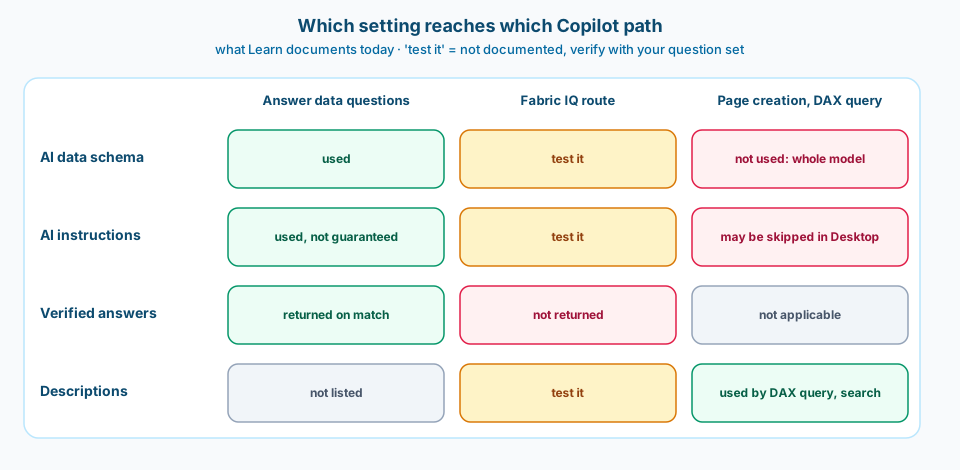
Abbildung 4. Was Learn heute dokumentiert. "Test it" markiert die Lücken, die dein Fragenset abdecken muss, und Verified Answers erreichen den Fabric-IQ-Weg nie.
5. Erst prüfen, dann freigeben
Bevor jemand das Modell als freigegeben markiert, schreib die Fragen mit der erwarteten Antwort auf, wie Learn es empfiehlt (Ask data questions with Copilot and Fabric IQ). Nimm mindestens eine bewusst mehrdeutige Frage auf, denn die richtige Antwort darauf ist eine Rückfrage.
question                       | measure   | grouping | date basis     | expected
Sales last quarter             | Measure A | none     | fiscal quarter | validated value
Top three categories by sales  | Measure A | category | fiscal year    | validated list
How is performance?            | (ask)     | none     | none           | clarifying question
Führ das Set auf den Oberflächen aus, die die Leute nutzen, lies bei jeder Antwort "How Copilot arrived at this" und markiere das Modell erst dann als Approved for Copilot. Die Freigabe entfernt den Warnhinweis, den das eigenständige Copilot bei Antworten aus nicht freigegebenen Elementen anzeigt, und zwar für das Modell und jeden Bericht darauf. Das ist ein Versprechen an die Nutzer, keine Formalität. Rechne mit bis zu einer Stunde, bis es wirkt, bei Modellen mit vielen Berichten mit bis zu einem Tag (Prep data for AI). Es ist dasselbe Gate wie in Beitrag 48, nur auf ein Modell angewendet.
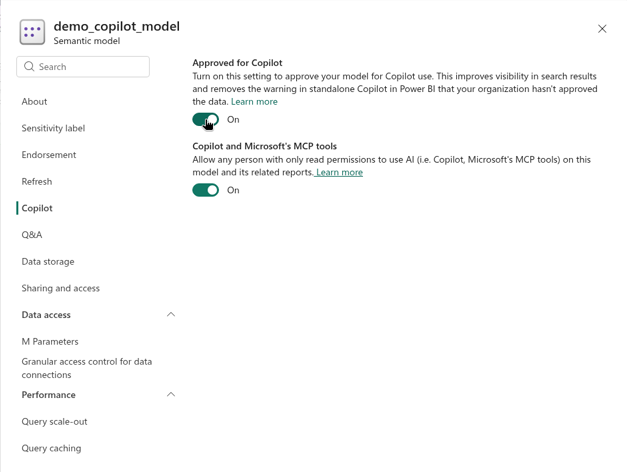
Abbildung 5. Approved for Copilot liegt in den Modelleinstellungen unter Copilot. Schalte es erst ein, wenn das Fragenset besteht.
Ich habe das an einem kleinen Demo-Modell mit 60 synthetischen Zeilen ausprobiert, nachdem ich das Legacy-Measure abgewählt und die einzeilige Anweisung ergänzt hatte. Auf die Frage "What is the total value by segment?" lieferte das eigenständige Copilot dieselben drei Werte, die meine DAX-Prüfung erwartet hatte, und "How Copilot arrived at this" zeigte, dass es segment und Total value ohne Filter verwendet hat, nicht die Legacy-Kopie.
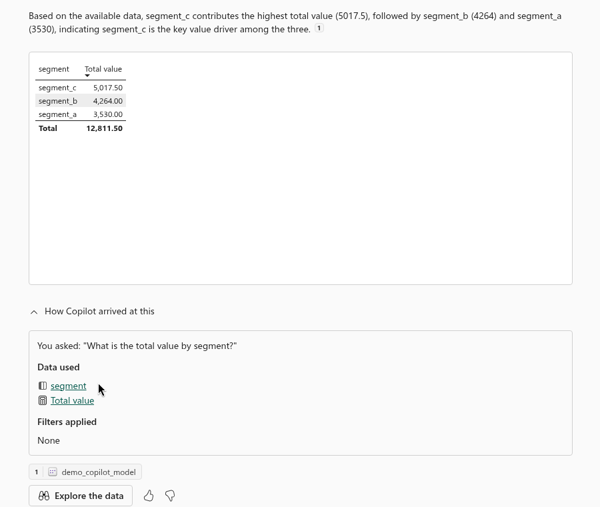
Abbildung 6. Die Antwort entsprach den erwarteten Werten, und das Begründungsfeld zeigt, welches Measure Copilot gewählt hat.
Stell Geschäftsfragen im eigenständigen Copilot. Der Copilot-Bereich im Modell-Editor ist für Hilfe bei der Modellierung da: Er hat dieselbe Frage abgelehnt und mir stattdessen angeboten, ein Measure einzurichten. Eine Nebenwirkung solltest du kennen: Als ich das Modell im Web im Bearbeitungsmodus geöffnet habe, wurde es in das Speicherformat für große semantic models konvertiert, wie das Banner in Abbildung 7 zeigt.
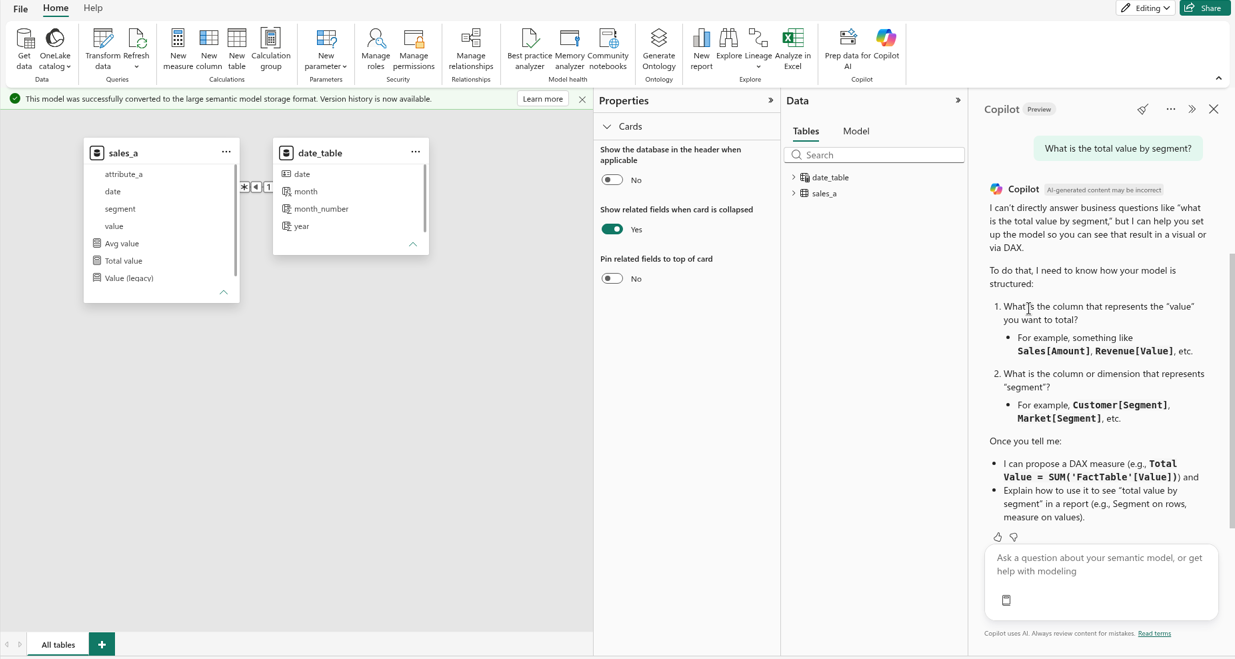
Abbildung 7. Das Copilot im Modell-Editor lehnt Geschäftsfragen ab. Beachte das Banner zum Speicherformat oben.
6. Wie eine Modelländerung ausliefern
AI Instructions und das AI data schema liegen in den linguistischen Metadaten des Modells. Nach einer Änderung über Git oder eine Deployment-Pipeline musst du das Modell laut Learn im Service aktualisieren, damit es synchronisiert wird, und für Modelle im Modus DirectQuery oder Direct Lake heißt es zusätzlich "but only once a day". Power BI Desktop bearbeitet Prep data for AI nur bei Import-, DirectQuery- und lokalen zusammengesetzten Modellen, Modelle im Modus Direct Lake werden also im Service vorbereitet (gleiche Seite). Ein Git-Deploy ist nicht das Ende des Release: Plane den Refresh und führ danach das Fragenset aus.
Zwei Punkte für die Checkliste. Prep data for AI setzt Q&A am Modell voraus, während Q&A-Funktionen im Februar 2027 eingestellt werden (Q&A best practices): Entferne Q&A-Visuals, behalte die Einstellung. Und wenn Modellnamen oder Synonyme nicht auf Englisch sind, teste in der Sprache, in der die Leute tatsächlich fragen werden. Learn sagt, dass Copilot am besten mit gut lesbaren englischen Namen funktioniert, und Synonyme liegen in den linguistischen Metadaten jeder Modellkultur, also prüf die Kultur, die die Leute wirklich verwenden.
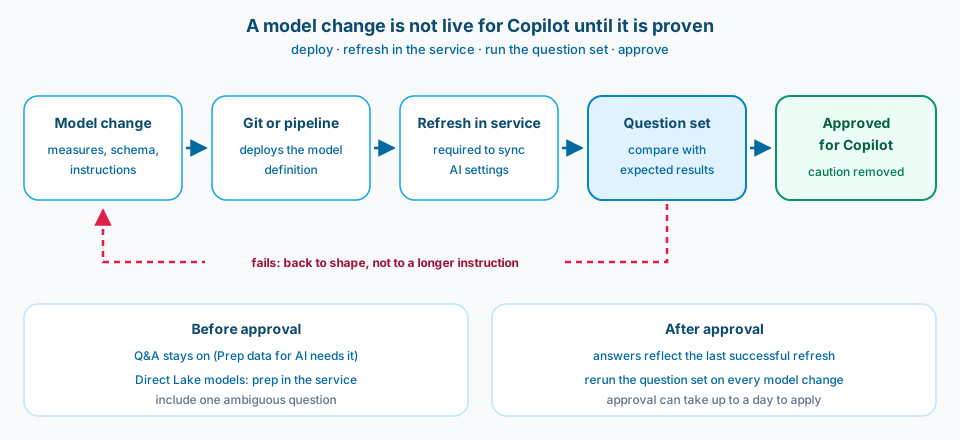
Abbildung 8. Eine Modelländerung ist für Copilot erst live, wenn der Service sie synchronisiert hat und das Fragenset bestanden ist.
Häufige Fehler
Um ein fehlendes Measure herumprompten. Eine Anweisung kann keine Zahl reparieren, die das Modell nie definiert hat.
Brutto und netto nebeneinander, ohne Beschreibung. Copilot nimmt eines davon, mit voller Überzeugung.
Schema als Sicherheit. Es fokussiert Antworten. RLS und OLS schränken Daten ein.
Verified Answers als Plan für Copilot Chat. Mit aktiviertem Fabric IQ werden sie nicht zurückgegeben.
Ein Feld ausblenden, das eine Verified Answer nutzt. Die Antwort greift dann still und leise nicht mehr.
Freigeben vor dem Testen. Das Freigabe-Flag entfernt den Warnhinweis, den die Nutzer sonst sehen würden.
Q&A beim Aufräumen abschalten. Die Tabs von Prep data for AI werden dann unbrauchbar.
Testen vor dem Refresh im Service. Copilot liest noch die alten Anweisungen.
So übernehmen oder anpassen
So übernehmen
- Die Reihenfolge formen, eingrenzen, steuern, prüfen.
- Ein reviewtes, beschriebenes Measure für jede Zahl, nach der Leute fragen.
- RLS und OLS als einzige Sicherheitsgrenze.
- Vor der Freigabe ein Fragenset mit erwarteten Ergebnissen, darunter eine mehrdeutige Frage.
Vor dem Einsatz anpassen
- Wie viele Verified Answers du baust, je nachdem, ob die Leute in Copilot Chat oder im Berichtsbereich fragen.
- Wie lang die Anweisungen werden: Fang mit Standardwerten an und ergänze nur, was die Tests als nötig zeigen.
- Deinen Release-Rhythmus für Direct Lake und DirectQuery, angesichts des Hinweises auf einen Refresh pro Tag.
- Wann du aufhörst, ein Modell zu strapazieren, und stattdessen einen Fabric data agent veröffentlichst, zum Beispiel wenn Fragen Daten aus Lakehouse oder Warehouse brauchen (semantic model best practices for data agent).
Verwandte Notizen
- Data Agent Readiness: Sind Genie (und Fabric Agents) wirklich ein Modellierungsproblem? (die Grundlagen der Modellierung unter dieser Notiz)
- Semantischer Gold-Vertrag: Kannst du wählen, welche Spalten das Modell für Direct Lake erreichen? (was überhaupt ins Modell gelangt)
- Direct Lake: Muss ein semantic model noch aktualisiert werden? (warum der Synchronisationsschritt wichtig ist)
- Agent Evals: Kann ein Score ein Release blockieren? (dasselbe Gate für Agents)
Copilot liest dein Modell, ob du es vorbereitet hast oder nicht. Bereite es vor, dann prüf es.