
Das Wichtigste in Kürze
- In diesem Test hat eine in einer Fabric SQL database committete Änderung die Quelle im Median nach 9.7 Sekunden verlassen, höchstens nach 15.1 Sekunden (Stichprobe aus dem Change Feed, letzte 3 Läufe). Am SQL analytics endpoint sichtbar wurde sie im Median nach 100 bis 158 Sekunden, im schlechtesten Fall nach 296 Sekunden.
- Das Mirroring selbst war schnell: Es hat etwa alle 15 Sekunden nach Delta committet, und eine Änderung war im Median nach 18.5 Sekunden in Delta (höchstens 28.9 Sekunden).
- In diesem Setup (eine Fabric SQL database auf einem Trial mit 64 CU, bei den getesteten Raten) war der Engpass der SQL analytics endpoint, der neue Delta-Commits übernimmt, und zwar in 15 Batches mit 151 bis 329 Sekunden Abstand. Der Weg von Delta zum Endpoint war der Großteil der Verzögerung: im Median 86% der Verzögerung jedes Markers (in Medianen 116 s von etwa 134 s).
- Sag für Abfragen über den SQL analytics endpoint "typischerweise etwa 2 Minuten, innerhalb von 5 Minuten" zu, und zwar erst, nachdem du dein eigenes Setup mit einer Heartbeat-Zeile gemessen hast.
- Tune nicht die Quelle, um das zu beheben. Erfassung und Delta-Commit waren nie der langsame Teil.
- Wenn jemand Sekunden braucht oder auf jede Änderung reagieren muss, sind Mirroring plus Endpoint der falsche Weg. Leg das Ereignis dort auf einen Stream, wo es entsteht.
- Alle Zahlen wurden auf einem Fabric Trial mit 64 CU gemessen und sind keine Aussage über ein bezahltes F64 oder SLAs in Produktion.
Jede Fabric SQL database spiegelt sich automatisch nach OneLake, ohne Einstellungen, und du bekommst einen SQL analytics endpoint über dieser Kopie (Überblick zum Mirroring der SQL database). Die erste Frage eines Stakeholders ist einfach: Wenn ich in der App eine Zeile ändere, wie schnell sehe ich sie in einem Bericht? Die FAQ von Microsoft antwortet mit "near real-time latency" und nennt kein Intervall (Mirroring FAQ). Das ist keine Zahl, die du in eine Anforderung schreiben kannst.
Also habe ich gemessen: das automatische Mirroring einer Fabric SQL database nach OneLake, gelesen über ihren SQL analytics endpoint. Das ist der erste Beitrag einer Serie von Experimenten, die ich auf einer Fabric Trial-Kapazität durchführe, jeweils mit Methode und Zahlen. Die kurze Antwort: Erfassung und Delta-Commit dauern Sekunden, und die Minuten sind der Endpoint, der aufholt.
Benanntes Modell: Die Erfassung ist schnell, gewartet wird auf den Endpoint
- Commit: Deine Transaktion endet in der Fabric SQL database.
- Erfassung: Der Change Feed liest das Log und veröffentlicht die Änderung in eine Landing Zone in OneLake. Sekunden.
- Delta-Commit: Die Änderung wird in OneLake nach Delta konvertiert. Das Mirroring hat etwa alle 15 Sekunden committet. Eine Änderung war 7.4 bis 28.9 Sekunden nach dem Commit in Delta.
- Endpoint-Sync: Der SQL analytics endpoint übernimmt die neuen Delta-Commits in Batches. Minuten.
- Abfrage: Eine T-SQL-Abfrage auf dem Endpoint kann die Zeile sehen.
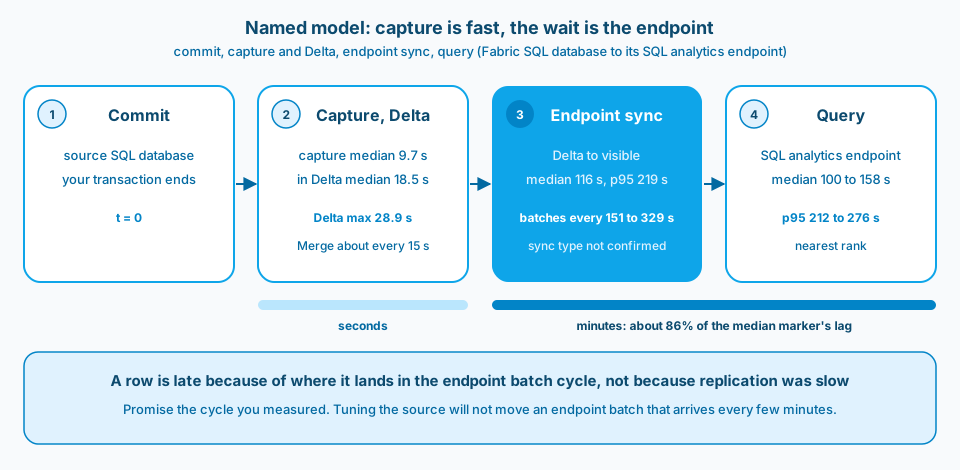
Abbildung 1. Die Änderung ist innerhalb von Sekunden in Delta. Die Minuten, die ein Nutzer spürt, sind der SQL analytics endpoint, der sie übernimmt.
Was ich gemessen habe, und wie
Die Frage: Wie lange dauert es, bis eine committete Änderung in einer Fabric SQL database auf ihrem eigenen SQL analytics endpoint abfragbar ist, bei etwa 10, 100 und 1,000 geänderten Zeilen pro Sekunde? Ich habe am SQL analytics endpoint gemessen, nicht an den Dateien in OneLake.
- Setup: eine Fabric SQL database mit einer neutralen Tabelle, befüllt mit 1,000,000 deterministischen Zeilen, auf einer Fabric Trial-Kapazität mit 64 CU in einer Region, an einem Abend.
- Last: 9 Läufe zu je 150 Sekunden, in 3 Runden mit 10, 100 und 1,000 Zeilen pro Sekunde, immer in dieser Reihenfolge. Eine Transaktion pro Sekunde mit 40% Inserts, 40% Updates und 20% Deletes und 60 Sekunden Pause zwischen den Läufen. Erreicht wurden 10.1, 100.6 bis 100.7 und 1,006.4 bis 1,006.5 Zeilen pro Sekunde, ohne verspätete Takte.
- Heartbeat-Marker: Alle 10 Sekunden und einmal am Ende jedes Bursts kam eine Marker-Zeile mit ihrer Commit-Zeit nach der Uhr der Quelle hinzu. Das sind 17 Marker pro Lauf, 51 pro Rate, 153 insgesamt.
- Polling: Ein zweiter Thread fragte den Endpoint alle 2 Sekunden nach neuen Markern ab, mit einem eindeutigen Prädikat bei jedem Poll, damit kein Ergebnis aus einem Cache kommen konnte.
- Verzögerung: der erste Poll, der einen Marker sieht, minus seine Commit-Zeit, korrigiert um den Uhrenversatz zwischen den beiden Servern (unter 4 ms). Die Auflösung liegt bei etwa 2 Sekunden.
- Erfassung: Nach den Läufen habe ich die letzten 30 Sitzungen aus sys.dm_change_feed_log_scan_sessions und den Inhalt von sys.dm_change_feed_errors gesichert. Diese Stichprobe deckt nur die Läufe 7 bis 9 ab. Ihre Latenzspalte gilt pro Scan-Sitzung: die Zeit zwischen dem Ende der Sitzung und dem Commit, den sie verarbeitet hat (sys.dm_change_feed_log_scan_sessions). Um jeden Marker zu timen, habe ich ihn der ersten Scan-Sitzung zugeordnet, die über seinen Commit hinaus verarbeitet hat.
- Delta-Commits: Nach den Läufen habe ich das Delta-Log der gespiegelten Tabelle in OneLake gelesen, nur lesend: 102 Commits über den Abend. Der Replikator schreibt keinen commitInfo-Zeitstempel, also ist die Zeit eines Commits die lastModified-Zeit seiner Logdatei in OneLake, ein guter Näherungswert mit 1 Sekunde Auflösung. Jeder Marker wurde dem ersten Commit zugeordnet, dessen neueste Quelländerung die Commit-Zeit des Markers erreicht.
Das ganze SQL lief aus Fabric Python Notebooks. Keine Zahl unten ist von Hand eingetippt. Sie stammen aus den Logs der Läufe.
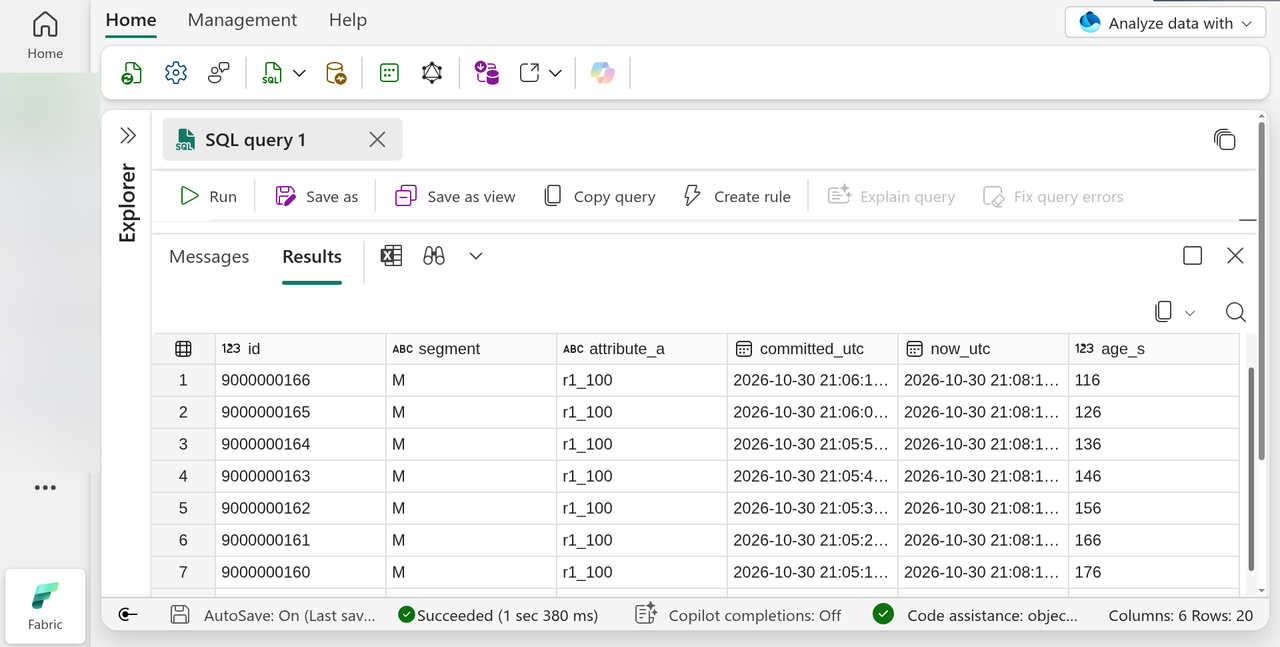
Abbildung 2. Jeder Heartbeat-Marker trägt seine Commit-Zeit aus der Quelle, und die Abfrage vergleicht sie mit der Uhr des Endpoints. Die Verzögerung in diesem Beitrag ist diese Differenz beim ersten Poll, der den Marker sieht.
Ergebnisse
Alle 153 Marker wurden gesehen. Über die 51 Marker pro Rate:
| Geänderte Zeilen pro Sekunde | Median der Verzögerung | p95 der Verzögerung (Nearest Rank) | Min | Max |
|---|---|---|---|---|
| 10 | 158 s | 276 s | 32 s | 296 s |
| 100 | 130 s | 244 s | 18 s | 264 s |
| 1,000 | 100 s | 212 s | 20 s | 214 s |
p95 ist Nearest Rank: der 49. von 51 sortierten Werten, Rang ceil(0.95 × n). Über alle 153 Marker waren 16% innerhalb von 60 Sekunden sichtbar, 44% innerhalb von 2 Minuten, 75% innerhalb von 3 Minuten, 94% innerhalb von 4 Minuten und alle innerhalb von 5 Minuten.
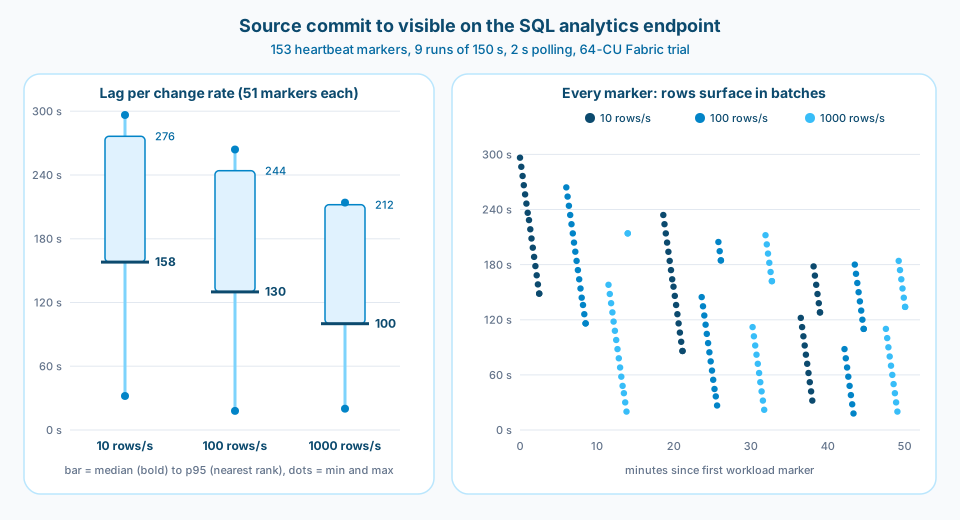
Abbildung 3. Der Sägezahn rechts ist das Ergebnis. Marker, die früh in einem Zyklus committet werden, warten am längsten. Marker, die kurz vor einem Batch committet werden, warten nur Sekunden.
Weitere Zahlen vom selben Abend:
- Erfassung: Bei den 41 Markern in der DMV-Stichprobe (Läufe 7 bis 9) verließ die Änderung die Quelle im Median 9.7 Sekunden nach dem Commit, höchstens nach 15.1 Sekunden. Die Zeit von dort bis zur Sichtbarkeit am Endpoint lag im Median bei 110 Sekunden (12 bis 171 Sekunden), etwa 92% der Verzögerung jedes Markers. Jede Scan-Sitzung in der Stichprobe endete ohne Fehler und ohne ausstehende Veröffentlichungen, und die DMV für Fehler war leer.
- Delta-Commit: Über alle 153 Marker war eine Änderung 7.4 bis 28.9 Sekunden nach dem Commit in Delta (Median 18.5 Sekunden, p95 27.3 Sekunden). Von diesem Delta-Commit bis zur Sichtbarkeit am Endpoint vergingen 2.8 bis 278.6 Sekunden (Median 116.3 Sekunden, p95 218.6 Sekunden).
- Erster Snapshot: Das Einfügen der 1,000,000 Startzeilen dauerte 5.5 Sekunden, sie waren etwa 46 Sekunden nach dem Commit in Delta, und die vollständige Zeilenzahl war 125 Sekunden nach dem Commit am Endpoint sichtbar. Bis dahin lieferte der Endpoint für die neue Tabelle "Invalid object name". Diese Zeit enthält also, dass der Endpoint eine ganz neue Tabelle erst entdecken muss.
- Angleichung der Zeilenzahlen: Nach jedem Burst stimmten die Zeilenzahlen von Quelle und Endpoint nach 88 bis 216 Sekunden überein.
- Von Lauf zu Lauf: Die Mediane der Läufe lagen beim selben Setup zwischen 98 und 218 Sekunden.
Woher die Verzögerung tatsächlich kommt
Die Erfassung dauerte Sekunden, der Delta-Commit ebenso. Während jedes Bursts hat das Mirroring alle 14 bis 16 Sekunden einen Delta Merge committet (Median 15.0 Sekunden). Das Batching liegt also nicht in der Replikation. Es sitzt zwischen der Delta-Tabelle und dem SQL analytics endpoint.
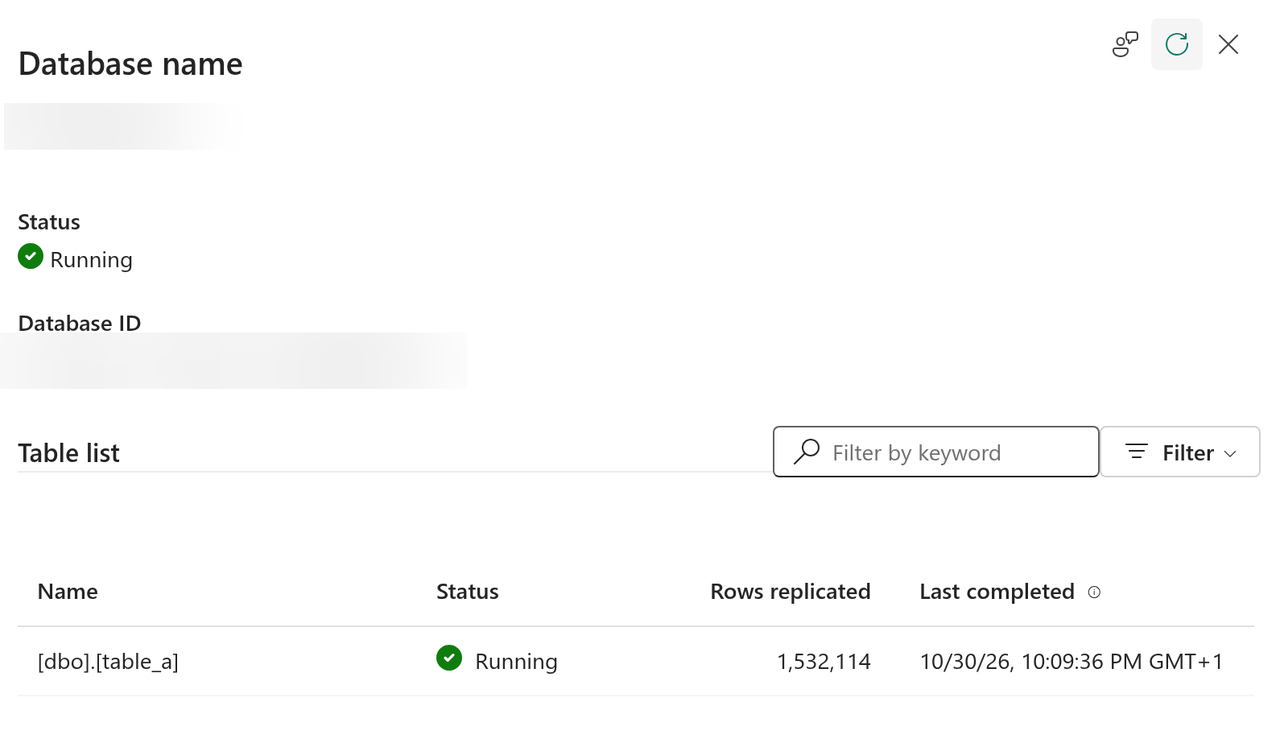
Abbildung 4. Der Replication Monitor zeigte Running mit einer aktuellen letzten Fertigstellung. Er berichtet über die Replikation nach OneLake, nicht darüber, wann der SQL analytics endpoint die Zeile sehen kann, und dieser zweite Schritt war hier der Großteil der Verzögerung (in Medianen 116 s von etwa 134 s).
Abbildung 3 zeigt, wie: Die Zeilen tröpfelten nicht herein. Über den Abend gab es 15 Batches neu sichtbarer Marker mit 151 bis 329 Sekunden Abstand (Median 188 Sekunden). Jeder Batch übernahm zwischen 1 und 11 Delta-Commits auf einmal, und jeder Marker, der in diesem Moment wartete, erschien gleichzeitig.
Diese eine Tatsache erklärt die Streuung in der Tabelle:
- Ein Marker, der kurz vor einem Batch committet wird, erscheint nach etwa 18 bis 32 Sekunden. Das ist die Spalte Min.
- Ein Marker, der kurz nach einem Batch committet wird, wartet auf den nächsten, bis zu fast 5 Minuten. Das ist die Spalte Max.
- Der Median liegt ungefähr in der Mitte des Zyklus.
Zur Einordnung: Learn sagt, dass die Verzögerung zwischen einem Lakehouse und seinem SQL analytics endpoint unter normalen Betriebsbedingungen unter einer Minute liegt und "from a few seconds to minutes" schwankt (Leistung des SQL analytics endpoint). Hier dauerte der Weg von Delta zum Endpoint im Median 116 Sekunden, deutlich mehr. Das ist ein Abend auf einem Trial, also lese ich es als das, was dieser Endpoint an diesem Abend getan hat, nicht als allgemeinen Wert.
Welcher Metadaten-Sync lief, ist nicht bestätigt. Am 30. Oktober 2026 hatte der Endpoint die Objekte, die Learn für den neuen Metadaten-Sync (Preview) aufführt, sys.dm_db_external_tables_log_status und sys.sp_dw_refresh_ext_table, aber diese DMV lieferte keine Zeilen, und das Portal zeigte keine Einstellung für den Metadaten-Sync (Preview). Das passt zum alten Metadaten-Sync, ist aber kein Beweis. Learn sagt, der neue Metadaten-Sync macht Daten "within seconds" nach dem Eintreffen abfragbar und gilt nur für Endpoints, die nach seiner Aktivierung erstellt wurden (Metadaten-Sync).
Zur Änderungsrate: Der Median war in jeder Runde bei höheren Raten niedriger. Ich behaupte nicht, dass die Rate das verursacht hat. In jeder Runde war die Reihenfolge immer 10, dann 100, dann 1,000 Zeilen pro Sekunde, und die erste Runde kam direkt nach dem ersten Snapshot. Rate und Position in der Runde lassen sich also nicht trennen. Die 17 Marker jedes Laufs fielen außerdem in nur 1 bis 3 Batches, die eigentliche Stichprobe ist also die Zahl der Batches, nicht 51 Marker pro Rate. Das Batching erklärt die Streuung. Einen Trend nach Rate erklärt es nicht.
Was du Stakeholdern zusagen kannst
Formuliere die Zusage als Zahl, und zwar für den Abfrageweg, den die Leute tatsächlich nutzen:
- Für Berichte und Ad-hoc-Abfragen mit T-SQL auf dem SQL analytics endpoint: "typischerweise etwa 2 Minuten, innerhalb von 5 Minuten". Das hat in diesem Test jeden Marker abgedeckt, mit etwas Reserve gegenüber dem schlechtesten Fall von 296 Sekunden.
- Sag nicht "near real-time" zu. Das ist die Formulierung von Microsoft, und Leute hören Sekunden. Die Learn-Seite zum Endpoint sagt selbst, dass Minuten möglich sind.
- Sag für ein ruhiges System noch nichts zu. Learn sagt, der Hintergrundprozess für den Sync des Endpoints "stops after 15 minutes without query activity" (Leistung des SQL analytics endpoint). Das ist für Lakehouses geschrieben. Der Endpoint der SQL database ist derselbe Endpoint im Lakehouse-Stil (Einschränkungen des Mirroring), und eine Fabric SQL database kann im Leerlauf pausieren, was auch ausstehendes Mirroring pausiert (Überblick zum Mirroring der SQL database). Mein Polling alle 2 Sekunden hielt den Endpoint beschäftigt, und ich habe eine Probe für die erste Änderung nach einer Ruhephase gebaut, sie aber nicht ausgeführt. Der kalte Fall ist hier nicht gemessen.
- Miss auf deiner eigenen Kapazität nach. Das ist eine Tabelle, eine Region, ein Abend auf einem Trial, mit einem schweren, von TPC-H abgeleiteten Build, der zur selben Zeit auf derselben Kapazität lief. Dein Zyklus kann kürzer oder länger sein.
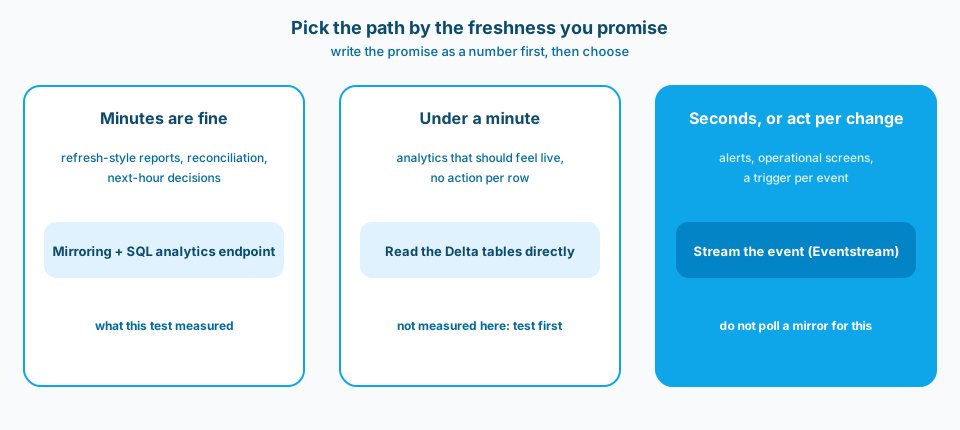
Abbildung 5. Einigt euch zuerst auf die Zahl für die Frische. Die Zahl wählt den Weg, nicht umgekehrt.
Wann Mirroring reicht und wann du einen Stream brauchst
Mirroring plus SQL analytics endpoint ist eine gute Standardwahl, wenn Minuten akzeptabel sind: Reporting über operative Daten, Abgleiche und Analysen, die keine Aktion pro Zeile auslösen. Es gibt keine Pipeline zu bauen, und laut der FAQ von Microsoft fallen für das Mirroring aus einer Fabric SQL database nach OneLake keine Compute-Kosten an, und der Speicher für das Mirroring ist bis zu einer von der Kapazität abhängigen Grenze kostenlos (Mirroring FAQ). Deine Abfragen auf dem Endpoint werden normal abgerechnet. Der Kapazitätsverbrauch für diesen Test ist noch nicht gemessen. Wenn der Wert kommt, sind es die Kosten des Test-Harness (Endpoint-Abfragen und Notebooks), nicht die der Replikation.
Das falsche Werkzeug ist es, wenn jemand innerhalb von Sekunden reagieren muss: ein Alert, eine operative Ansicht, ein Workflow, der pro Änderung auslöst. Einen Mirror alle paar Sekunden zu pollen, schlägt keinen Zyklus, der in Minuten gemessen wird. Leg das Ereignis dort auf einen Stream, wo es entsteht, mit Eventstream in ein Eventhouse oder Activator (Überblick zu Eventstream), und behalte das Mirroring für die analytische Kopie.
Dazwischen liegt "soll sich live anfühlen, aber niemand reagiert pro Zeile". Engines, die die Delta-Tabellen in OneLake direkt lesen, etwa Spark oder ein Direct Lake Modell, überspringen den Sync des SQL analytics endpoint. Da jede Änderung hier innerhalb von etwa 30 Sekunden in Delta war, sehen sie Änderungen möglicherweise viel früher als der Endpoint (Direct Lake nach dem Reframing, zum Beispiel mit aktivierten automatischen Updates). Diesen Weg habe ich nicht getestet, also teste ihn, bevor du ihn zusagst.
So behältst du es im Blick
Das sind die Monitoring-Wege, die für den Mirror einer Fabric SQL database gelten:
- Portal: In der SQL database zeigt der Tab Replication und dann Monitor replication den aktuellen Status, die replizierten Zeilen und den letzten Refresh (Mirroring überwachen).
- DMVs der Quelle: sys.dm_change_feed_log_scan_sessions für das Timing der Erfassung und sys.dm_change_feed_errors für Fehler (Mirroring FAQ).
- Seite des Endpoints: Der REST-Aufruf Refresh SQL endpoint metadata liefert pro Tabelle ein lastSuccessfulSyncDateTime (Refresh SQL endpoint metadata). Er löst auch einen Sync aus, behandle ihn also als Aktion, nicht als passives Lesen.
- Eine Heartbeat-Zeile: die einzige Methode, die misst, was ein Nutzer spürt. Siehe unten.
Der REST-Aufruf getMirroringStatus gilt hier nicht. Er gehört zu Items vom Typ Mirrored Database (Get Mirroring Status), während die API der SQL database für das Mirroring nur Start und Stop anbietet (API für das Mirroring der SQL database). Ein 404 für eine SQL database ist zu erwarten.
Häufige Fehler
- "Near real-time" als Zahl behandeln. Microsoft veröffentlicht dafür kein Intervall. Miss dein eigenes.
- Die Quelle tunen. Eine schnellere Erfassung hilft nicht, wenn die Verzögerung darin liegt, dass der Endpoint Delta-Commits übernimmt.
- Nur mit Zeilenzahlen messen. Zeilenzahlen gleichen sich irgendwann an und verstecken die Streuung pro Zeile. Eine Heartbeat-Zeile mit Zeitstempel zeigt den Sägezahn.
- Einen Cache die Probe beantworten lassen. Wenn jeder Poll dieselbe Abfrage ist, kann ein Ergebnis aus dem Cache die Frische schlechter oder besser aussehen lassen, als sie ist. Variiere das Prädikat.
- Den besten Lauf melden oder das p95 als schlechtesten Fall. Die Mediane der Läufe lagen in diesem Test beim selben Setup zwischen 98 und 218 Sekunden. Melde alle Läufe, das p95 mit seiner Methode und das Maximum als schlechtesten Fall.
- Einen Trend aus einer festen Reihenfolge ablesen. Wenn die Raten immer in derselben Reihenfolge laufen, ist jeder Trend nach Rate auch ein Trend nach Position. Mische die Reihenfolge pro Runde.
So übernehmen oder anpassen
Eine Heartbeat-Tabelle ist der billigste Weg, deine echte Verzögerung zu kennen und zu alarmieren, wenn sie wegdriftet. In der Fabric SQL database:
-- datetime2(6): mirrored Delta and the SQL analytics endpoint keep six fractional digits; (7) would be trimmed
CREATE TABLE dbo.heartbeat (
    id            bigint       NOT NULL PRIMARY KEY,
    committed_utc datetime2(6) NOT NULL
);

-- run on a schedule, for example every minute
INSERT INTO dbo.heartbeat (id, committed_utc)
SELECT ISNULL(MAX(id), 0) + 1, SYSUTCDATETIME() FROM dbo.heartbeat;
Auf dem SQL analytics endpoint:
SELECT MAX(committed_utc) AS last_seen_commit_utc,
       DATEDIFF(second, MAX(committed_utc), SYSUTCDATETIME()) AS staleness_s
FROM dbo.heartbeat;
Wenn staleness_s über die zugesagte Zahl plus das Heartbeat-Intervall (hier 60 s) steigt, weißt du es vor dem Stakeholder. Der Hinweis zu den sechs Stellen stammt aus der Grenze für die Genauigkeit in Delta in den Einschränkungen des Mirroring und von der Seite zu Datentypen. Es sind zwei Uhren beteiligt, Quelle und Endpoint. In meinen Läufen lag der Versatz unter 4 ms, aber prüf deinen, bevor du einstelligen Sekunden vertraust.
Hinweise zur Methode und Einschränkungen
- Gemessen auf einem Fabric Trial mit 64 CU, keine Aussage über ein bezahltes F64 oder Produktion: 153 Marker, 9 Läufe, ein Abend, eine Region, eine Datenbank, eine Tabelle.
- Während der Läufe lief auf derselben Trial-Kapazität ein von TPC-H abgeleiteter Build, Effekte durch laute Nachbarn lassen sich also nicht ausschließen.
- Die Zahlen zur Erfassung stammen aus der DMV-Stichprobe für die Läufe 7 bis 9 (41 Marker), nicht aus dem ganzen Abend. Die Delta-Zahlen decken alle 153 Marker ab.
- Die Zeiten der Delta-Commits sind die lastModified-Zeiten der Logdateien in OneLake (1 Sekunde Auflösung), weil der Replikator keinen commitInfo-Zeitstempel schreibt.
- Bei 17 Markern ist das p95 jedes Laufs gleich seinem Maximum, deshalb wird nur das gepoolte p95 pro Rate gemeldet.
- Sync-Typ: nicht bestätigt.
- 3 Läufe pro Rate, immer in derselben Reihenfolge, also keine Aussage zur Rate.
- p95 ist Nearest Rank, ceil(0.95 × n). Das Maximum ist der schlechteste Fall.
- Kapazitätsverbrauch (CU): noch nicht gemessen. Ein späterer Wert deckt das Test-Harness ab (Endpoint-Abfragen und Notebooks), nicht die Replikation.
- Der Fall im Leerlauf (kalt) wurde nicht ausgeführt.
- Die Verzögerung ist Ende zu Ende über den SQL analytics endpoint gemessen. Wer die Delta-Tabelle direkt liest, sieht Änderungen möglicherweise viel früher, hier nicht getestet.
Probier es selbst aus
Die Demo zur Mirroring-Verzögerung in meinem öffentlichen Repo tech-demos befüllt eine Fabric SQL database, fährt die Last mit 10, 100 und 1,000 Zeilen pro Sekunde mit Heartbeat-Markern und pollt den SQL analytics endpoint. So kannst du die Verzögerung auf deiner eigenen Kapazität messen.
Verwandte Notizen
- Als Nächstes in der Trial-Serie: Fabric Engines mit 1B Zeilen: nach Abfrageform wählen, dieselbe Trial-Kapazität, die vier Engines auf einer Milliarde Zeilen misst, statt Frische zu messen.
- Semantischer Refresh und Direct Lake für die andere Seite der Frage "Wann sieht ein Bericht neue Daten?".
- Runbooks für Fabric Monitor, um aus einem Heartbeat einen Alert zu machen, für den jemand verantwortlich ist.