
Puntos clave
- En esta prueba, un cambio confirmado en una Fabric SQL database salió del origen en una mediana de 9.7 segundos, 15.1 segundos como máximo (muestra del change feed, últimas 3 ejecuciones). Se hizo visible en el SQL analytics endpoint tras una mediana de 100 a 158 segundos, y 296 segundos en el peor caso.
- El mirroring en sí fue rápido: hizo commit en Delta más o menos cada 15 segundos, y un cambio llegó a Delta en una mediana de 18.5 segundos (máximo 28.9 segundos).
- En este entorno (una Fabric SQL database en un trial de 64 CU, a las tasas probadas), el cuello de botella fue el SQL analytics endpoint recogiendo los nuevos commits de Delta, en 15 lotes separados entre 151 y 329 segundos. El tramo de Delta al endpoint fue la mayor parte de la latencia: una mediana del 86% de la latencia de cada marcador (en medianas, 116 s de unos 134 s).
- Promete "unos 2 minutos lo habitual, en menos de 5 minutos" para las consultas a través del SQL analytics endpoint, y solo después de haber medido tu propio entorno con una fila de heartbeat.
- No ajustes el origen para arreglar esto. La captura y el commit en Delta nunca fueron la parte lenta.
- Si alguien necesita segundos, o necesita actuar ante cada cambio, mirroring más endpoint es el camino equivocado. Pon el evento en un stream allí donde se produce.
- Todas las cifras se midieron en un trial de Fabric de 64 CU y no dicen nada sobre un F64 de pago ni sobre SLA de producción.
Cada Fabric SQL database se replica automáticamente en OneLake, sin nada que configurar, y obtienes un SQL analytics endpoint sobre esa copia (visión general del mirroring de SQL database). La primera pregunta de cualquier stakeholder es sencilla: si cambio una fila en la aplicación, ¿cuánto tardo en verla en un informe? Las FAQ de Microsoft responden "near real-time latency" y no publican ningún intervalo (FAQ de mirroring). Eso no es una cifra que puedas poner en un requisito.
Así que lo medí: el mirroring automático de una Fabric SQL database a OneLake, leído a través de su SQL analytics endpoint. Es el primer artículo de una serie de experimentos que hago en una capacidad trial de Fabric, cada uno con su método y sus cifras. La respuesta corta: la captura y el commit en Delta tardan segundos, y los minutos son el endpoint poniéndose al día.
Modelo con nombre: la captura es rápida, la espera es el endpoint
- Commit: tu transacción termina en la Fabric SQL database.
- Captura: el change feed lee el log y publica el cambio en una landing zone de OneLake. Segundos.
- Commit en Delta: el cambio se convierte a Delta en OneLake. El mirroring hizo commit más o menos cada 15 segundos; un cambio estaba en Delta entre 7.4 y 28.9 segundos después del commit.
- Sincronización del endpoint: el SQL analytics endpoint recoge los nuevos commits de Delta por lotes. Minutos.
- Consulta: una consulta T-SQL en el endpoint ya puede ver la fila.
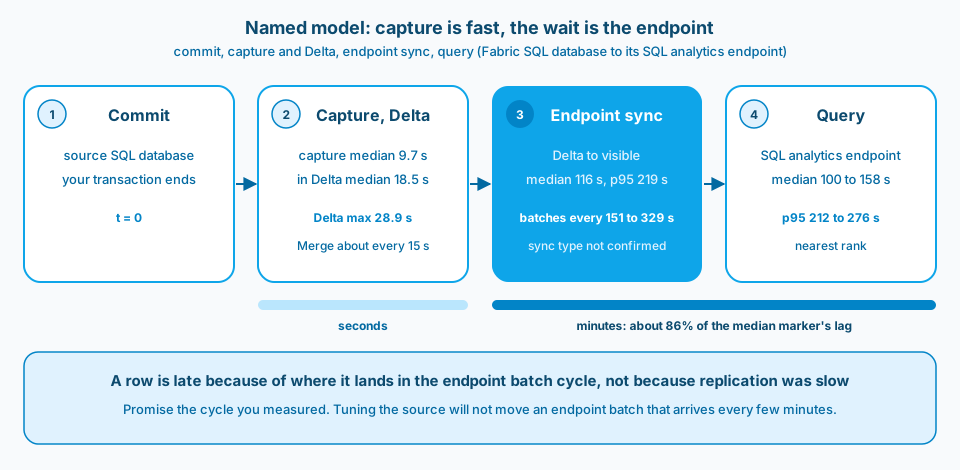
Figura 1. El cambio está en Delta en segundos. Los minutos que nota un usuario son el SQL analytics endpoint recogiéndolo.
Qué medí y cómo
La pregunta: ¿cuánto tarda un cambio confirmado en una Fabric SQL database en poder consultarse en su propio SQL analytics endpoint, a unas 10, 100 y 1,000 filas modificadas por segundo? Medí en el SQL analytics endpoint, no en los archivos de OneLake.
- Entorno: una Fabric SQL database con una tabla neutra, cargada con 1,000,000 filas deterministas, en una capacidad trial de Fabric de 64 CU, en una región, en una sola tarde.
- Carga: 9 ejecuciones de 150 segundos cada una, en 3 rondas de 10, 100 y 1,000 filas por segundo, siempre en ese orden. Una transacción por segundo, con un 40% de inserts, un 40% de updates y un 20% de deletes, y 60 segundos de pausa entre ejecuciones. Las tasas alcanzadas fueron 10.1, de 100.6 a 100.7 y de 1,006.4 a 1,006.5 filas por segundo, sin ticks retrasados.
- Marcadores de heartbeat: cada 10 segundos, y una vez más al final de cada ráfaga, se insertaba una fila marcador con su hora de commit según el reloj del origen. Son 17 marcadores por ejecución, 51 por tasa y 153 en total.
- Sondeo: un segundo hilo consultaba el endpoint cada 2 segundos en busca de marcadores nuevos, con un predicado distinto en cada sondeo para que ningún resultado pudiera venir de una caché.
- Latencia: el primer sondeo que ve un marcador, menos su hora de commit, corregido por el desfase de reloj entre los dos servidores (menos de 4 ms). La resolución es de unos 2 segundos.
- Captura: después de las ejecuciones guardé las últimas 30 sesiones de sys.dm_change_feed_log_scan_sessions y el contenido de sys.dm_change_feed_errors. Esa muestra solo cubre las ejecuciones 7 a 9. Su columna de latencia es por sesión de escaneo: el tiempo entre el final de la sesión y el commit que estaba procesando (sys.dm_change_feed_log_scan_sessions). Para cronometrar cada marcador, lo emparejé con la primera sesión de escaneo que procesó más allá de su commit.
- Commits en Delta: después de las ejecuciones leí el log de Delta de la tabla replicada en OneLake, solo en lectura: 102 commits durante la noche. El replicador no escribe ninguna marca de tiempo en commitInfo, así que la hora de un commit es el lastModified de su archivo de log en OneLake, una aproximación fiel con resolución de 1 segundo. Cada marcador se emparejó con el primer commit cuyo cambio de origen más reciente alcanza la hora de commit del marcador.
Todo el SQL se ejecutó desde notebooks de Python en Fabric. Ninguna cifra de abajo está tecleada a mano; salen de los logs de las ejecuciones.
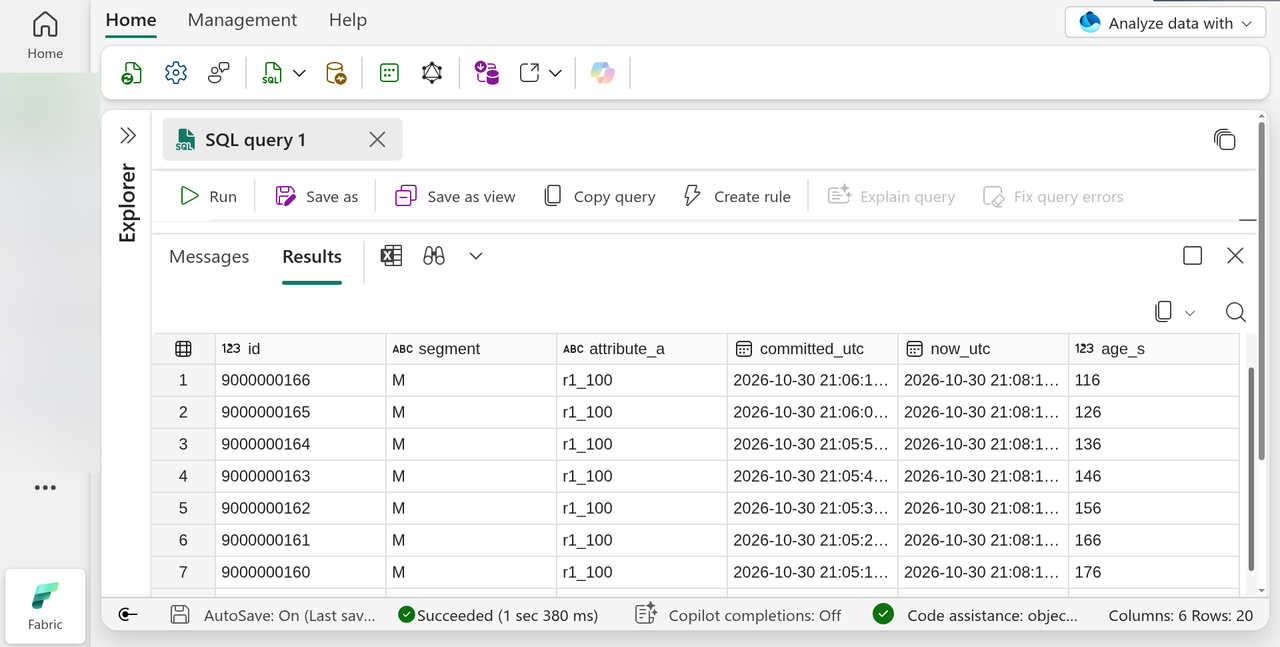
Figura 2. Cada marcador de heartbeat lleva su hora de commit del origen, y la consulta la compara con el reloj del endpoint. La latencia de este artículo es esa diferencia en el primer sondeo que ve el marcador.
Resultados
Se vieron los 153 marcadores. Sobre los 51 marcadores por tasa:
| Filas modificadas por segundo | Latencia mediana | Latencia p95 (rango más cercano) | Mín | Máx |
|---|---|---|---|---|
| 10 | 158 s | 276 s | 32 s | 296 s |
| 100 | 130 s | 244 s | 18 s | 264 s |
| 1,000 | 100 s | 212 s | 20 s | 214 s |
El p95 es por rango más cercano: el valor 49 de 51 ordenados, rango ceil(0.95 × n). En los 153 marcadores, el 16% era visible en menos de 60 segundos, el 44% en menos de 2 minutos, el 75% en menos de 3 minutos, el 94% en menos de 4 minutos y todos en menos de 5 minutos.
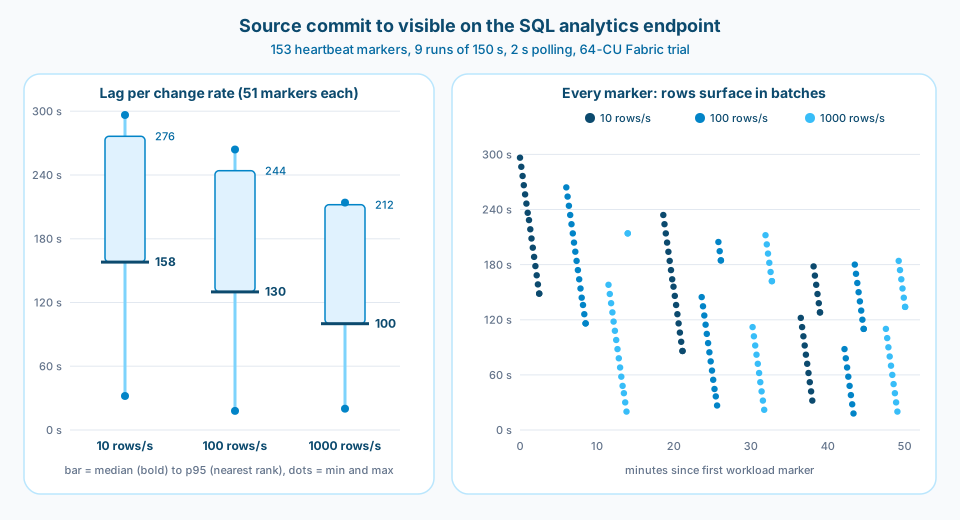
Figura 3. El diente de sierra de la derecha es el hallazgo. Los marcadores confirmados al principio de un ciclo son los que más esperan; los confirmados justo antes de un lote esperan solo segundos.
Más cifras de la misma noche:
- Captura: en los 41 marcadores de la muestra de la DMV (ejecuciones 7 a 9), el cambio salió del origen 9.7 segundos después del commit en la mediana, y 15.1 segundos como máximo. El tiempo desde ahí hasta ser visible en el endpoint fue de 110 segundos en la mediana (de 12 a 171 segundos), cerca del 92% de la latencia de cada marcador. Todas las sesiones de escaneo de la muestra terminaron sin errores y sin nada pendiente de publicar, y la DMV de errores estaba vacía.
- Commit en Delta: en los 153 marcadores, un cambio estaba en Delta entre 7.4 y 28.9 segundos después del commit (mediana de 18.5 segundos, p95 de 27.3 segundos). Desde ese commit en Delta hasta ser visible en el endpoint pasaron entre 2.8 y 278.6 segundos (mediana de 116.3 segundos, p95 de 218.6 segundos).
- Snapshot inicial: insertar la carga de 1,000,000 filas llevó 5.5 segundos, llegó a Delta unos 46 segundos después del commit, y el recuento completo era visible en el endpoint 125 segundos después del commit. Hasta entonces, el endpoint devolvía "Invalid object name" para la tabla nueva, así que ese tiempo incluye que el endpoint descubra una tabla recién creada.
- Convergencia de recuentos: después de cada ráfaga, los recuentos de filas del origen y del endpoint coincidieron al cabo de 88 a 216 segundos.
- De una ejecución a otra: las medianas por ejecución con el mismo entorno fueron de 98 a 218 segundos.
De dónde sale realmente la latencia
La captura tardó segundos, y el commit en Delta también. Durante cada ráfaga, el mirroring hizo commit de un Merge en Delta cada 14 a 16 segundos (mediana de 15.0 segundos). Así que el procesamiento por lotes no está en la replicación. Está entre la tabla Delta y el SQL analytics endpoint.
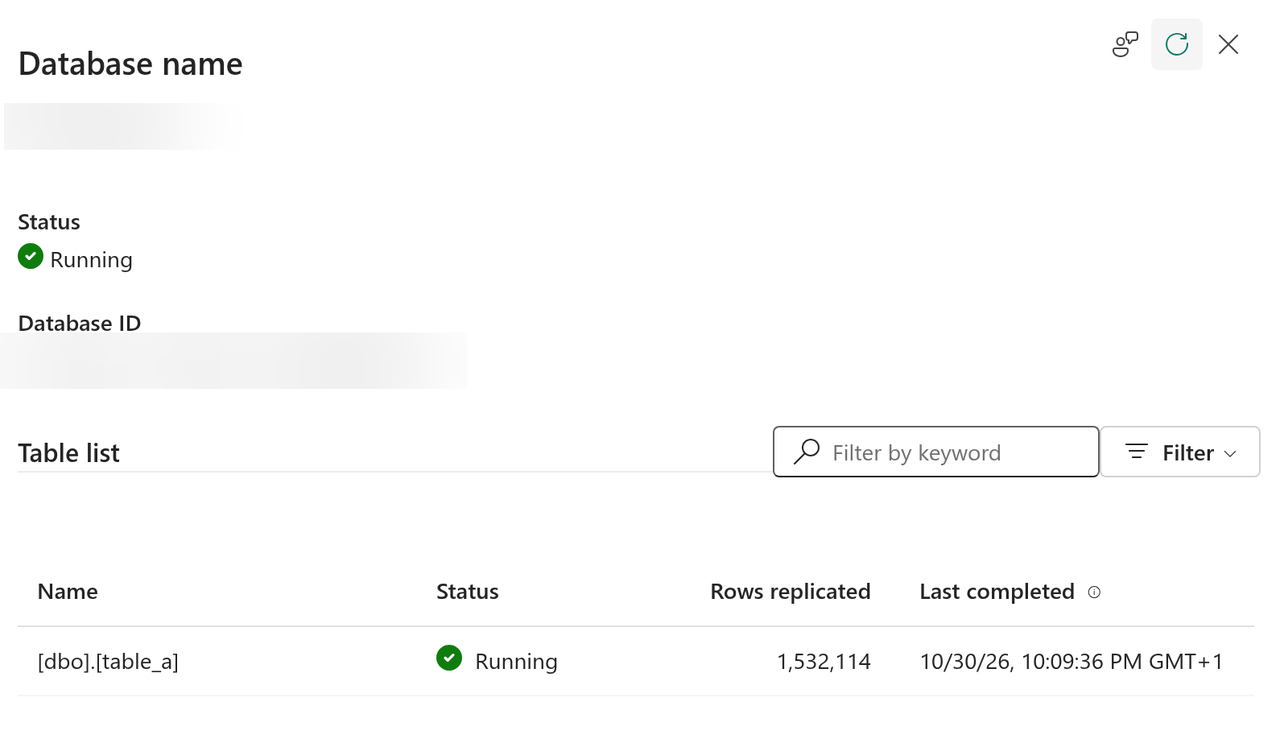
Figura 4. El monitor de replicación decía Running, con una última finalización reciente. Informa de la replicación a OneLake, no de cuándo el SQL analytics endpoint puede ver la fila, y ese segundo paso fue aquí la mayor parte de la latencia (en medianas, 116 s de unos 134 s).
La figura 3 muestra cómo: las filas no fueron llegando poco a poco. Durante la noche hubo 15 lotes de marcadores recién visibles, separados entre 151 y 329 segundos (mediana de 188 segundos). Cada lote recogió de 1 a 11 commits de Delta de golpe, y todos los marcadores que esperaban en ese momento aparecieron a la vez.
Ese único hecho explica la dispersión de la tabla:
- Un marcador confirmado justo antes de un lote aparece en unos 18 a 32 segundos. Esa es la columna Mín.
- Un marcador confirmado justo después de un lote espera al siguiente, hasta casi 5 minutos. Esa es la columna Máx.
- La mediana queda más o menos a mitad del ciclo.
Como contexto, Learn dice que, en condiciones normales de funcionamiento, el retraso entre un lakehouse y su SQL analytics endpoint es inferior a un minuto y varía "from a few seconds to minutes" (rendimiento del SQL analytics endpoint). Aquí, el tramo de Delta al endpoint tuvo una mediana de 116 segundos, muy por encima. Es una tarde en un trial, así que lo leo como lo que hizo este endpoint esa noche, no como una cifra general.
No está confirmado qué sincronización de metadatos estaba activa. El 30 de octubre de 2026 el endpoint tenía los objetos que Learn indica para la nueva sincronización de metadatos (preview), sys.dm_db_external_tables_log_status y sys.sp_dw_refresh_ext_table, pero esa DMV no devolvió filas y el portal no mostraba ningún ajuste de sincronización de metadatos (preview). Eso encaja con la sincronización de metadatos antigua, pero no lo demuestra. Learn dice que la nueva sincronización de metadatos deja los datos consultables "within seconds" desde que llegan y solo se aplica a endpoints creados después de activarla (sincronización de metadatos).
Sobre la tasa de cambio: la mediana fue más baja con tasas más altas en todas las rondas. No digo que la tasa lo causara. Dentro de cada ronda el orden fue siempre 10, luego 100, luego 1,000 filas por segundo, y la primera ronda llegó justo después del snapshot inicial, así que la tasa y la posición en la ronda no se pueden separar. Además, los 17 marcadores de cada ejecución cayeron en solo 1 a 3 lotes, así que la muestra real es el número de lotes, no 51 marcadores por tasa. Los lotes explican la dispersión; no explican una tendencia por tasa.
Qué prometer a los stakeholders
Escribe la promesa como una cifra, y sobre el camino de consulta que la gente va a usar de verdad:
- Para informes y T-SQL ad hoc en el SQL analytics endpoint: "unos 2 minutos lo habitual, en menos de 5 minutos". Eso cubrió todos los marcadores de esta prueba, con algo de margen sobre el peor caso de 296 segundos.
- No prometas "near real-time". Es la expresión de Microsoft, y la gente entiende segundos. La propia página de Learn sobre el endpoint dice que puede tardar minutos.
- No prometas nada todavía para un sistema en reposo. Learn dice que el proceso de sincronización en segundo plano del endpoint "stops after 15 minutes without query activity" (rendimiento del SQL analytics endpoint). Está escrito para lakehouses; el endpoint de la SQL database es el mismo endpoint de estilo lakehouse (limitaciones del mirroring), y una Fabric SQL database puede pausarse cuando está inactiva, lo que también pausa el mirroring pendiente (visión general del mirroring de SQL database). Mi sondeo cada 2 segundos mantuvo ocupado el endpoint, y preparé una prueba para el primer cambio tras un periodo de inactividad, pero no la ejecuté. El caso en frío no está medido aquí.
- Vuelve a medir en tu propia capacidad. Esto es una tabla, una región y una tarde en un trial, con un build pesado derivado de TPC-H en la misma capacidad al mismo tiempo. Tu ciclo puede ser más corto o más largo.
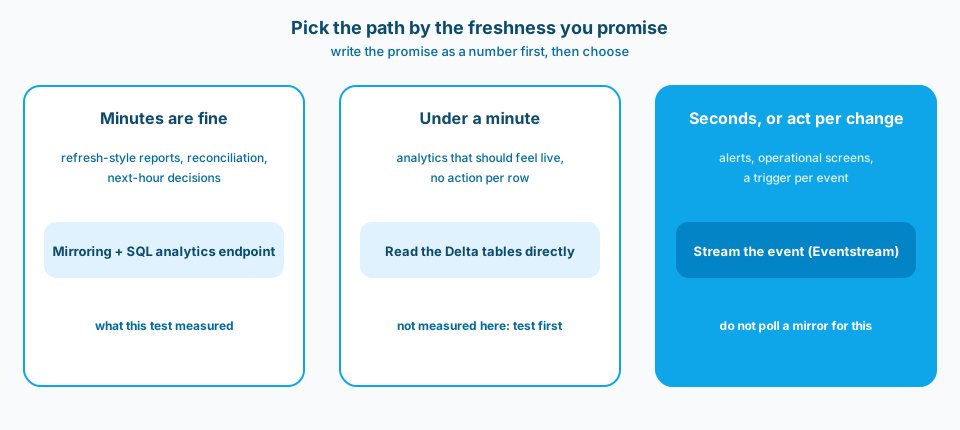
Figura 5. Acordad primero la cifra de frescura. La cifra elige el camino, no al revés.
Cuándo basta el mirroring y cuándo necesitas un stream
Mirroring más SQL analytics endpoint es una buena opción por defecto cuando los minutos son aceptables: informes sobre datos operativos, conciliación y análisis que no disparan una acción por fila. No hay que construir ningún pipeline, y las FAQ de Microsoft indican que el mirroring de una Fabric SQL database a OneLake no tiene coste de cómputo, y que el almacenamiento del mirroring es gratuito hasta un límite que depende de la capacidad (FAQ de mirroring). Tus consultas en el endpoint se facturan como siempre. El consumo de capacidad de esta prueba aún no está medido; cuando llegue, será el coste del arnés de pruebas (consultas al endpoint y notebooks), no de la replicación.
Es la herramienta equivocada cuando alguien necesita reaccionar en segundos: una alerta, una pantalla operativa, un flujo que se dispara con cada cambio. Sondear un mirror cada pocos segundos no puede ganar a un ciclo que se mide en minutos. Pon el evento en un stream allí donde se produce, con Eventstream hacia un Eventhouse o Activator (visión general de Eventstream), y deja el mirroring para la copia analítica.
En medio queda "debe sentirse en vivo, pero nadie actúa por fila". Los motores que leen directamente las tablas Delta de OneLake, como Spark o un modelo Direct Lake, se saltan la sincronización del SQL analytics endpoint. Como aquí cada cambio estaba en Delta en unos 30 segundos, pueden ver los cambios mucho antes que el endpoint (Direct Lake una vez que hace reframe, por ejemplo con las actualizaciones automáticas activadas). No probé ese camino, así que pruébalo antes de prometerlo.
Cómo vigilarlo
Estas son las vías de monitorización que se aplican al mirror de una Fabric SQL database:
- Portal: en la SQL database, la pestaña Replication y luego Monitor replication muestran el estado actual, las filas replicadas y el último refresh (monitorizar el mirroring).
- DMV del origen: sys.dm_change_feed_log_scan_sessions para los tiempos de captura y sys.dm_change_feed_errors para los fallos (FAQ de mirroring).
- Lado del endpoint: la llamada REST Refresh SQL endpoint metadata devuelve un lastSuccessfulSyncDateTime por tabla (Refresh SQL endpoint metadata). También dispara una sincronización, así que trátala como una acción, no como una lectura pasiva.
- Una fila de heartbeat: la única que mide lo que nota un usuario. Ver más abajo.
La llamada REST getMirroringStatus no se aplica aquí. Pertenece a los elementos de tipo mirrored database (Get Mirroring Status), mientras que la API de SQL database solo ofrece Start y Stop para el mirroring (API de mirroring de SQL database). Un 404 para una SQL database es lo esperado.
Errores comunes
- Tratar "near real-time" como una cifra. Microsoft no publica ningún intervalo para esto. Mide el tuyo.
- Ajustar el origen. Una captura más rápida no sirve cuando el retraso es el endpoint recogiendo los commits de Delta.
- Medir solo con recuentos de filas. Los recuentos acaban convergiendo y ocultan la dispersión por fila. Una fila de heartbeat con marca de tiempo muestra el diente de sierra.
- Dejar que una caché responda a la sonda. Si cada sondeo es la misma consulta, un resultado en caché puede hacer que la frescura parezca peor o mejor de lo que es. Varía el predicado.
- Informar de la mejor ejecución, o del p95 como peor caso. En esta prueba, las medianas por ejecución fueron de 98 a 218 segundos con el mismo entorno. Informa de todas las ejecuciones, del p95 con su método y del máximo como peor caso.
- Leer una tendencia en un orden fijo. Si las tasas se ejecutan siempre en el mismo orden, cualquier tendencia por tasa es también una tendencia por posición. Baraja el orden en cada ronda.
Úsalo tal cual o adáptalo
Una tabla de heartbeat es la forma más barata de conocer tu latencia real y de alertar cuando se desvía. En la Fabric SQL database:
-- datetime2(6): mirrored Delta and the SQL analytics endpoint keep six fractional digits; (7) would be trimmed
CREATE TABLE dbo.heartbeat (
    id            bigint       NOT NULL PRIMARY KEY,
    committed_utc datetime2(6) NOT NULL
);

-- run on a schedule, for example every minute
INSERT INTO dbo.heartbeat (id, committed_utc)
SELECT ISNULL(MAX(id), 0) + 1, SYSUTCDATETIME() FROM dbo.heartbeat;
En el SQL analytics endpoint:
SELECT MAX(committed_utc) AS last_seen_commit_utc,
       DATEDIFF(second, MAX(committed_utc), SYSUTCDATETIME()) AS staleness_s
FROM dbo.heartbeat;
Si staleness_s supera la cifra que prometiste más el intervalo del heartbeat (aquí 60 s), lo sabes antes que el stakeholder. La nota de los seis dígitos sale del límite de precisión de Delta en las limitaciones del mirroring y de la página de tipos de datos. Intervienen dos relojes, el del origen y el del endpoint; en mis ejecuciones el desfase fue inferior a 4 ms, pero comprueba el tuyo antes de fiarte de cifras de un solo dígito en segundos.
Notas de método y salvedades
- Medido en un trial de Fabric de 64 CU, no es una afirmación sobre un F64 de pago ni sobre producción: 153 marcadores, 9 ejecuciones, una tarde, una región, una base de datos, una tabla.
- Durante las ejecuciones corría en la misma capacidad trial un build derivado de TPC-H, así que no se pueden descartar efectos de vecinos ruidosos.
- Las cifras de captura salen de la muestra de la DMV de las ejecuciones 7 a 9 (41 marcadores), no de toda la noche. Las cifras de Delta cubren los 153 marcadores.
- Las horas de commit en Delta son el lastModified de los archivos de log en OneLake (resolución de 1 segundo), porque el replicador no escribe marca de tiempo en commitInfo.
- Con 17 marcadores, el p95 de cada ejecución coincide con su máximo, así que solo se informa del p95 agregado por tasa.
- Tipo de sincronización: sin confirmar.
- 3 ejecuciones por tasa, siempre en el mismo orden, así que no hay ninguna conclusión sobre la tasa.
- El p95 es por rango más cercano, ceil(0.95 × n). El máximo es el peor caso.
- Consumo de capacidad (CU): aún sin medir. Una cifra posterior cubrirá el arnés de pruebas (consultas al endpoint y notebooks), no la replicación.
- El caso en reposo (en frío) no se ejecutó.
- La latencia es de extremo a extremo a través del SQL analytics endpoint. Quien lea directamente la tabla Delta puede ver los cambios mucho antes; no se probó aquí.
Pruébalo tú
La demo de latencia del mirroring de mi repositorio público tech-demos carga una Fabric SQL database, ejecuta la carga de 10, 100 y 1,000 filas por segundo con marcadores de heartbeat y sondea el SQL analytics endpoint, para que puedas medir la latencia en tu propia capacidad.
Relacionado
- Siguiente en la serie del trial: Motores de Fabric con 1B filas: elige por forma de consulta, con la misma capacidad trial cronometrando cuatro motores sobre mil millones de filas en lugar de medir la frescura.
- Refresh semántico y Direct Lake para la otra cara de "¿cuándo ve un informe los datos nuevos?".
- Runbooks de Fabric Monitor para convertir un heartbeat en una alerta con un responsable.