
Puntos clave
- Las respuestas de Fabric IQ en Microsoft 365 Copilot Chat están disponibles de forma general, y la opción de administración que las habilita viene activada por defecto. A tus modelos publicados ya se les pueden hacer preguntas.
- Arregla el modelo antes de escribir prompts. Una medida revisada gana a cualquier instrucción.
- El AI data schema enfoca a Copilot. No es seguridad, y algunas capacidades lo ignoran.
- Las verified answers no se devuelven cuando Fabric IQ está activado. No bases la corrección de Copilot Chat en ellas.
- Condiciona la aprobación a un conjunto de preguntas con resultados esperados validados.
- Prep data for AI está en preview, necesita Q&A activado y necesita un refresco en el servicio después de un despliegue por Git o pipeline.
Un caso hipotético, pero probable. Alguien pregunta a Copilot Chat cómo le fue al negocio el último trimestre. Copilot encuentra un modelo que nadie preparó para él, elige la cifra bruta en lugar de la neta, usa trimestres naturales cuando el negocio reporta por trimestres fiscales y responde con total seguridad. Ningún refresco falló. Ningún informe se rompió. Y aun así la respuesta es incorrecta.
Los modelos se construyeron para autores de informes que ya conocen el negocio. Copilot no lo conoce. Da forma al modelo, acota lo que ve Copilot, guíalo con el menor texto posible y pruébalo antes de aprobarlo.
Modelo con nombre: dar forma → acotar → guiar → probar
- Dar forma: medidas explícitas, relaciones reales, una tabla de fechas marcada, nombres claros y descripciones.
- Acotar: un AI data schema para enfocar; seguridad a nivel de fila y de objeto (RLS, OLS) para el acceso.
- Guiar: AI instructions breves; verified answers solo donde de verdad se activan.
- Probar: un conjunto de preguntas con resultados esperados y, después, Approved for Copilot.
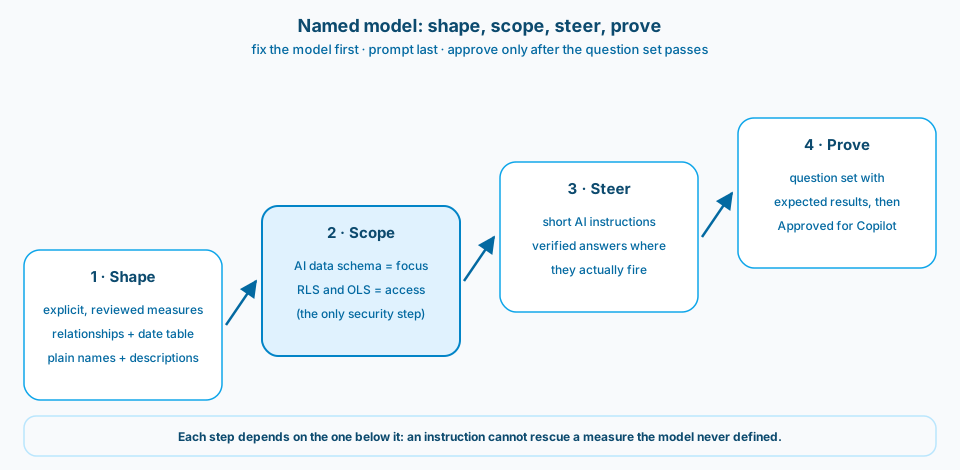
Figura 1. Solo el paso de acotar aporta seguridad. Solo el paso de probar se gana la marca de aprobación.
Contexto y restricción
En Copilot Chat, Copilot busca un informe relevante y responde a partir del semantic model que hay debajo, con los permisos del propio usuario, RLS y OLS incluidos. Las respuestas reflejan el último refresco correcto. Los modelos en capacidades Embedded (A o EM) no son compatibles, y las preguntas deben hacerse en un idioma compatible con Microsoft 365 Copilot (Fabric IQ in Microsoft 365 Copilot Chat).
Cuando abro un modelo pensando en Copilot, suelo encontrar lo mismo: números que solo existen como sumas implícitas de columnas, casi ninguna descripción, sinónimos generados automáticamente que nadie ha revisado y nada preparado para IA. Nada de eso bloquea un informe. Todo eso confunde a un chat. Así es como yo prepararía y validaría un modelo así. El post 13 cubre los fundamentos del modelado; esta nota cubre las herramientas de Power BI y sus aristas.
Diseño
1. Da forma al modelo antes de escribirle prompts
Si la gente pregunta por un número, debería existir como medida revisada con un nombre claro y una descripción. Cuando la medida A es neta y la medida B es bruta y ninguna está descrita, Copilot elegirá una y no te dirá que ha adivinado. Learn cita los nombres crípticos, la falta de descripciones, los campos con el mismo nombre en varias tablas y las tablas desconectadas, como los parámetros de campo, como causas habituales de malas respuestas (Copilot with semantic models).
Una expectativa que conviene fijar: hoy las descripciones solo alimentan las consultas DAX y las capacidades de búsqueda (Prep data for AI FAQ). Escríbelas de todos modos, pero no esperes que por sí solas arreglen las respuestas.
2. Acota para enfocar, protege con RLS y OLS
Prep data for AI está en preview (Prep data for AI), y el orden que recomienda Microsoft es AI data schema, luego verified answers y luego AI instructions (FAQ anterior). El esquema reduce los campos a los que Copilot da prioridad. El propio ejemplo de Learn quita una medida que compite con otra para que "ventas" se resuelva con la que el equipo usa de verdad.
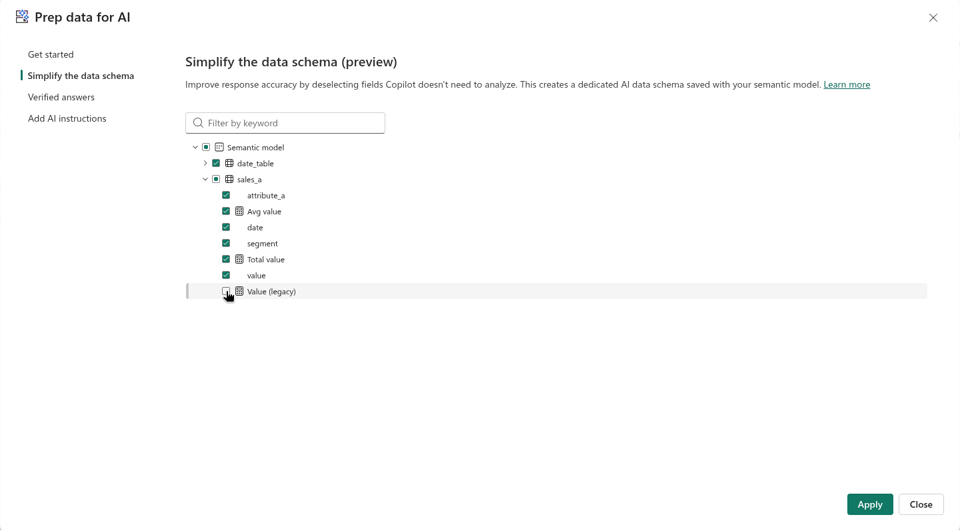
Figura 2. En un modelo de demostración pequeño, la medida competidora Value (legacy) está desmarcada para que el AI data schema dirija a Copilot hacia Total value.
La arista: crear una página de informe o escribir una consulta DAX sigue usando el modelo entero, no el esquema (AI data schemas). Un campo que dejas fuera del esquema no queda oculto para nadie. Si un usuario no debe verlo, eso es cosa de RLS u OLS.
3. Guía con instrucciones breves que apunten a objetos reales
Las AI instructions están limitadas a 10,000 caracteres, y Learn dice claramente que no hay garantía de que Copilot las siga al pie de la letra (AI instructions). Así que las limito a valores por defecto y desambiguación, agrupadas por tema:
Metrics
- "Sales" without a qualifier means [Measure A] (net, after returns).
- Use [Measure B] only when the user asks for gross.

Dates
- Use the fiscal calendar on the Date table unless the user asks otherwise.

Ambiguity
- If "performance" could mean volume, value, or margin, ask which measure.
Cada línea nombra algo que el modelo ya define. Una instrucción que describe un cálculo que el modelo no tiene es una medida que todavía debes.
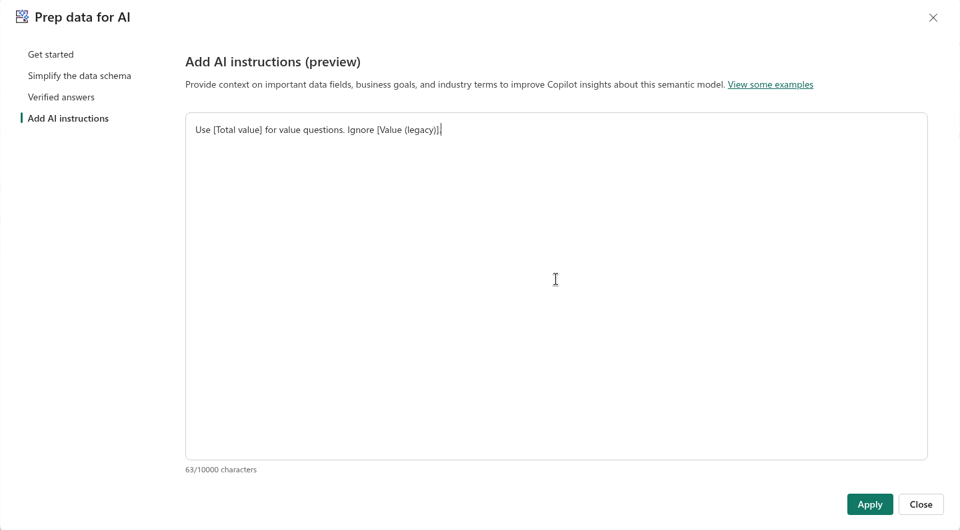
Figura 3. Para el modelo de demostración bastó una línea: nombrar la medida que hay que usar y la que hay que ignorar.
4. Usa verified answers donde se activan
Las verified answers asocian frases desencadenantes a un objeto visual revisado. La limitación más importante está en la misma página de Learn que los pasos de configuración: Copilot no devuelve verified answers cuando Fabric IQ está activado (verified answers). Además, dejan de coincidir si se oculta un campo que usan, no funcionan con medidas de informe, no las transporta la integración con Git ni los deployment pipelines y no son una función de seguridad para datos con RLS u OLS.
Por eso las trato como una herramienta del panel de Copilot del informe, para un puñado de preguntas muy frecuentes. La corrección en Copilot Chat vive en las medidas y en las instrucciones.
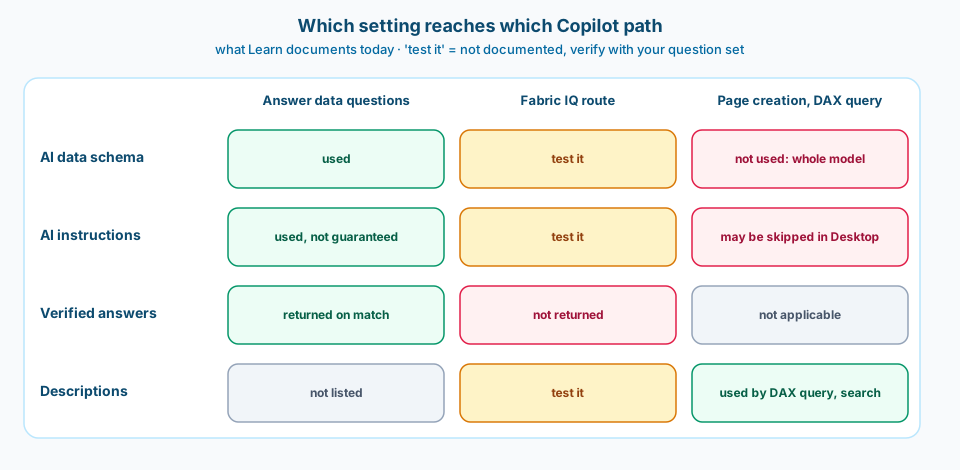
Figura 4. Lo que Learn documenta hoy. "Test it" marca los huecos que tu conjunto de preguntas tiene que cubrir, y las verified answers nunca llegan a la ruta de Fabric IQ.
5. Pruébalo y luego apruébalo
Antes de que nadie marque el modelo como aprobado, escribe las preguntas con la respuesta que esperas, como recomienda Learn (Ask data questions with Copilot and Fabric IQ). Incluye al menos una pregunta ambigua a propósito, porque la respuesta correcta a esa pregunta es otra pregunta para aclararla.
question                       | measure   | grouping | date basis     | expected
Sales last quarter             | Measure A | none     | fiscal quarter | validated value
Top three categories by sales  | Measure A | category | fiscal year    | validated list
How is performance?            | (ask)     | none     | none           | clarifying question
Ejecútalo en las superficies que usa la gente, lee "How Copilot arrived at this" en cada respuesta y solo entonces marca el modelo como Approved for Copilot. La aprobación elimina el aviso de precaución que Copilot independiente añade a las respuestas de elementos no aprobados, para el modelo y para todos los informes que dependen de él. Es una promesa a los usuarios, no un trámite. Cuenta con hasta una hora para que se aplique, o hasta un día en modelos con muchos informes (Prep data for AI). Es la misma puerta que en el post 48, aplicada a un modelo.
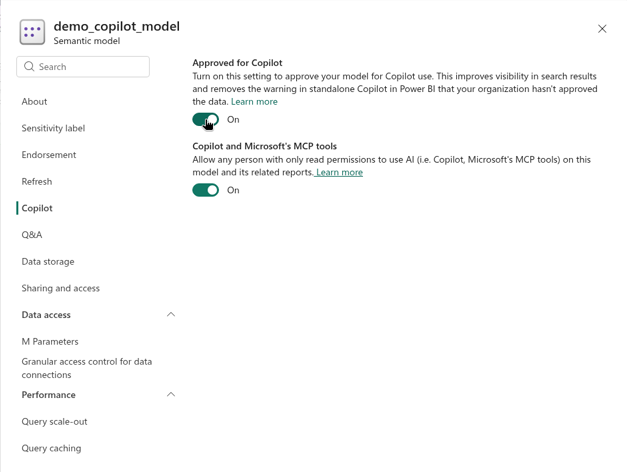
Figura 5. Approved for Copilot está en la configuración del modelo, bajo Copilot. Actívalo solo cuando el conjunto de preguntas pase.
Lo probé en un modelo de demostración pequeño con 60 filas sintéticas, después de desmarcar la medida heredada y añadir la instrucción de una línea. Ante la pregunta "What is the total value by segment?", Copilot independiente devolvió los mismos tres valores que esperaba mi comprobación con DAX, y "How Copilot arrived at this" mostró que usó segment y Total value sin filtros, no la copia heredada.
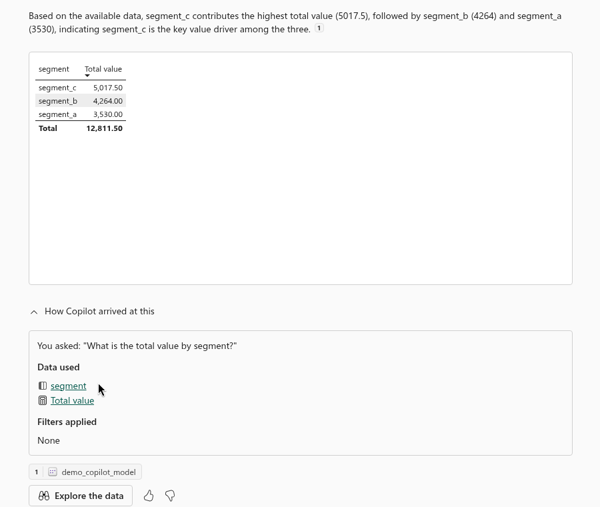
Figura 6. La respuesta coincidió con los valores esperados, y el panel de razonamiento muestra qué medida eligió Copilot.
Haz las preguntas de negocio en Copilot independiente. El panel de Copilot dentro del editor de modelos sirve para ayudar con el modelado: rechazó la misma pregunta y me ofreció ayuda para crear una medida. Un efecto secundario que conviene conocer: cuando abrí el modelo en modo de edición en la web, se convirtió al formato de almacenamiento de modelos semánticos grandes, como muestra el banner de la figura 7.
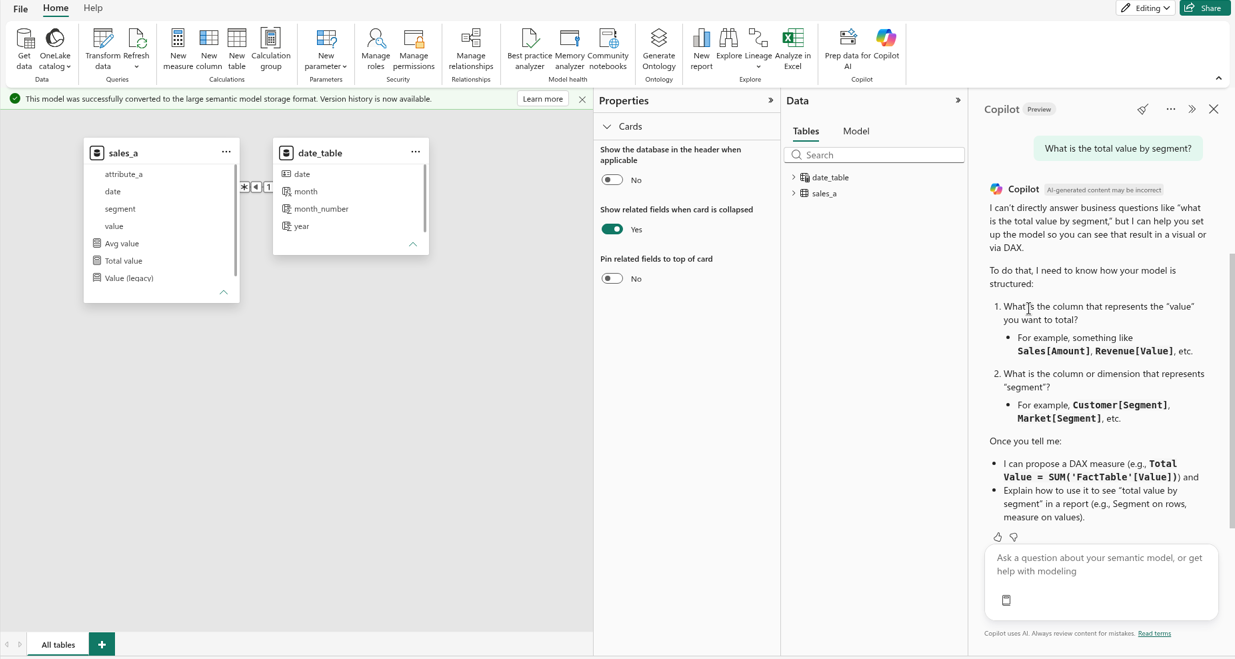
Figura 7. El Copilot del editor de modelos rechaza las preguntas de negocio. Fíjate en el banner del formato de almacenamiento en la parte superior.
6. Publícalo como un cambio de modelo
Las AI instructions y el AI data schema viven en los metadatos lingüísticos del modelo. Después de un cambio por Git o por un deployment pipeline, Learn dice que tienes que refrescar el modelo en el servicio para sincronizarlo, y para los modelos DirectQuery y Direct Lake añade "but only once a day". Power BI Desktop solo permite editar Prep data for AI en modelos Import, DirectQuery y compuestos locales, así que los modelos Direct Lake se preparan en el servicio (misma página). Un despliegue por Git no es el final del release: planifica el refresco y después ejecuta el conjunto de preguntas.
Dos líneas para la lista de comprobación. Prep data for AI requiere Q&A en el modelo, mientras que las experiencias de Q&A se retiran en febrero de 2027 (Q&A best practices): quita los objetos visuales de Q&A, pero mantén la opción. Y si los nombres del modelo o los sinónimos no están en inglés, prueba en el idioma en el que la gente va a preguntar de verdad. Learn dice que Copilot funciona mejor con nombres en inglés fáciles de leer, y los sinónimos viven en los metadatos lingüísticos de cada referencia cultural del modelo, así que revisa la que la gente va a usar realmente.
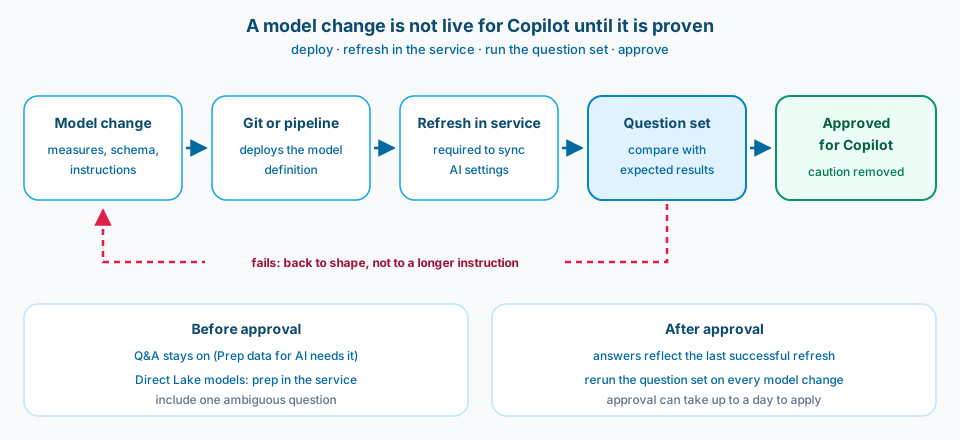
Figura 8. Un cambio de modelo no está activo para Copilot hasta que el servicio lo ha sincronizado y el conjunto de preguntas ha pasado.
Errores comunes
Escribir prompts para tapar una medida que falta. Una instrucción no puede arreglar un número que el modelo nunca definió.
Bruto y neto uno al lado del otro, sin describir. Copilot elige uno, con toda seguridad.
El esquema como seguridad. Enfoca las respuestas. RLS y OLS restringen los datos.
Las verified answers como plan para Copilot Chat. Con Fabric IQ activado, no se devuelven.
Ocultar un campo que usa una verified answer. La respuesta deja de coincidir sin avisar.
Aprobar antes de probar. La marca de aprobación elimina el aviso que los usuarios verían en otro caso.
Desactivar Q&A durante una limpieza. Las pestañas de Prep data for AI dejan de funcionar.
Probar antes del refresco en el servicio. Copilot sigue leyendo las instrucciones antiguas.
Úsalo tal cual o adáptalo
Úsalo tal cual
- El orden dar forma, acotar, guiar, probar.
- Una medida revisada y descrita para cada número por el que pregunta la gente.
- RLS y OLS como única frontera de seguridad.
- Un conjunto de preguntas con resultados esperados, con al menos una ambigua, antes de aprobar.
Adáptalo antes de usarlo
- Cuántas verified answers crear, según la gente pregunte en Copilot Chat o en el panel del informe.
- Cuánto crecen las instrucciones: empieza con valores por defecto y añade solo lo que las pruebas demuestren necesario.
- Tu ritmo de releases para Direct Lake y DirectQuery, teniendo en cuenta la nota del refresco una vez al día.
- Cuándo dejar de estirar un modelo y publicar en su lugar un Fabric data agent, por ejemplo cuando las preguntas necesitan datos de un lakehouse o un warehouse (semantic model best practices for data agent).
Relacionado
- Preparación de data agents: ¿Genie (y los agentes de Fabric) es en realidad un problema de modelado? (los fundamentos de modelado que hay debajo de esta nota)
- Contrato semántico de gold: ¿puedes elegir qué columnas llegan al modelo Direct Lake? (lo que llega al modelo en primer lugar)
- Direct Lake: ¿todavía hay que refrescar un semantic model? (por qué importa el paso de sincronización)
- Evaluaciones de agentes: ¿puede una puntuación bloquear un release? (la misma puerta para agentes)
Copilot va a leer tu modelo lo hayas preparado o no. Prepáralo y luego pruébalo.