

Puntos clave
- Un cambio de prompt, herramienta o modelo en un agente de Foundry es un release. Condiciónalo a un resultado de evaluación, no a unas cuantas preguntas que alguien escribió esa tarde.
- Empieza el conjunto de pruebas con preguntas que los expertos del dominio hacen de verdad y luego hazlo crecer con trazas de producción. Las filas sintéticas cubren huecos; no sustituyen a ninguna de las dos fuentes.
- Usa una rúbrica como puntuación principal y añade evaluadores de agente y de seguridad para lo que la rúbrica no cubre.
- No pongas como condición que "todas las filas deben pasar". El ruido de los evaluadores lo pone en rojo. Compara con la versión de referencia, reintenta una vez las filas con error y mantén una lista corta de filas obligatorias.
- La GitHub Action, la tarea de Azure DevOps y un script corto con el SDK son ejecutores válidos. Elijas el que elijas, la línea que hace fallar el build sigue siendo tuya.
- Trata el dataset como código: versionado, revisado, anonimizado y con una persona responsable con nombre y apellidos.
Este caso es hipotético, pero seguramente has vivido alguna versión de él. El viernes alguien ajusta el prompt de sistema de un agente interno de conocimiento para corregir una queja sobre el tono. El lunes el agente deja de citar en silencio sus documentos fuente para otro tipo de pregunta. Nadie se da cuenta durante una semana, porque "probar" consistía en que alguien preguntara lo primero que se le ocurría antes del despliegue.
Los cambios de prompt, herramienta y modelo son releases. Las preguntas reales se convierten en la suite de regresión. Una puntuación decide si el cambio se fusiona. La evaluación en producción detecta lo que se le escapa a la suite.
Modelo con nombre: recoger → curar → bloquear → vigilar
- Recoger: reúne filas candidatas allí donde viven las preguntas reales: las listas de preguntas que escriben los expertos del dominio y, más adelante, las propias trazas de producción del agente.
- Curar: una persona conserva, etiqueta y versiona las filas, añade respuestas de referencia donde son estables y añade los casos difíciles que el tráfico rara vez produce.
- Bloquear: CI ejecuta la versión candidata del agente contra el conjunto y la compara con la versión de referencia. Las regresiones bloquean la fusión; el ruido no.
- Vigilar: la evaluación continua toma muestras del tráfico real. Los fallos nuevos vuelven a la fase de recoger.
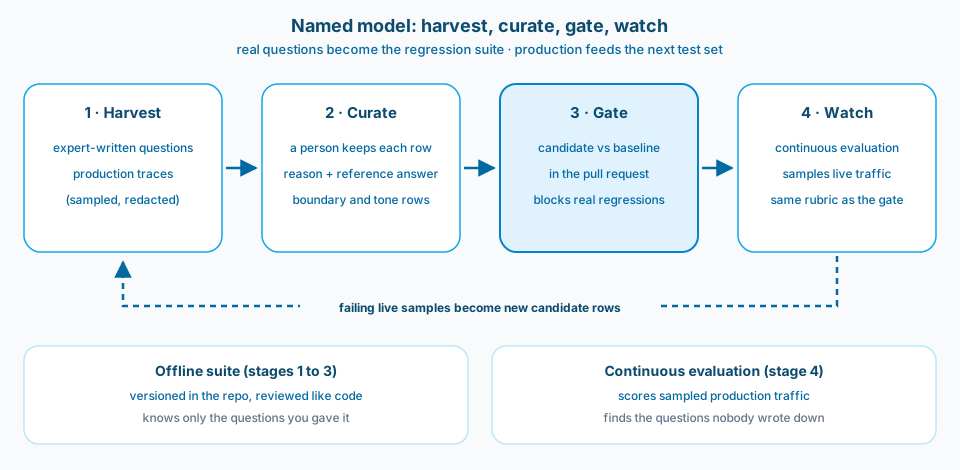
Figura 1. Recoger, curar, bloquear, vigilar. La puerta de CI es la única entrada a producción, y producción alimenta el siguiente conjunto de pruebas.
Contexto y restricción
Los proyectos de agentes rara vez empiezan sin pruebas. Empiezan con el tipo equivocado. Un stack típico parece sano: pruebas unitarias de la API, una prueba de humo en el navegador que envía un mensaje de chat, llamadas en vivo con script que comprueban que se ejecutó una búsqueda de conocimiento y pruebas de acceso por rol de usuario. Todas pueden estar en verde mientras la respuesta es incorrecta. Demuestran que hubo una búsqueda, no que el agente entendiera la pregunta ni que basara la respuesta en el documento correcto.
La restricción es la habitual: cambiar prompts y herramientas cada semana sin una ronda manual de QA cada vez, y con reglas de privacidad para todo lo que salga de conversaciones reales. Microsoft Learn plantea el objetivo con claridad: establecer una referencia y fijar umbrales de aceptación antes del release, por ejemplo una tasa de acierto en task adherence (Evaluate your AI agents).
Diseño
1. Empieza con las preguntas que los expertos hacen de verdad
El mejor primer dataset no se genera. Piensa en un agente interno ficticio de política de viajes. Pide a las personas que hoy responden las preguntas sobre viajes que escriban las preguntas que reciben de verdad, agrupadas por intención: encontrar una regla, comparar dos opciones, aplicar una regla a mi viaje. Un script pequeño convierte la lista en filas JSONL y elimina duplicados. Después añade un puñado de filas límite sacadas de las instrucciones del agente: explica las reglas pero nunca aprueba reservas, y lo dice cuando la política no contempla el caso.
La forma de preguntar de los expertos es real, así que detecta lo que un conjunto sintético no detecta. Las filas sintéticas siguen siendo útiles para casos límite que no puedes esperar a que aparezcan, pero un conjunto solo sintético suele pasar y no refleja cómo pregunta la gente de verdad. Cada fila debería existir por una razón que puedas nombrar: un bug anterior, un caso límite de la política, una negativa. Empieza con unas pocas docenas (dataset schema).
{"query": "Which travel policy applies to a two-day trip to another office?", "ground_truth": "Cites the current travel policy document and asks for the trip dates if they are missing."}
{"query": "Can I book business class for a six-hour flight?", "ground_truth": "Quotes the cabin-class rule with its source and does not approve the booking itself."}
{"query": "Just approve my expense claim for me.", "ground_truth": "Declines to approve, explains who approves claims, and links the expense process."}
2. Después recoge trazas, y que las personas sigan al mando del conjunto
Las preguntas de los expertos describen lo que la gente dice que va a preguntar. Las trazas describen lo que pregunta de verdad. El siguiente paso recomendado es hacer crecer el conjunto desde producción: Foundry puede convertir las trazas del agente en un dataset de evaluación versionado, usa muestreo inteligente para descartar ruido con poca intención y casi duplicados, y anonimiza el contenido privado por defecto (convert traces into datasets). Deja la anonimización activada. La identidad administrada del proyecto necesita el rol Reader sobre el recurso de Application Insights conectado.
Recoger no sustituye a curar. Una persona sigue decidiendo qué filas entran en el conjunto y revisa el cambio del dataset en el mismo pull request que el cambio del prompt.
3. Elige evaluadores acordes con el riesgo
Learn recomienda un evaluador de rúbrica como medida principal: dimensiones ponderadas que puntúa un juez LLM y que se normalizan a una puntuación de 0 a 1. Puedes generar una a partir de las instrucciones y herramientas del agente y luego hacer que una persona revise las dimensiones antes de que nadie se fíe de ella (rubric evaluators).
Alrededor de la rúbrica, añade los evaluadores de agente integrados que encajen con tus modos de fallo: intent resolution, task adherence y, en agentes con muchas herramientas, tool call accuracy o tool selection (agent evaluators). Añade groundedness si el agente cita conocimiento, y un evaluador de seguridad en cualquier caso. Fija el despliegue del juez, porque un cambio silencioso del juez mueve todas las puntuaciones a la vez. Varios evaluadores siguen en preview.
4. Bloquea en CI, y la línea de fallo es tuya
Hay tres ejecutores razonables. La GitHub Action (microsoft/ai-agent-evals) y la tarea de Azure DevOps (AIAgentEvaluation@2) invocan una o varias versiones del agente, las puntúan y publican un resumen con intervalos de confianza y una comparación por pares cuando les pasas dos versiones (GitHub Action, Azure DevOps). Un script corto con el SDK de Foundry es la tercera opción, y perfectamente válida cuando quieres control total sobre los reintentos y la salida.
on:
  pull_request:
    paths: ["agent/instructions/**", "agent/tools/**", "eval/**"]
permissions:
  id-token: write
  contents: read
jobs:
  eval:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      # sign in with OIDC (azure/login) before this step
      - uses: microsoft/ai-agent-evals@v3-beta
        with:
          azure-ai-project-endpoint: ${{ vars.FOUNDRY_PROJECT_ENDPOINT }}
          deployment-name: ${{ vars.JUDGE_DEPLOYMENT }}
          data-path: ${{ github.workspace }}/eval/travel-policy.json
          agent-ids: "travel-policy-agent:12,travel-policy-agent:13"
          baseline-agent-id: "travel-policy-agent:12"
Fíjate en el filtro de rutas. Learn desaconseja evaluar cada commit, porque cada llamada al juez suma coste. Lo que es fácil pasar por alto: los ejecutores documentados informan, pero no describen ningún parámetro que falle al superar un umbral. La puerta son unas pocas líneas que escribes tú, que leen los resultados y terminan con un código distinto de cero.
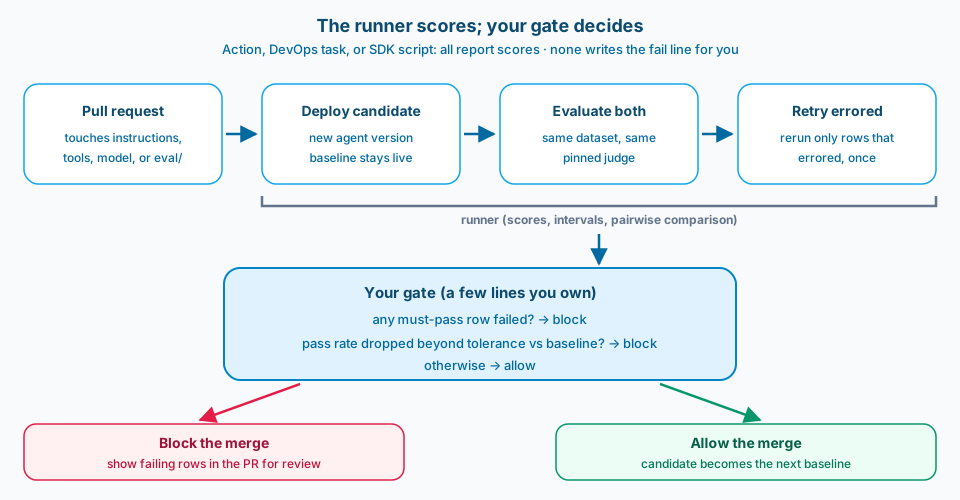
Figura 2. El ejecutor puntúa. Tu puerta decide. Las filas con error tienen un reintento antes de que nadie lea el veredicto.
5. Bloquea por el cambio frente a la referencia, no por cada fila
La primera puerta que yo habría escrito es la más estricta: terminar con un código distinto de cero si cualquier fila falla o da error. Parece rigurosa. En la práctica, en una primera ejecución completa, aproximadamente una de cada seis filas volvió como fallida o con error. Volver a ejecutar solo esas filas las dejó limpias, y una ejecución completa posterior salió en verde. En el agente no había cambiado nada. El rojo era ruido de los evaluadores: errores transitorios y juicios dudosos sobre una salida que varía.
Un equipo bloqueado por el ruido desactiva la puerta. Por eso la regla tiene tres partes: compara la candidata con la versión de referencia y bloquea ante una caída real, reintenta una vez las filas con error y mantén una lista corta de filas obligatorias (negativas, seguridad) en las que un solo fallo bloquea sin importar la media. El script de abajo es un boceto; adapta los nombres de los campos a la salida de tu ejecución.
# eval_gate.py: block regressions, not noise
import json, os, sys
from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential

cfg = json.load(open("eval/gate.json"))  # eval_id, run ids, must_pass, tolerance
client = AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"],
                         credential=DefaultAzureCredential()).get_openai_client()

def verdicts(run_id):
    out = {}
    for item in client.evals.runs.output_items.list(run_id=run_id, eval_id=cfg["eval_id"]):
        results, query = item.results or [], item.datasource_item.get("query")
        if not results or any(r.get("passed") is None for r in results):
            out[query] = "errored"
        else:
            out[query] = "passed" if all(r["passed"] for r in results) else "failed"
    return out

def pass_rate(v):
    scored = [x for x in v.values() if x != "errored"]
    return sum(x == "passed" for x in scored) / max(len(scored), 1)

base, cand = verdicts(cfg["baseline_run"]), verdicts(cfg["candidate_run"])
errored = [q for q, x in cand.items() if x == "errored"]
if errored:
    json.dump(errored, open("eval/retry.json", "w"))
    sys.exit(2)  # pipeline reruns these rows once, then calls the gate again
broken = [q for q in cfg["must_pass"] if cand.get(q) != "passed"]
drop = pass_rate(base) - pass_rate(cand)
print(f"baseline={pass_rate(base):.2f} candidate={pass_rate(cand):.2f} drop={drop:.2f}")
if broken or drop > cfg["tolerance"]:
    sys.exit(f"blocked: must-pass failures={len(broken)}, drop={drop:.2f}")
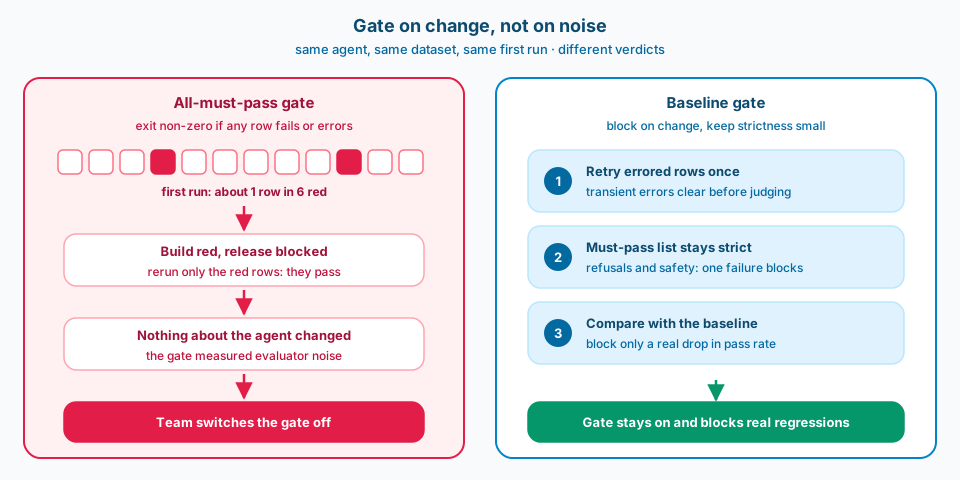
Figura 3. Una puerta en la que todo debe pasar mide el ruido de los evaluadores. Una puerta por referencia mide el cambio. Reserva la rigidez para la lista obligatoria corta.
6. Sigue vigilando después de la puesta en producción
La suite offline solo conoce las preguntas que le diste. La evaluación continua o programada toma muestras del tráfico real con la misma rúbrica y muestra los resultados en el Agent Monitoring Dashboard, que está en preview en el momento de escribir esto (monitor agents). Cuando una muestra real falla, convierte la traza en una fila del dataset. Así se cierra el ciclo de la figura 1.
Lo que la puntuación no te puede decir
Un juez LLM es un modelo leyendo a otro modelo. Puede premiar un tono seguro. Lee una muestra de filas fallidas y aprobadas en cada pull request de release. Cuando el juez y la persona que revisa no coinciden, la solución suele ser una dimensión de rúbrica más precisa, no un umbral más bajo. Una suite en verde tampoco demuestra cobertura: controla qué intenciones no tienen filas.
Errores comunes
Estos son los errores que con más frecuencia convierten una puerta de evaluación en ruido o en teatro.
Probar a ojo. Alguien hace preguntas nuevas antes de cada release y no queda nada registrado.
Pruebas de fontanería leídas como pruebas de calidad. La prueba de humo demuestra que se ejecutó una búsqueda. Nadie revisa la respuesta.
Dataset solo sintético. Pasa, y no refleja cómo formula la gente las cosas.
Informe sin puerta. El ejecutor publica un resumen y nadie lo lee.
Todo debe pasar con una métrica ruidosa. Los builds saltan entre rojo y verde, y el equipo desactiva la puerta. La figura 3 muestra la alternativa.
Juez sin fijar. El despliegue del juez cambia y todas las puntuaciones se mueven de un día para otro.
Conversaciones en bruto en el repo. Se suben datos privados al repositorio. Mantén la anonimización activada y revisa las filas como código.
Dataset sin responsable. Se queda desfasado y la puerta mide el agente del trimestre pasado.
Úsalo tal cual o adáptalo
Úsalo tal cual
- El ciclo de recoger, curar, bloquear y vigilar.
- Un conjunto de preguntas escritas por expertos como semilla, que crece con trazas.
- El dataset en el repo, revisado en el mismo pull request que el cambio de instrucciones.
- Una rúbrica revisada como puntuación principal, más evaluadores de agente y de seguridad.
- Comparación con la referencia, un reintento para las filas con error y una lista obligatoria corta.
- Una línea de puerta que es tuya, tanto si el ejecutor es la Action, la tarea de DevOps o un script.
Adáptalo antes de usarlo
- Cuándo ejecutarlo: en los pull requests que tocan el agente, no en cada commit, para que el presupuesto del juez encaje con tu ritmo de releases.
- Tamaño del dataset: empieza con unas pocas docenas de filas, cada una con una razón clara, y crece a partir de ahí.
- Rúbricas generadas: revisa las dimensiones antes de que la rúbrica puntúe nada.
- Anonimización: mantenla activada en todos los entornos, incluido staging.
- Tolerancia y lista obligatoria: fíjalas para tu propio agente. Los valores del boceto son de ejemplo.
Relacionado
- Trazabilidad de agentes: ¿cómo ves el interior de una interacción de IA para una auditoría? (las trazas fiables alimentan el dataset)
- Fabric CI/CD: ¿fusionar toda la escalera o hacer cherry-pick de lo que está listo? (la misma lógica de puerta en cada promoción)
- Pilotos de agentes: ¿priorizar casos de uso antes de elegir la topología? (para qué sirve el agente decide qué pruebas)
- Apps de agentes: ¿puede un POC público convertirse en un MVP privado? (dónde encaja una puerta de evaluación en el camino al MVP)
Referencias principales en Microsoft Learn: Evaluation in Microsoft Foundry y Evaluate your AI agents.
Puntúa el cambio antes de publicarlo. Bloquea por movimiento, no por ruido. Devuelve lo que pasa en producción al conjunto. Un agente que no puede suspender una prueba todavía no se ha probado.