

Puntos clave
- Prioriza los casos de uso antes de elegir modelos, herramientas o topologías multiagente.
- Para cada trabajo: agente único, orquestador más especialistas o primero herramientas, con su justificación.
- Activa code interpreter, exportación, navegación y búsqueda MCP solo donde el trabajo lo necesite.
- Traza los límites A2A como los traspasos entre personas, las escaladas y las líneas de auditoría.
- Evalúa los pilotos por la calidad de las decisiones y la claridad de los traspasos, no por paneles de tokens.
- Ninguna identidad en el catálogo hasta que exista una ficha de caso de uso con responsable, scorecard y topología.
Los programas de agentes en empresas suelen empezar con un menú: modelos, herramientas y quizá un diagrama multiagente copiado de una keynote. El catálogo da sensación de avance. Los usuarios siguen sin saber qué trabajo debe terminar el sistema.
Empieza por casos de uso priorizados. Decide para cada trabajo entre orquestador, agente único o herramientas. Prueba en un piloto la calidad de las decisiones y la claridad de los traspasos antes de apostar la plataforma por una topología que quedaba bien en una diapositiva.
Modelo con nombre: el caso de uso antes que la topología
- Trabajos priorizados: escribe el usuario, las fuentes de evidencia, la decisión o el artefacto y el coste de un fallo. Ordena por valor y madurez.
- Elección de topología: agente único, orquestador más especialistas o primero herramientas con poca generación. La justificación queda en la ficha.
- Control del piloto: la scorecard prioriza la calidad de las decisiones y la claridad de los traspasos antes de que la plataforma apueste por identidad, trazas y arneses de evaluación.
- Catálogo como inventario: las identidades de agente solo aparecen cuando existe una ficha de caso de uso. El catálogo no es una estrategia.
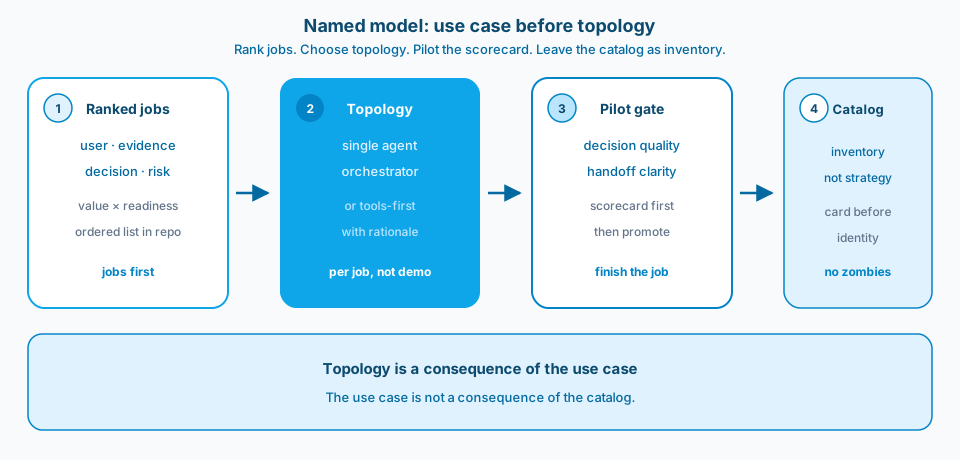
Figura 1. El caso de uso antes que la topología. Prioriza los trabajos, elige el runtime a propósito, prueba la scorecard en un piloto y deja el catálogo como inventario.
Contexto y restricción
Un fallo habitual: el primer borrador de un asistente basado en Foundry es "levantar muchos agentes y ver qué pasa". Las demos están llenas de actividad. El modelo operativo no. El tipo de trabajo A necesita especialistas. El tipo B necesita un solo agente cuidadoso hasta que el volumen demuestre lo contrario.
Prioriza los trabajos por valor para el usuario, riesgo y disponibilidad de evidencia. Para cada uno, elige agente único, orquestador más especialistas o sobre todo herramientas con poca generación. Code interpreter y la exportación son capacidades de un caso de uso, no valores por defecto de cada agente. Los límites entre agentes deberían seguir el reparto del trabajo entre personas. Copiar la estructura actual de las fuentes es una trampa: convierte el organigrama de ayer en el grafo de agentes de mañana.
La figura 2 es el encuadre de Learn para escenarios de aplicaciones con usuarios. El shell es una superficie de producto. La topología de agentes tiene que seguir igualmente al trabajo.
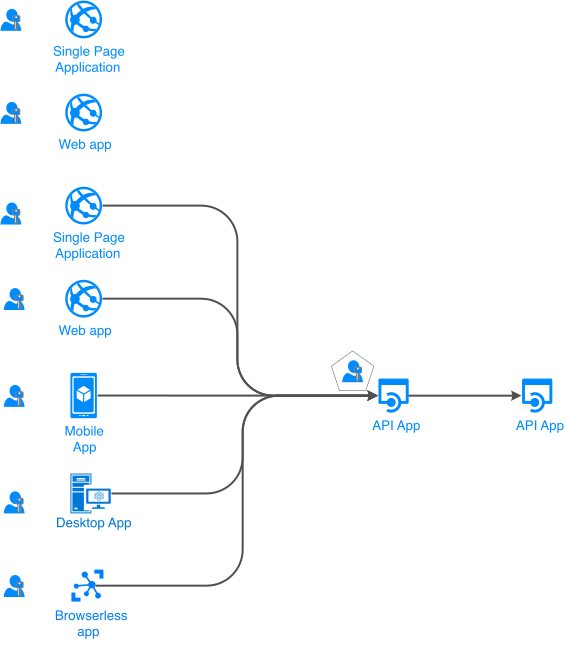
Figura 2. Prueba en el piloto el trabajo al que debe servir el shell. La topología de agentes sigue al caso de uso, no a un catálogo de modelos que buscan trabajo. Fuente: Microsoft Learn: flujos de autenticación y escenarios de aplicación.
Diseño
1. Prioriza los casos de uso antes que los endpoints
Escribe el trabajo, el usuario, las fuentes de evidencia, la decisión o el artefacto que se produce y el coste de un fallo. Ordena por valor y madurez. Solo entonces elige modelos y herramientas. Una lista preciosa de endpoints sin trabajos priorizados es teatro de compras.
2. Ajusta la topología a la forma del trabajo
Los flujos con habilidades especializadas bien separadas suelen pedir un orquestador más especialistas. Un trabajo de preguntas y respuestas estrecho y con un único propósito puede seguir con un agente único hasta que aparezca la presión de la concurrencia y la especialización. No despliegues la complejidad de un runtime multiagente para impresionar en la revisión de arquitectura cuando un agente único con herramientas supera el listón del piloto. La figura 3 muestra esa correspondencia.
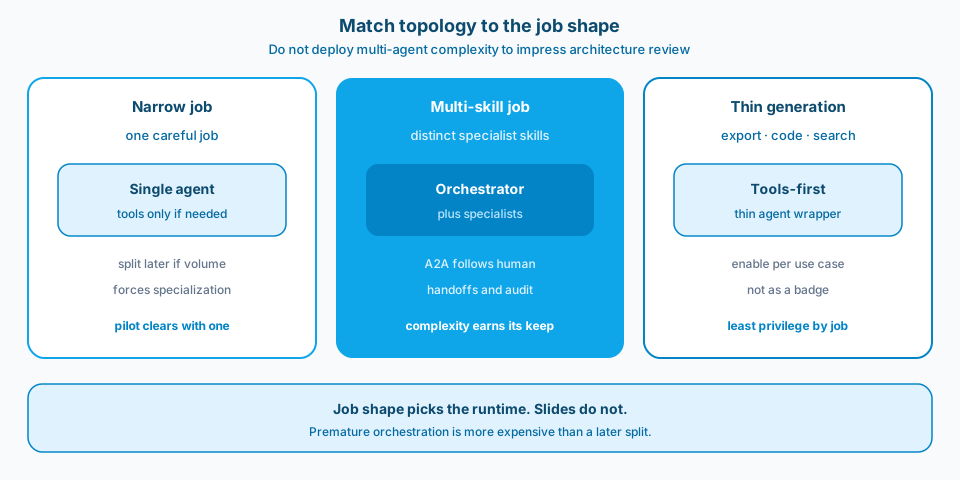
Figura 3. Ajusta la topología a la forma del trabajo. Un trabajo estrecho puede quedarse con un agente único. Un trabajo con varias habilidades se gana un orquestador. En los trabajos de primero herramientas, la generación es mínima y los privilegios también.
3. Trata las herramientas como funciones de producto por caso de uso
Code interpreter, la exportación, la navegación y la búsqueda de conocimiento MCP no son una insignia para colgar en cada agente. Actívalas donde el trabajo las necesite. Desactívalas u ocúltalas donde crean riesgo sin aportar valor. Las listas de funciones que ignoran los casos de uso se convierten en superficie de ataque y en carga de soporte.
4. Traza los límites A2A como traspasos entre personas
Si dos roles humanos no compartirían mesa ni cola de trabajo, no los juntes en un agente "por simplicidad", y tampoco los dividas en cinco agentes porque el repo tiene cinco carpetas. Los límites deberían coincidir con la responsabilidad, la escalada y las necesidades de auditoría.
5. Parte de los resultados y la evidencia, no de la estructura existente
Los inventarios antiguos de fuentes y los intents de asistentes anteriores te empujan hacia el material que existe en lugar de hacia las decisiones que necesitan los usuarios. Haz inventario de la evidencia para los trabajos priorizados. Los huecos se convierten en líneas de trabajo de datos, no en listas de deseos para prompts.
6. Evalúa el piloto por la calidad de las decisiones y la claridad de los traspasos
Criterios de éxito: ¿puede un usuario terminar el trabajo?, ¿puede un revisor ver por qué?, ¿puede el siguiente paso humano continuar sin problemas? El gasto en tokens y la latencia importan, pero no son la métrica principal para el control de un piloto. Escribe la scorecard antes de construir.
Cuándo pasar del piloto a una apuesta de plataforma
Promociona cuando la scorecard se cumpla con usuarios reales, los huecos de evidencia tengan responsables y la topología elegida siga encajando con el trabajo con poca carga. No promociones porque el catálogo parezca vacío o porque una diapositiva de la hoja de ruta de un proveedor mostrara multiagente. Las apuestas de plataforma financian la identidad compartida, las trazas y los arneses de evaluación. Esas inversiones solo compensan cuando los casos de uso son lo bastante reales como para ponerlas a prueba.
Qué significa "priorizado" en la práctica
Priorizar no es un taller de pósits que luego desaparece. Es una lista corta y ordenada en el repo, con responsable, riesgo, fuentes de evidencia y topología elegida en cada fila. Revísala cuando un piloto falle o cuando el volumen obligue a pasar de un agente único a un orquestador. La lista puede cambiar. Lo que no vale es publicar agentes que nunca aparecen en ella.
La figura 4 es el control práctico que impide que crezcan zombis en el catálogo.
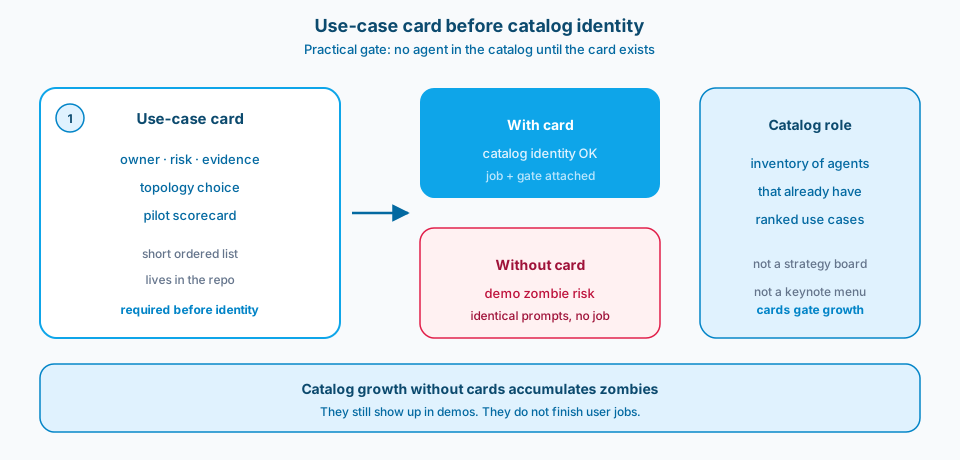
Figura 4. Ninguna identidad de agente nueva hasta que exista una ficha de caso de uso con responsable, scorecard y topología elegida. Un catálogo que crece sin fichas es la forma en que las plataformas acumulan zombis de demo.
Errores comunes
Plataformas que empiezan por el catálogo. Muchos agentes, trabajos poco claros y prompts idénticos con nombres distintos.
Multiagente por defecto. El coste de la orquestación sin el beneficio de la especialización.
Herramientas activadas para todo. Exportación e intérprete activos donde la política nunca los aprobó.
A2A según las carpetas del repo. La estructura de ingeniería confundida con la estructura del producto.
La arqueología de inventarios de fuentes como hoja de ruta. Automatizas el archivo, no el trabajo.
Paneles de tokens como éxito del piloto. Las respuestas baratas pero erróneas siguen fallando al usuario.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Una lista priorizada de casos de uso controla las decisiones de topología de la plataforma.
- Por caso de uso: agente único, orquestador o primero herramientas, con su justificación.
- Herramientas y exportaciones activadas solo donde el caso de uso lo exige.
- Los límites A2A siguen el reparto del trabajo entre personas y las líneas de auditoría.
- La scorecard del piloto prioriza la calidad de las decisiones y la claridad de los traspasos.
- Los inventarios de fuentes existentes alimentan el inventario de evidencia, no el grafo de agentes.
Adáptalo antes de usarlo
Priorizar los casos de uso retrasa la primera demo y ahorra la segunda reescritura. Los pilotos con un agente único pueden necesitar dividirse más adelante cuando crezca el volumen, y eso sale más barato que una orquestación prematura. Un mínimo privilegio estricto en las herramientas molesta a quienes quieren todo activado en dev. Mantén un perfil de laboratorio separado del perfil del piloto que enseñas a los stakeholders. El trabajo sobre los huecos de evidencia puede superar con creces el trabajo sobre el modelo. Eso suele significar que has encontrado el programa de verdad.
Referencias principales: los conceptos de agentes y multiagente de Microsoft Foundry en Microsoft Learn, además de tus principios de producto para traspasos a personas y aprobaciones. Acompaña la documentación de la plataforma con una scorecard de casos de uso escrita en el repo.
Un control práctico: ninguna identidad de agente nueva en el catálogo hasta que exista una ficha de caso de uso con responsable, scorecard y topología elegida. Un catálogo que crece sin fichas es la forma en que las plataformas acumulan zombis que siguen apareciendo en las demos.
Prueba el caso de uso en un piloto. Elige la topología a propósito. Deja el catálogo como inventario, no como estrategia.