

Das Wichtigste in Kürze
- Ranke die Use Cases, bevor du Modelle, Tools oder Multi-Agent-Topologien auswählst.
- Pro Aufgabe: Einzel-Agent, Orchestrator plus Spezialisten oder Tools zuerst, jeweils mit Begründung.
- Aktiviere Code Interpreter, Export, Browse und MCP-Suche nur dort, wo die Aufgabe sie braucht.
- Ziehe A2A-Grenzen wie Übergaben zwischen Menschen, Eskalationswege und Audit-Linien.
- Bewerte Piloten nach der Qualität der Entscheidungen und der Klarheit der Übergaben, nicht nach Token-Dashboards.
- Keine Identität im Katalog, bevor es eine Use-Case-Karte mit Verantwortlichem, Scorecard und Topologie gibt.
Agent-Programme in Unternehmen beginnen oft mit einer Speisekarte: Modelle, Tools, vielleicht ein Multi-Agent-Diagramm aus einer Keynote. Der Katalog fühlt sich nach Fortschritt an. Die Nutzer wissen trotzdem nicht, welche Aufgabe das System eigentlich erledigen soll.
Starte mit gerankten Use Cases. Entscheide pro Aufgabe zwischen Orchestrator, Einzel-Agent und Tools. Teste im Piloten die Qualität der Entscheidungen und die Klarheit der Übergaben, bevor du die Plattform auf eine Topologie setzt, die auf einer Folie gut aussah.
Benanntes Modell: Use Case vor Topologie
- Gerankte Aufgaben: Schreibe Nutzer, Quellen für die Belege, die Entscheidung oder das Ergebnis und die Kosten eines Fehlers auf. Sortiere nach Wert und Reife.
- Wahl der Topologie: Einzel-Agent, Orchestrator plus Spezialisten oder Tools zuerst mit wenig Generierung. Die Begründung steht auf der Karte.
- Schranke für den Piloten: Die Scorecard betont Qualität der Entscheidungen und Klarheit der Übergaben, bevor die Plattform auf Identität, Tracing und Evaluation-Harnesses setzt.
- Katalog als Inventar: Agent-Identitäten erscheinen erst, wenn es eine Use-Case-Karte gibt. Der Katalog ist keine Strategie.
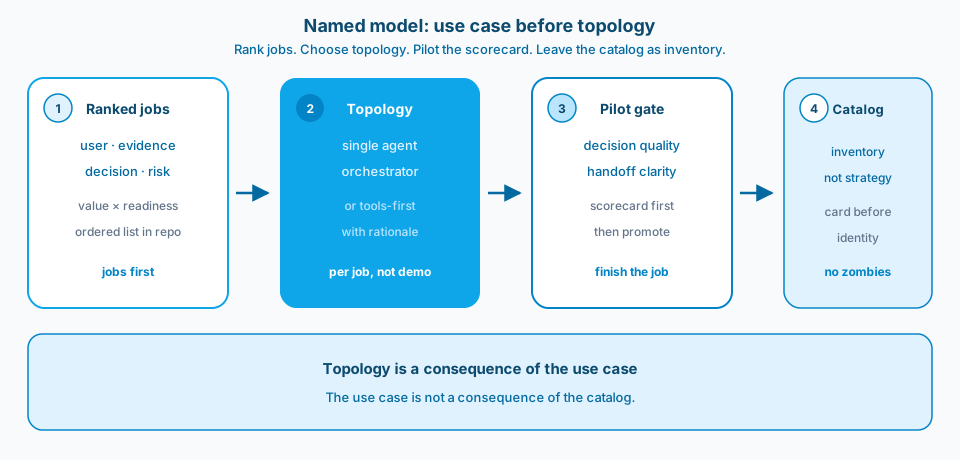
Abbildung 1. Use Case vor Topologie. Ranke die Aufgaben, wähle die Laufzeit bewusst, teste die Scorecard im Piloten und lass den Katalog ein Inventar bleiben.
Kontext und Rahmenbedingung
Ein typischer Fehler: Der erste Entwurf für einen Assistenten auf Basis von Foundry lautet "viele Agents aufsetzen und schauen, was passiert". Die Demos sind voll. Das Betriebsmodell ist es nicht. Aufgabentyp A braucht Spezialisten. Aufgabentyp B braucht einen sorgfältigen Agent, bis das Volumen etwas anderes beweist.
Ranke Aufgaben nach Nutzen für die Nutzer, Risiko und Verfügbarkeit von Belegen. Wähle für jede Aufgabe einen Einzel-Agent, einen Orchestrator plus Spezialisten oder überwiegend Tools mit wenig Generierung. Code Interpreter und Export sind Fähigkeiten eines Use Cases, keine Standardausstattung jedes Agents. Grenzen zwischen Agents sollten der Aufteilung der Arbeit zwischen Menschen folgen. Die bestehende Struktur der Quellen nachzubauen ist eine Falle: Damit wird das Organigramm von gestern zum Agent-Graphen von morgen.
Abbildung 2 zeigt die Einordnung aus Learn für App-Szenarien mit Nutzern. Die Shell ist eine Produktoberfläche. Die Topologie der Agents muss trotzdem der Aufgabe folgen.
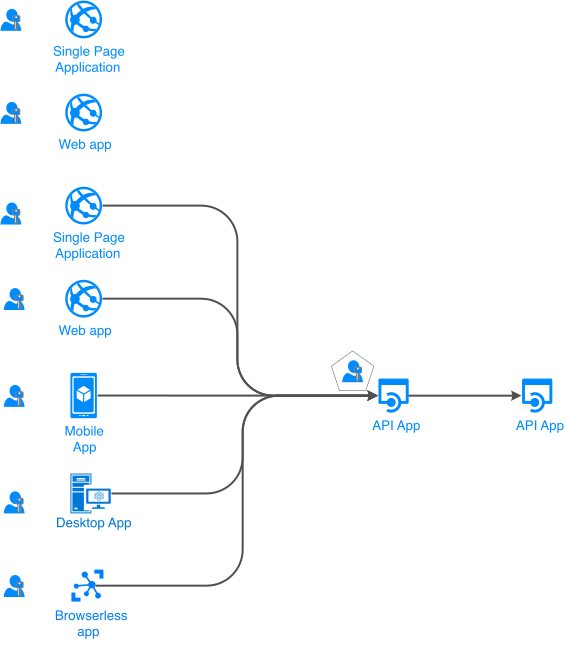
Abbildung 2. Teste im Piloten die Aufgabe, der die Shell dienen muss. Die Topologie der Agents folgt dem Use Case, nicht einem Katalog von Modellen auf Arbeitssuche. Quelle: Microsoft Learn: Authentifizierungsflows und App-Szenarien.
Design
1. Use Cases vor Endpunkten ranken
Schreibe die Aufgabe auf, den Nutzer, die Quellen für die Belege, die Entscheidung oder das Ergebnis und die Kosten eines Fehlers. Sortiere nach Wert und Reife. Erst dann wählst du Modelle und Tools aus. Eine schöne Liste von Endpunkten ohne gerankte Aufgaben ist Beschaffungstheater.
2. Die Topologie an die Form der Aufgabe anpassen
Abläufe mit klar getrennten Spezialfähigkeiten brauchen oft einen Orchestrator plus Spezialisten. Eine enge Q&A-Aufgabe mit einem einzigen Zweck kann ein Einzel-Agent bleiben, bis Druck durch Parallelität und Spezialisierung entsteht. Bring keine komplexe Multi-Agent-Laufzeit in Stellung, um das Architektur-Review zu beeindrucken, wenn ein Einzel-Agent mit Tools die Messlatte des Piloten schafft. Abbildung 3 zeigt diese Zuordnung.
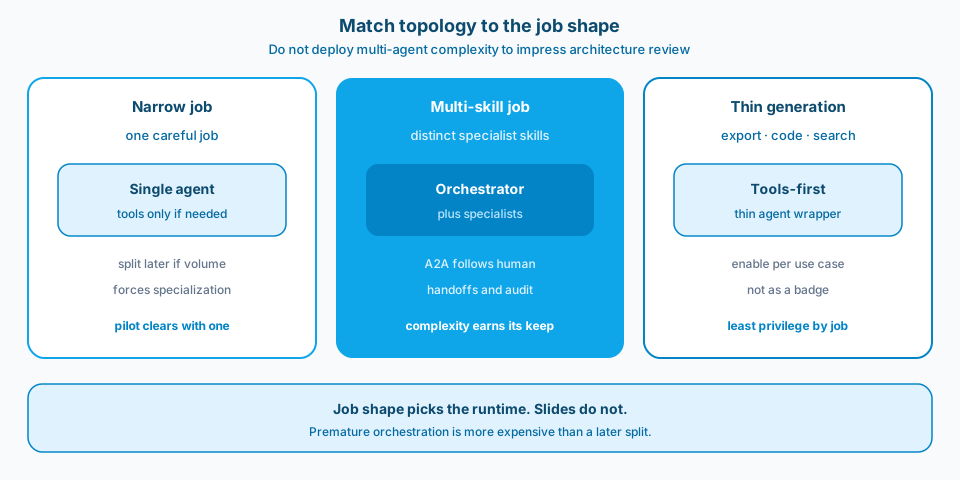
Abbildung 3. Die Topologie passt zur Form der Aufgabe. Eine enge Aufgabe kann ein Einzel-Agent bleiben. Eine Aufgabe mit mehreren Fähigkeiten verdient sich einen Orchestrator. Bei Aufgaben mit Tools zuerst bleibt die Generierung schmal und die Rechte minimal.
3. Tools als Produktfunktionen pro Use Case behandeln
Code Interpreter, Export, Browse und die MCP-Wissenssuche sind keine Abzeichen, die man jedem Agent anheftet. Aktiviere sie dort, wo die Aufgabe sie braucht. Deaktiviere oder verstecke sie dort, wo sie Risiko ohne Nutzen schaffen. Funktionslisten, die Use Cases ignorieren, werden zu Angriffsfläche und zu Supportaufwand.
4. A2A-Grenzen wie Übergaben zwischen Menschen ziehen
Wenn zwei menschliche Rollen sich keinen Schreibtisch und keine Warteschlange teilen würden, leg sie nicht "der Einfachheit halber" in einem Agent zusammen. Teile sie aber auch nicht auf fünf Agents auf, nur weil das Repo fünf Ordner hat. Grenzen sollten zu Verantwortung, Eskalation und Audit-Anforderungen passen.
5. Bei Ergebnissen und Belegen anfangen, nicht bei der bestehenden Struktur
Alte Inventare der Quellen und frühere Intents von Assistenten lenken dich auf das Material, das existiert, statt auf die Entscheidungen, die Nutzer brauchen. Erfasse die Belege für die gerankten Aufgaben. Lücken werden zu Daten-Arbeitspaketen, nicht zu Wunschlisten für Prompts.
6. Piloten nach Entscheidungsqualität und Klarheit der Übergaben bewerten
Erfolgskriterien: Kann ein Nutzer die Aufgabe abschließen, kann ein Reviewer nachvollziehen warum, kann der nächste menschliche Schritt sauber übernehmen? Token-Verbrauch und Latenz zählen, sind aber nicht die wichtigste Kennzahl für die Schranke eines Piloten. Schreibe die Scorecard vor dem Bau.
Wann aus dem Piloten eine Plattformwette wird
Befördere, wenn die Scorecard mit echten Nutzern besteht, die Lücken bei den Belegen Verantwortliche haben und die Wahl der Topologie unter leichter Last noch zur Aufgabe passt. Befördere nicht, weil der Katalog leer aussieht oder weil eine Roadmap-Folie eines Anbieters Multi-Agent gezeigt hat. Plattformwetten finanzieren gemeinsame Identität, Tracing und Evaluation-Harnesses. Diese Investitionen lohnen sich nur, wenn die Use Cases echt genug sind, um sie zu fordern.
Was "gerankt" in der Praxis heißt
Ranking ist kein Workshop mit Klebezetteln, der danach verschwindet. Es ist eine kurze, geordnete Liste im Repo mit Verantwortlichem, Risiko, Quellen für die Belege und der Wahl der Topologie in jeder Zeile. Sieh sie dir wieder an, wenn ein Pilot scheitert oder wenn das Volumen den Wechsel vom Einzel-Agent zum Orchestrator erzwingt. Die Liste darf sich ändern. Agents auszuliefern, die nie auf der Liste stehen, ist nicht erlaubt.
Abbildung 4 zeigt die praktische Schranke, die verhindert, dass im Katalog Zombies wachsen.
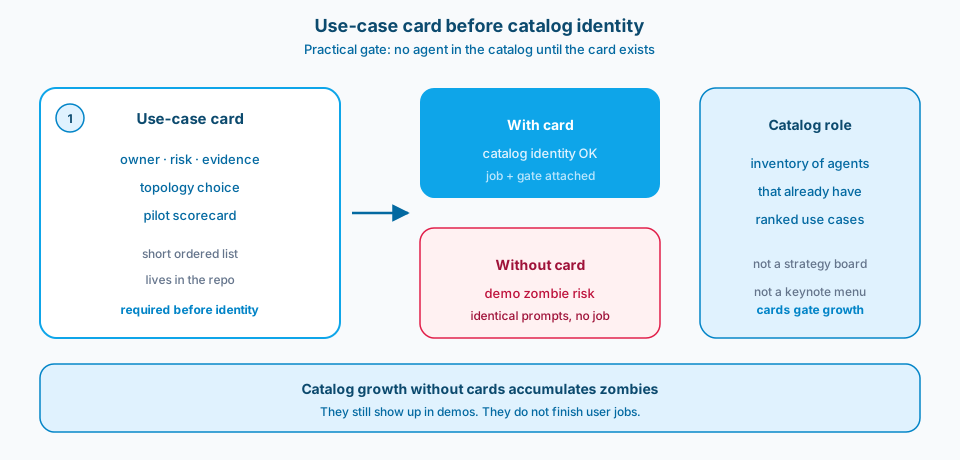
Abbildung 4. Keine neue Agent-Identität, bevor es eine Use-Case-Karte mit Verantwortlichem, Scorecard und Wahl der Topologie gibt. Ein Katalog, der ohne Karten wächst, ist der Weg, auf dem Plattformen Demo-Zombies ansammeln.
Häufige Fehler
Plattformen, die beim Katalog anfangen. Viele Agents, unklare Aufgaben, identische Prompts unter verschiedenen Namen.
Multi-Agent als Standard. Die Kosten der Orchestrierung ohne den Nutzen der Spezialisierung.
Tools für alles eingeschaltet. Export und Interpreter sind aktiv, wo die Richtlinie sie nie freigegeben hat.
A2A nach Repo-Ordnern. Die Struktur des Engineerings wird mit der Struktur des Produkts verwechselt.
Archäologie in Quellinventaren als Roadmap. Du automatisierst das Archiv, nicht die Arbeit.
Token-Dashboards als Erfolg des Piloten. Billige falsche Antworten lassen den Nutzer trotzdem im Stich.
So übernehmen oder anpassen
So übernehmen
- Eine gerankte Liste von Use Cases steuert die Entscheidungen zur Topologie der Plattform.
- Pro Use Case: Einzel-Agent, Orchestrator oder Tools zuerst, mit Begründung.
- Tools und Exporte nur dort aktiviert, wo der Use Case sie verlangt.
- A2A-Grenzen folgen der Aufteilung der Arbeit zwischen Menschen und den Audit-Linien.
- Die Scorecard des Piloten betont Entscheidungsqualität und Klarheit der Übergaben.
- Bestehende Quellinventare sind Eingaben für das Inventar der Belege, nicht der Agent-Graph.
Vor dem Einsatz anpassen
Das Ranking von Use Cases verlangsamt die erste Demo und spart das zweite Neuschreiben. Piloten mit einem Einzel-Agent müssen später vielleicht aufgeteilt werden, wenn das Volumen wächst. Das ist billiger als eine verfrühte Orchestrierung. Strenges Least Privilege bei Tools nervt Entwickler, die in Dev alles aktiviert haben wollen. Halte ein Lab-Profil getrennt von dem Pilot-Profil, das du den Stakeholdern zeigst. Die Arbeit an den Lücken bei den Belegen kann die Arbeit am Modell weit übertreffen. Das heißt meist, dass du das eigentliche Programm gefunden hast.
Wichtigste Quellen: die Konzepte zu Agents und Multi-Agent in Microsoft Foundry auf Microsoft Learn, dazu deine Produktprinzipien für Übergaben an Menschen und Freigaben. Ergänze die Plattform-Doku um eine schriftliche Use-Case-Scorecard im Repo.
Eine praktische Schranke: keine neue Agent-Identität im Katalog, bevor es eine Use-Case-Karte mit Verantwortlichem, Scorecard und Wahl der Topologie gibt. Ein Katalog, der ohne Karten wächst, ist der Weg, auf dem Plattformen Zombies ansammeln, die immer noch in Demos auftauchen.
Teste den Use Case im Piloten. Wähle die Topologie bewusst. Lass den Katalog ein Inventar sein, keine Strategie.