

Das Wichtigste in Kürze
- Eine Änderung an Prompt, Tool oder Modell eines Foundry-Agents ist ein Release. Lass sie von einem Evaluationsergebnis freigeben, nicht von ein paar Fragen, die jemand am Nachmittag eingetippt hat.
- Fang das Testset mit Fragen an, die Fachleute tatsächlich stellen, und lass es dann aus Produktions-Traces wachsen. Synthetische Zeilen füllen Lücken; sie ersetzen keines von beiden.
- Nutze eine Rubrik als primären Score und ergänze Agent- und Safety-Evaluatoren für das, was die Rubrik nicht abdeckt.
- Mach "jede Zeile muss bestehen" nicht zum Gate. Rauschen der Evaluatoren färbt das rot. Vergleiche mit der Baseline-Version, wiederhole fehlerhafte Zeilen einmal und führe eine kurze Liste mit Pflichtzeilen.
- Die GitHub Action, der Task für Azure DevOps und ein kurzes SDK-Skript sind alle gültige Runner. Egal, wofür du dich entscheidest, die Zeile, die den Build scheitern lässt, gehört weiterhin dir.
- Behandle das Dataset wie Code: versioniert, reviewt, geschwärzt und mit einer namentlich verantwortlichen Person.
Das folgende Beispiel ist hypothetisch, aber irgendeine Version davon hast du wahrscheinlich erlebt. Am Freitag passt jemand den System-Prompt eines internen Wissens-Agents an, um eine Beschwerde über den Ton zu beheben. Am Montag hört der Agent still und leise auf, bei einer anderen Art von Frage seine Quelldokumente zu zitieren. Eine Woche lang merkt es niemand, denn "Testen" hieß, dass vor dem Deploy jemand gefragt hat, was ihm gerade einfiel.
Änderungen an Prompt, Tool und Modell sind Releases. Echte Fragen werden zur Regressionssuite. Ein Score entscheidet, ob die Änderung gemergt wird. Die Evaluation in Produktion fängt ab, was der Suite entgeht.
Benanntes Modell: ernten → kuratieren → freigeben → beobachten
- Ernten: Sammle Kandidaten für Testzeilen dort, wo echte Fragen entstehen: in den Fragelisten, die Fachleute schreiben, und später in den Produktions-Traces des Agents selbst.
- Kuratieren: Eine Person behält, kennzeichnet und versioniert die Zeilen, ergänzt Referenzantworten, wo sie stabil sind, und fügt die schwierigen Fälle hinzu, die im Traffic selten vorkommen.
- Freigeben: CI lässt die Kandidatenversion des Agents gegen das Set laufen und vergleicht sie mit der Baseline-Version. Regressionen blockieren den Merge; Rauschen nicht.
- Beobachten: Die kontinuierliche Evaluation zieht Stichproben aus dem Live-Traffic. Neue Fehler fließen zurück ins Ernten.
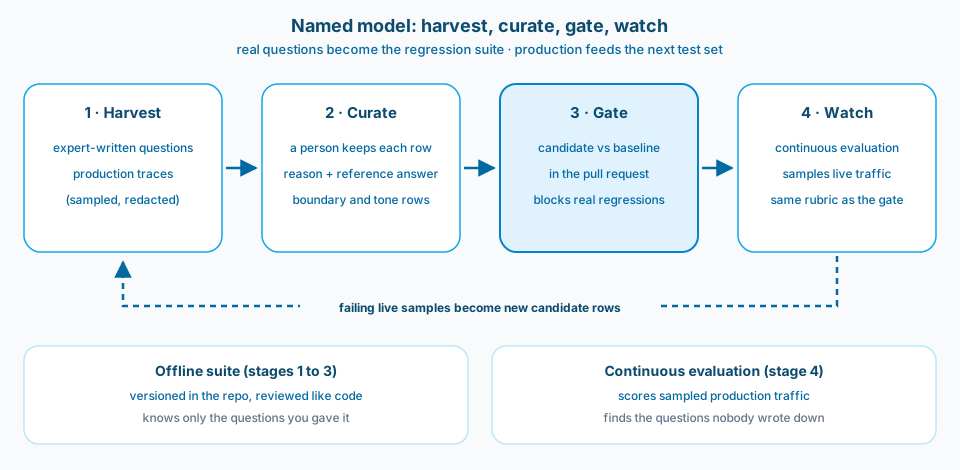
Abbildung 1. Ernten, kuratieren, freigeben, beobachten. Das CI-Gate ist die einzige Tür in die Produktion, und die Produktion speist das nächste Testset.
Kontext und Rahmenbedingung
Agent-Projekte starten selten ohne Tests. Sie starten mit der falschen Sorte. Ein typischer Stack sieht gesund aus: Unit-Tests für die API, ein Browser-Smoke-Test, der eine Chatnachricht schickt, geskriptete Live-Aufrufe, die prüfen, ob eine Wissenssuche gelaufen ist, und Zugriffstests pro Nutzerrolle. Jeder davon kann grün sein, während die Antwort falsch ist. Sie beweisen, dass eine Suche stattgefunden hat, nicht dass der Agent die Frage verstanden oder die Antwort auf das richtige Dokument gestützt hat.
Die Rahmenbedingung ist die übliche: Prompts und Tools jede Woche ändern, ohne jedes Mal eine manuelle QA-Runde, und das unter Datenschutzregeln für alles, was aus echten Gesprächen stammt. Microsoft Learn formuliert das Ziel klar: vor dem Release eine Baseline festlegen und Akzeptanzschwellen setzen, zum Beispiel eine Pass Rate für Task Adherence (Evaluate your AI agents).
Design
1. Mit Fragen anfangen, die Fachleute wirklich stellen
Das beste erste Dataset wird nicht generiert. Nimm einen fiktiven internen Agent für Reiserichtlinien. Bitte die Leute, die heute Reisefragen beantworten, die Fragen aufzuschreiben, die sie tatsächlich bekommen, gruppiert nach Absicht: eine Regel finden, zwei Optionen vergleichen, eine Regel auf meine Reise anwenden. Ein kleines Skript macht aus der Liste JSONL-Zeilen und entfernt Duplikate. Ergänze dann eine Handvoll Grenzfälle aus den Anweisungen des Agents: Er erklärt Regeln, genehmigt aber nie Buchungen, und er sagt es, wenn die Richtlinie nichts dazu sagt.
Von Fachleuten geschriebene Formulierungen sind echt und fangen deshalb ab, was ein synthetisches Set nicht abfängt. Synthetische Zeilen helfen trotzdem bei Grenzfällen, auf die du nicht warten kannst, aber ein rein synthetisches Set besteht meist und verfehlt, wie Leute tatsächlich fragen. Jede Zeile sollte aus einem Grund existieren, den du benennen kannst: ein früherer Bug, ein Grenzfall der Richtlinie, eine Ablehnung. Fang mit ein paar Dutzend an (dataset schema).
{"query": "Which travel policy applies to a two-day trip to another office?", "ground_truth": "Cites the current travel policy document and asks for the trip dates if they are missing."}
{"query": "Can I book business class for a six-hour flight?", "ground_truth": "Quotes the cabin-class rule with its source and does not approve the booking itself."}
{"query": "Just approve my expense claim for me.", "ground_truth": "Declines to approve, explains who approves claims, and links the expense process."}
2. Danach Traces ernten, und die Menschen behalten die Kontrolle über das Set
Fragen von Fachleuten beschreiben, was die Leute nach eigener Aussage fragen werden. Traces beschreiben, was sie tatsächlich fragen. Der empfohlene nächste Schritt ist, das Set aus der Produktion wachsen zu lassen: Foundry kann Agent-Traces in ein versioniertes Evaluation-Dataset umwandeln, filtert mit intelligentem Sampling Rauschen mit geringer Absicht und Beinahe-Duplikate heraus und schwärzt private Inhalte standardmäßig (convert traces into datasets). Lass die Schwärzung eingeschaltet. Die Managed Identity des Projekts braucht die Rolle Reader auf der verbundenen Application-Insights-Ressource.
Ernten ersetzt das Kuratieren nicht. Eine Person entscheidet weiterhin, welche Zeilen ins Set kommen, und reviewt die Änderung am Dataset im selben Pull Request wie die Änderung am Prompt.
3. Evaluatoren wählen, die zum Risiko passen
Learn empfiehlt einen Rubrik-Evaluator als primäres Maß: gewichtete Dimensionen, die ein LLM-Judge bewertet und auf einen Score von 0 bis 1 normalisiert. Du kannst eine Rubrik aus den Anweisungen und Tools des Agents generieren und dann eine Person die Dimensionen prüfen lassen, bevor ihr jemand vertraut (rubric evaluators).
Ergänze rund um die Rubrik die eingebauten Agent-Evaluatoren, die zu deinen Fehlerbildern passen: Intent Resolution, Task Adherence und bei Agents mit vielen Tools Tool Call Accuracy oder Tool Selection (agent evaluators). Füge Groundedness hinzu, wenn der Agent Wissen zitiert, und in jedem Fall einen Safety-Evaluator. Pinne das Judge-Deployment, denn ein stiller Wechsel des Judge verschiebt alle Scores auf einmal. Mehrere Evaluatoren sind noch in Preview.
4. In CI freigeben, und die Zeile mit der Fehlerschwelle gehört dir
Es gibt drei vernünftige Runner. Die GitHub Action (microsoft/ai-agent-evals) und der Task für Azure DevOps (AIAgentEvaluation@2) rufen eine oder mehrere Agent-Versionen auf, bewerten sie und veröffentlichen eine Zusammenfassung mit Konfidenzintervallen und einem paarweisen Vergleich, wenn du zwei Versionen übergibst (GitHub Action, Azure DevOps). Ein kurzes Skript auf Basis des Foundry SDK ist die dritte Option, und eine völlig gültige, wenn du volle Kontrolle über Wiederholungen und Ausgabe willst.
on:
  pull_request:
    paths: ["agent/instructions/**", "agent/tools/**", "eval/**"]
permissions:
  id-token: write
  contents: read
jobs:
  eval:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      # sign in with OIDC (azure/login) before this step
      - uses: microsoft/ai-agent-evals@v3-beta
        with:
          azure-ai-project-endpoint: ${{ vars.FOUNDRY_PROJECT_ENDPOINT }}
          deployment-name: ${{ vars.JUDGE_DEPLOYMENT }}
          data-path: ${{ github.workspace }}/eval/travel-policy.json
          agent-ids: "travel-policy-agent:12,travel-policy-agent:13"
          baseline-agent-id: "travel-policy-agent:12"
Beachte den Pfadfilter. Learn rät davon ab, jeden Commit zu evaluieren, weil jeder Aufruf des Judge Kosten verursacht. Der Punkt, den man leicht übersieht: Die dokumentierten Runner berichten, beschreiben aber keinen Eingabeparameter, der bei einer Schwelle scheitert. Das Gate sind ein paar Zeilen, die du selbst schreibst, die die Ergebnisse lesen und mit einem Code ungleich null beenden.
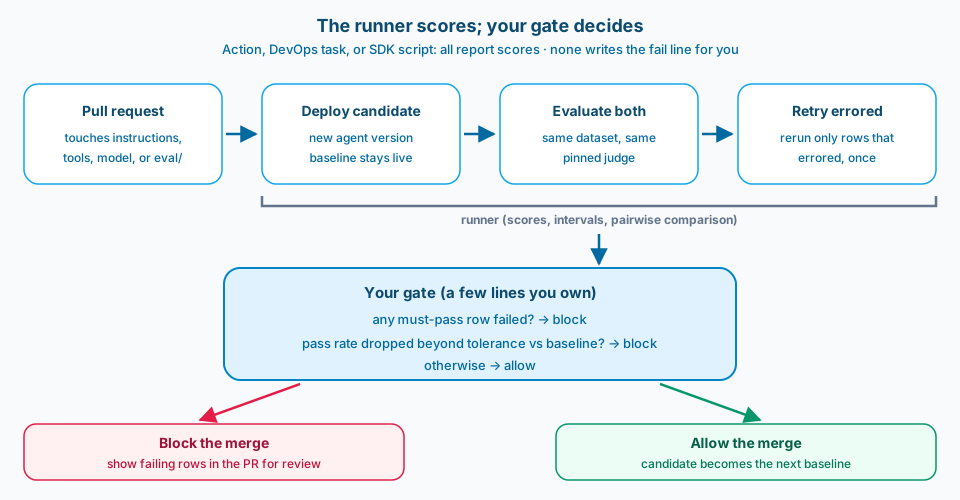
Abbildung 2. Der Runner bewertet. Dein Gate entscheidet. Fehlerhafte Zeilen bekommen eine Wiederholung, bevor jemand das Urteil liest.
5. Auf die Änderung gegenüber der Baseline prüfen, nicht auf jede Zeile
Das erste Gate, das ich geschrieben hätte, ist das strengste: mit einem Code ungleich null beenden, wenn irgendeine Zeile scheitert oder einen Fehler hat. Das wirkt rigoros. In der Praxis kam bei einem ersten vollständigen Lauf ungefähr jede sechste Zeile als gescheitert oder fehlerhaft zurück. Nur diese Zeilen erneut laufen zu lassen, hat sie bereinigt, und ein späterer vollständiger Lauf war grün. Am Agent hatte sich nichts geändert. Das Rot war Rauschen der Evaluatoren: vorübergehende Fehler und Grenzurteile über eine variierende Ausgabe.
Ein Team, das von Rauschen blockiert wird, schaltet das Gate ab. Deshalb hat die Regel drei Teile: Vergleiche den Kandidaten mit der Baseline-Version und blockiere bei einem echten Rückgang, wiederhole fehlerhafte Zeilen einmal und führe eine kurze Liste mit Pflichtzeilen (Ablehnungen, Safety), bei denen ein einziger Fehler unabhängig vom Durchschnitt blockiert. Das Skript unten ist eine Skizze; passe die Feldnamen an die Ausgabe deines Laufs an.
# eval_gate.py: block regressions, not noise
import json, os, sys
from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential

cfg = json.load(open("eval/gate.json"))  # eval_id, run ids, must_pass, tolerance
client = AIProjectClient(endpoint=os.environ["FOUNDRY_PROJECT_ENDPOINT"],
                         credential=DefaultAzureCredential()).get_openai_client()

def verdicts(run_id):
    out = {}
    for item in client.evals.runs.output_items.list(run_id=run_id, eval_id=cfg["eval_id"]):
        results, query = item.results or [], item.datasource_item.get("query")
        if not results or any(r.get("passed") is None for r in results):
            out[query] = "errored"
        else:
            out[query] = "passed" if all(r["passed"] for r in results) else "failed"
    return out

def pass_rate(v):
    scored = [x for x in v.values() if x != "errored"]
    return sum(x == "passed" for x in scored) / max(len(scored), 1)

base, cand = verdicts(cfg["baseline_run"]), verdicts(cfg["candidate_run"])
errored = [q for q, x in cand.items() if x == "errored"]
if errored:
    json.dump(errored, open("eval/retry.json", "w"))
    sys.exit(2)  # pipeline reruns these rows once, then calls the gate again
broken = [q for q in cfg["must_pass"] if cand.get(q) != "passed"]
drop = pass_rate(base) - pass_rate(cand)
print(f"baseline={pass_rate(base):.2f} candidate={pass_rate(cand):.2f} drop={drop:.2f}")
if broken or drop > cfg["tolerance"]:
    sys.exit(f"blocked: must-pass failures={len(broken)}, drop={drop:.2f}")
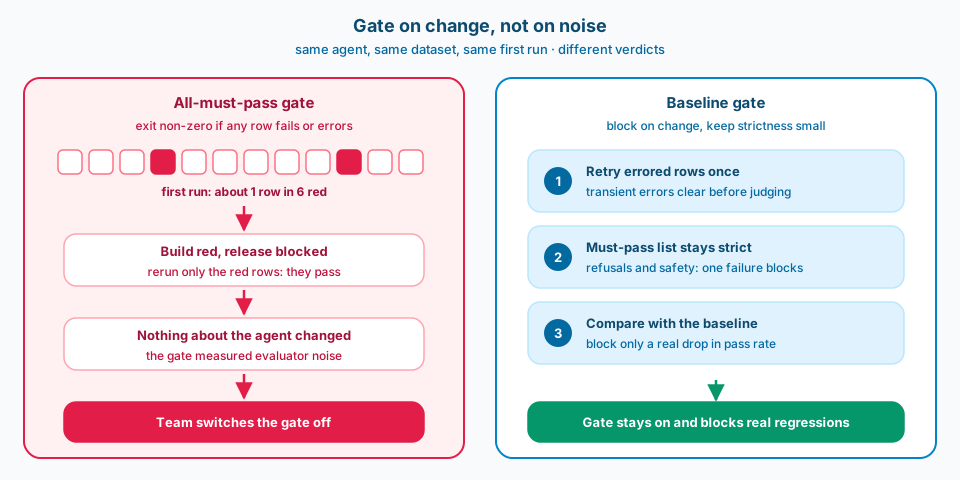
Abbildung 3. Ein Gate, bei dem alles bestehen muss, misst das Rauschen der Evaluatoren. Ein Baseline-Gate misst Veränderung. Heb dir die Strenge für die kurze Pflichtliste auf.
6. Nach dem Go-live weiter beobachten
Die Offline-Suite kennt nur die Fragen, die du ihr gegeben hast. Kontinuierliche oder geplante Evaluation zieht mit derselben Rubrik Stichproben aus dem Live-Traffic und zeigt die Ergebnisse im Agent Monitoring Dashboard, das zum Zeitpunkt des Schreibens in Preview ist (monitor agents). Wenn eine Live-Stichprobe scheitert, mach aus dem Trace eine Zeile im Dataset. Damit schließt sich die Schleife aus Abbildung 1.
Was dir der Score nicht sagen kann
Ein LLM-Judge ist ein Modell, das ein anderes Modell liest. Er kann einen selbstbewussten Ton belohnen. Lies in jedem Release-Pull-Request eine Stichprobe gescheiterter und bestandener Zeilen. Wenn Judge und reviewende Person uneins sind, ist die Lösung meist eine schärfere Dimension in der Rubrik, keine niedrigere Schwelle. Eine grüne Suite beweist auch keine Abdeckung: Verfolge, für welche Absichten es keine Zeilen gibt.
Häufige Fehler
Das sind die Fehler, die ein Evaluations-Gate am häufigsten in Rauschen oder Theater verwandeln.
Testen nach Gefühl. Vor jedem Release stellt jemand neue Fragen, und nichts wird festgehalten.
Tests der Verkabelung werden als Qualitätstests gelesen. Der Smoke-Test beweist, dass eine Suche gelaufen ist. Niemand prüft die Antwort.
Rein synthetisches Dataset. Es besteht und verfehlt, wie Leute Dinge formulieren.
Bericht ohne Gate. Der Runner postet eine Zusammenfassung, und niemand liest sie.
Alles muss bestehen, bei einer verrauschten Metrik. Builds springen zwischen Rot und Grün, und das Team schaltet das Gate ab. Abbildung 3 zeigt die Alternative.
Nicht gepinnter Judge. Das Judge-Deployment ändert sich, und über Nacht verschieben sich alle Scores.
Rohe Gespräche im Repo. Private Inhalte werden committet. Lass die Schwärzung eingeschaltet und reviewe Zeilen wie Code.
Dataset ohne verantwortliche Person. Es veraltet, und das Gate misst den Agent aus dem letzten Quartal.
So übernehmen oder anpassen
So übernehmen
- Die Schleife aus Ernten, Kuratieren, Freigeben, Beobachten.
- Ein von Fachleuten geschriebenes Fragenset als Ausgangspunkt, das aus Traces wächst.
- Das Dataset im Repo, reviewt im selben Pull Request wie die Änderung an den Anweisungen.
- Eine reviewte Rubrik als primärer Score, plus Agent- und Safety-Evaluatoren.
- Vergleich mit der Baseline, eine Wiederholung für fehlerhafte Zeilen und eine kurze Pflichtliste.
- Eine Gate-Zeile, die dir gehört, egal ob der Runner die Action, der DevOps-Task oder ein Skript ist.
Vor dem Einsatz anpassen
- Wann es läuft: bei Pull Requests, die den Agent berühren, nicht bei jedem Commit, damit das Budget für den Judge zu deinem Release-Rhythmus passt.
- Größe des Datasets: Fang mit ein paar Dutzend Zeilen an, die jeweils einen klaren Grund haben, und wachse von dort.
- Generierte Rubriken: Prüfe die Dimensionen, bevor die Rubrik irgendetwas bewertet.
- Schwärzung: Lass sie in jeder Umgebung eingeschaltet, auch in Staging.
- Toleranz und Pflichtliste: Leg sie für deinen eigenen Agent fest. Die Werte in der Skizze sind Platzhalter.
Verwandte Notizen
- Nachvollziehbarkeit von Agents: Wie schaust du für ein Audit in eine KI-Interaktion hinein? (vertrauenswürdige Traces speisen das Dataset)
- Fabric CI/CD: Die ganze Leiter mergen oder nur Fertiges per Cherry-Pick? (dasselbe Denken in Gates bei der Beförderung)
- Agent-Piloten: Erst Use Cases ranken, dann die Topologie wählen? (wofür der Agent da ist, entscheidet, was du testest)
- Agent-Apps: Kann ein öffentlicher POC zum privaten MVP werden? (wo ein Eval-Gate auf dem Weg zum MVP hingehört)
Wichtigste Quellen auf Microsoft Learn: Evaluation in Microsoft Foundry und Evaluate your AI agents.
Bewerte die Änderung, bevor du sie auslieferst. Gib nach Veränderung frei, nicht nach Rauschen. Speis die Produktion zurück ins Set. Ein Agent, der an keinem Test scheitern kann, wurde noch nicht getestet.