

Puntos clave
- Trata la preparación para Genie como la preparación de un modelo semántico para cualquier consumidor de IA.
- Certifica una superficie gold pequeña; no apuntes el chat a bronze ni a datos en bruto.
- Haz explícita la granularidad; una fila significa una cosa, y eso va en la descripción de la tabla.
- Pon los nombres de negocio y el glosario donde miran tanto el planificador como el modelo.
- Declara relaciones reales y una única definición de cada métrica, con responsable.
- Clasifica las columnas sensibles antes de abrir el acceso por chat.
Los equipos preguntan qué calidad deben tener los datos antes de que la analítica conversacional sirva de algo. La respuesta honesta: la suficiente para que un analista cuidadoso confiara en esas mismas tablas sin una interfaz de chat.
Los prompts no pueden rescatar una granularidad ambigua, nombres de columna crípticos ni relaciones que faltan. La analítica conversacional lee primero los metadatos y la estructura. Los prompts de sistema son una capa fina por encima.
Modelo con nombre: preparar Genie es preparar el modelo
- Esquemas curados: una superficie gold certificada con una granularidad explícita y aburrida. Ni bronze ni datos en bruto para el chat de los usuarios finales.
- Nombres y glosario: etiquetas legibles para el negocio, descripciones en el catálogo para los códigos y sinónimos junto a los datos que la herramienta puede leer.
- Relaciones: claves y joins declarados, exploración acotada. Los joins equivocados producen números plausibles.
- Métricas con responsable: una definición, un responsable con nombre y un sitio que el agente puede leer. La sensibilidad, clasificada antes de abrir el chat.
- Contrato: los prompts son una capa fina sobre la estructura y los metadatos. La ambigüedad de debajo se convierte en respuestas incorrectas muy bien redactadas.
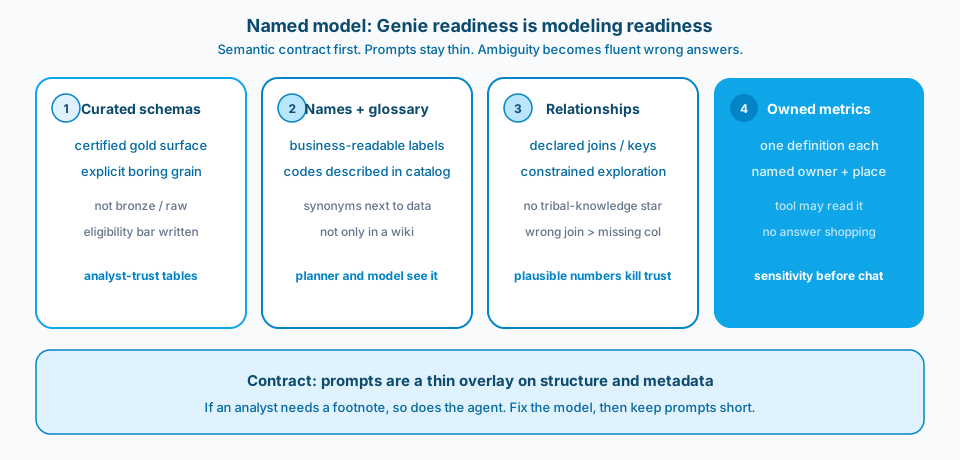
Figura 1. Preparar Genie es preparar el modelo. Esquemas curados, glosario junto a los datos, relaciones declaradas y métricas con responsable. Los prompts siguen siendo finos.
Contexto y restricción
Un patrón de rescate conocido: un espacio de Genie vistoso apuntando a tablas a medio curar, seguido de una semana editando prompts que nunca arregló el join equivocado. El modelo no era el cuello de botella. El contrato semántico, sí.
Si la granularidad no está clara, los nombres son códigos físicos, las relaciones son conocimiento tribal y las métricas tienen tres responsables, el agente se inventará joins y definiciones. Eso parece una "alucinación". A menudo es simplemente el modelo haciendo cuentas sobre la ambigüedad que tú entregaste.
Trata la preparación para Genie como la preparación de un modelo semántico para cualquier consumidor de IA: esquemas curados, nombres legibles para el negocio, relaciones documentadas, métricas con responsable y un glosario que vive junto a los datos, no solo en una wiki que nadie abre.
La figura 2 es el planteamiento de Learn sobre las estructuras analíticas curadas. Las herramientas conversacionales se apoyan en esa superficie. No la inventan.
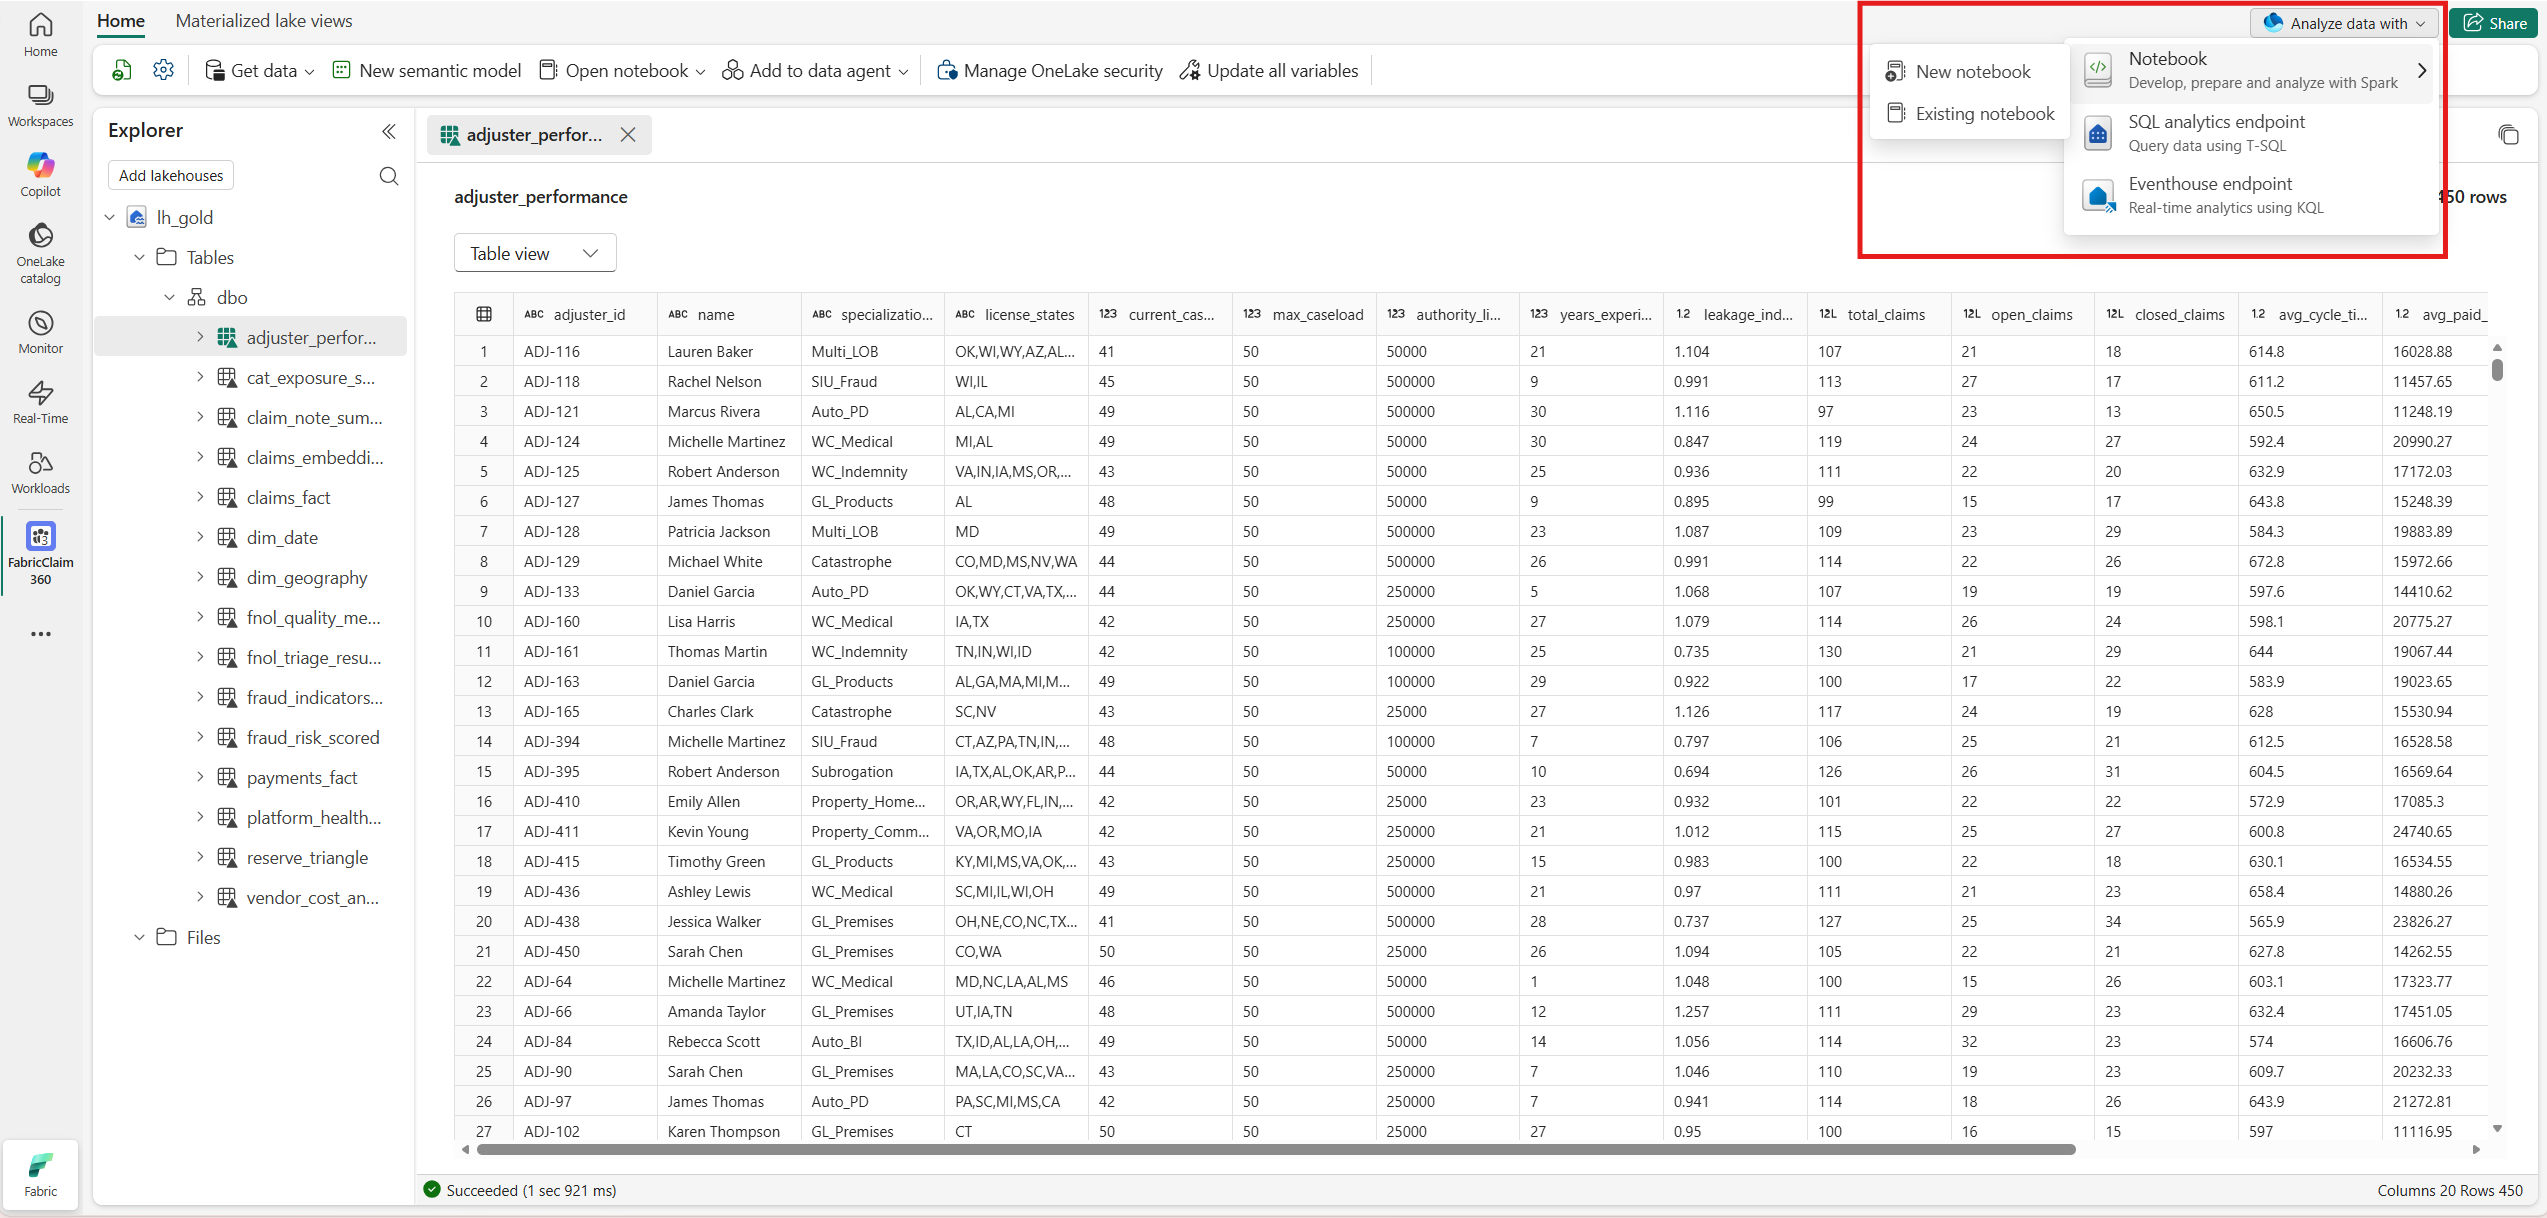
Figura 2. Las herramientas conversacionales se apoyan en estructuras analíticas curadas. Fuente: Microsoft Learn: lakehouse overview.
Diseño
1. La granularidad es explícita y aburrida
Una fila significa una cosa. Dilo en la descripción de la tabla. Las tablas de hechos que mezclan filas de detalle y de cabecera, o snapshots y eventos, darán respuestas incorrectas con total seguridad la primera vez que alguien pida un recuento. Si un analista necesita una nota al pie, el agente también.
En mi demo, la tabla de hechos lo dice en una línea: una fila por id, exactamente un segmento por fila, y cómo se suma el valor. Cada comentario de columna dice qué contiene la columna, y las columnas clave están marcadas como clave primaria y clave foránea (figura 3).
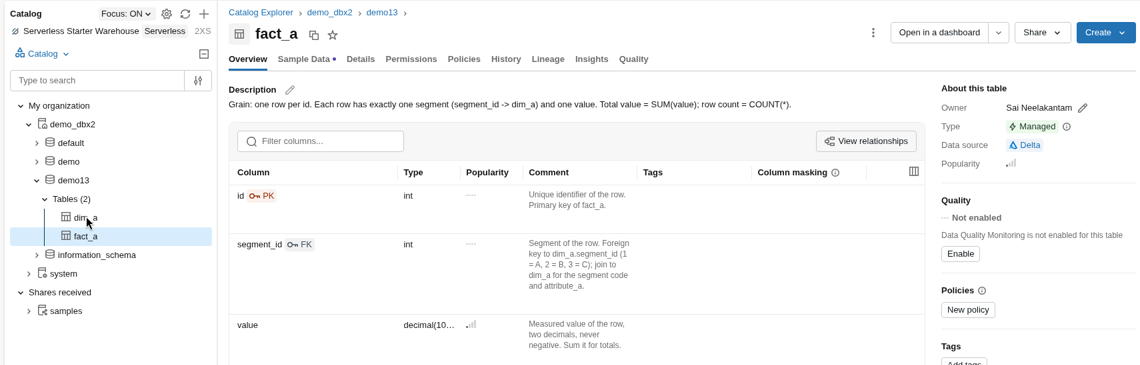
Figura 3. La granularidad, las claves y el significado de las columnas, escritos en la propia tabla, donde cualquier consumidor puede leerlos.
2. Los nombres y el glosario ganan a las instrucciones ingeniosas
Usa nombres legibles para el negocio en tablas, columnas y medidas. Los códigos necesitan descripciones en el catálogo. Los sinónimos de cómo pregunta la gente de verdad ("amount" frente a COL_A) van en la capa semántica o en los metadatos del catálogo que la herramienta puede ver. Un prompt de sistema largo que repite el glosario es una trampa de mantenimiento. Pon el significado donde miran tanto el planificador de consultas como el modelo.
Genie recoge esos metadatos. Dentro del espacio, la misma tabla de hechos muestra la descripción de la granularidad del catálogo, las marcas de clave y el comentario que relaciona segment_id con la dimensión (figura 4).
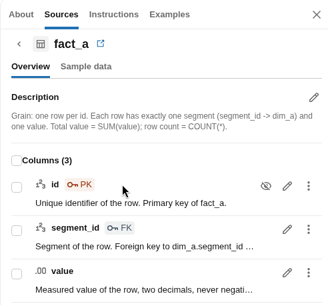
Figura 4. La descripción del catálogo y las claves pasan tal cual al espacio de Genie.
3. Las relaciones son reales, no aspiracionales
Declara los joins que esperas. Las claves primarias, las claves foráneas y los espacios de exploración acotados importan más que los ajustes de temperatura. Si dos columnas de fecha parecen ambas "la" fecha, el modelo elegirá una. Si una tabla puente no está documentada, el agente inventará una estrella que no existe. Las relaciones equivocadas son peores que las columnas que faltan: producen números plausibles.
En mi demo, las claves están declaradas en un hecho y una dimensión que comparten segment_id, y Catalog Explorer dibuja la relación entre ambas (figura 5).
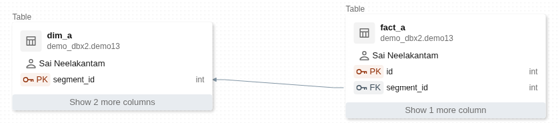
Figura 5. Las claves declaradas tal como las dibuja Catalog Explorer: fact_a.segment_id apunta a la clave primaria de dim_a.
El join también estaba declarado en la definición del espacio: una entrada join_specs enviada con la API de espacios de Genie, de fact_a a dim_a por segment_id, de muchos a uno. Ninguna pantalla de Genie en este workspace mostraba ese join, así que la prueba son las claves declaradas más el SQL que escribe Genie. Al preguntarle por el valor total de un atributo, unió fact_a con dim_a mediante un INNER JOIN por segment_id y respondió 97.00 (figura 6). Lee el SQL generado, no solo la respuesta, para ver qué join eligió.
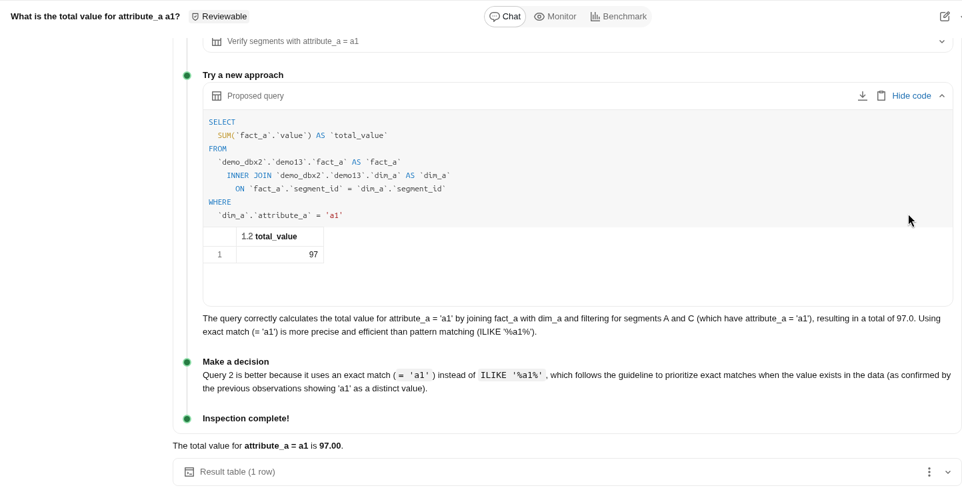
Figura 6. En el SQL generado ves el join que eligió Genie: un INNER JOIN por la clave declarada y después el filtro sobre la dimensión.
La figura 7 explica por qué fracasa un rescate solo con prompts. El ajuste de instrucciones crece. El join equivocado se queda.
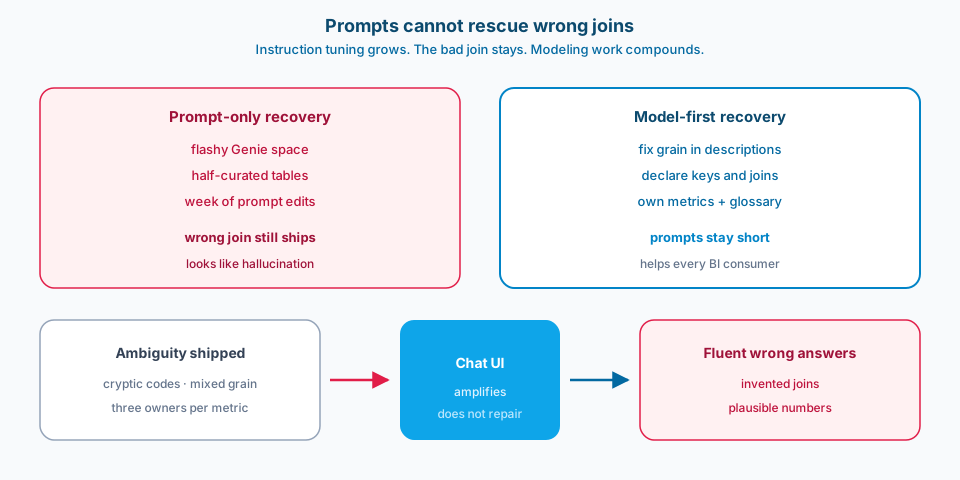
Figura 7. Los prompts no pueden rescatar joins equivocados. La ambigüedad que entregas se convierte en respuestas incorrectas muy bien redactadas en el chat. El trabajo de modelado rinde para cada consumidor de BI.
4. Las métricas tienen una única definición con responsable
Cada métrica necesita una definición, un responsable con nombre y un sitio que la herramienta conversacional pueda leer. Los cálculos que compiten entre tablas gold garantizan que cada uno busque la respuesta que le conviene. Los subconjuntos certificados ayudan: una superficie gold pequeña para Genie gana a "toda producción" con un prompt amable.
5. Clasifica las columnas sensibles antes de abrir el chat
El acceso por chat sigue siendo acceso. El enmascaramiento, la seguridad a nivel de columna y las exclusiones certificadas van en la lista de comprobación de la preparación. Si una persona recién incorporada no debería consultar un campo sin supervisión, no dejes que un agente lo muestre porque la interfaz parecía segura.
6. Certifica un espacio; no lo apuntes a bronze
Bronze y las cargas en bruto son para los ingenieros. Las herramientas conversacionales necesitan estructuras analíticas curadas: granularidad limpia, nombres estables y relaciones probadas. Apuntar Genie a los datos en bruto para "ir más rápido" solo traslada la limpieza a cada pregunta de los usuarios.
La figura 8 es el listón para entrar. Certifica una superficie gold conversacional. Prohíbe los datos en bruto salvo en spikes con plazo cerrado y sin tráfico de usuarios finales.
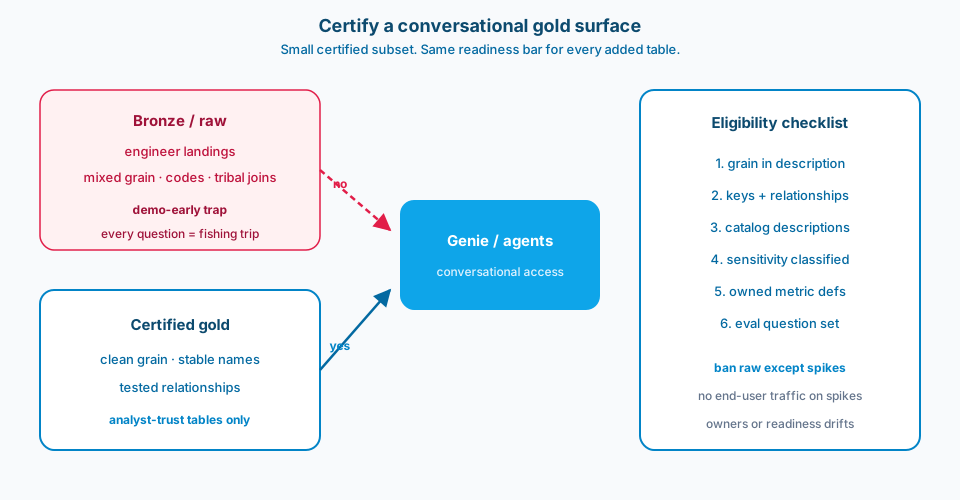
Figura 8. Certifica una superficie gold conversacional. Un subconjunto pequeño y preparado gana a abrir toda producción. Cada tabla nueva necesita el mismo listón.
Las capas de servicio, las API y las interfaces de chat no reparan la ambigüedad de debajo. La amplifican. Si el modelo del warehouse o del lakehouse es difuso, la capa conversacional será difusa con mucha fluidez.
La figura 9 es el planteamiento de Learn sobre los flujos de servicio y de aplicación. El camino de la interfaz no es una herramienta de reparación semántica.
Figura 9. Las capas de servicio y las API no arreglan la ambigüedad semántica de debajo. Fuente: Microsoft Learn: app scenarios.
Errores comunes
Bronze para ir rápido. Los equipos conectan herramientas conversacionales a tablas en bruto para hacer una demo pronto. Cada pregunta se convierte en una expedición de pesca. La confianza nunca se recupera.
Ningún subconjunto gold certificado. Todo está "disponible", así que nada es fiable. Los usuarios desconfían de las respuestas incluso cuando una consulta posterior acierta por casualidad.
Descripciones que repiten los nombres físicos.
Describir key_a como "key a" no le enseña nada al modelo. El significado de negocio lo tiene que escribir alguien que conozca el dominio.
Relaciones que solo están en la cabeza de alguien. El modelo se inventa joins. Depuras "alucinaciones" que en realidad eran claves foráneas que faltaban.
Guerras de métricas. Tres equipos definen cada uno la misma métrica. Genie elige una. El chat provoca una pelea.
Arreglarlo solo con prompts. Semanas ajustando instrucciones sobre un modelo desordenado. Las instrucciones crecen. El join equivocado se queda.
La seguridad como algo secundario. El chat se abre primero; la clasificación de columnas llega después de que alguien pida una columna restringida.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Qué esquemas o modelos semánticos están certificados para el acceso por chat.
- Los metadatos obligatorios en el catálogo antes de admitir una tabla (granularidad, descripciones, claves, sensibilidad).
- Las reglas de responsabilidad sobre relaciones y métricas, incluido cómo se resuelven los conflictos.
- Dónde está el glosario (el catálogo o la capa semántica que la herramienta puede leer, no solo Confluence).
- Cómo se evalúa la calidad de las respuestas: un conjunto fijo de preguntas, los resultados esperados, una revisión de los joins del SQL generado y una cadencia de revisión.
- Una prohibición explícita de apuntar Genie a datos en bruto o a bronze, salvo en spikes con plazo cerrado y sin tráfico de usuarios finales.
Adáptalo antes de usarlo
Un espacio de Genie certificado es más pequeño que el warehouse. Producto presionará para añadir "solo una tabla más". Cada incorporación necesita el mismo listón o volverás a introducir ambigüedad sin darte cuenta.
El trabajo de modelado es más lento que el de prompts. También se acumula. Una granularidad limpia y un glosario ayudan a cada consumidor de BI, no solo al chat. Los parches de prompts ayudan hasta la siguiente versión del modelo o la siguiente columna ambigua.
Necesitarás responsables: quién certifica una tabla, quién edita el glosario, quién firma las definiciones de las métricas. Sin responsables, la preparación se convierte en una limpieza puntual que se va degradando.
Los conjuntos de evaluación cuestan tiempo. Prefiere preguntas de regresión aburridas a una sola demo en directo impresionante.
Pruébalo tú
La demo de preparación para Genie de mi repositorio público tech-demos construye el pequeño hecho y la dimensión con comentarios de granularidad y claves declaradas, además del espacio de Genie con dos tablas, para que puedas comprobar qué join escribe Genie.
Referencias principales: Microsoft Learn sobre lakehouse overview y semantic model best practices for data agents, además de la documentación de Genie o de analítica conversacional de tu plataforma para configurar los espacios.
Arregla el modelado. Así los prompts pueden seguir siendo cortos.