

Puntos clave
- El código nunca cambia entre targets. Solo cambian los enlaces: catálogo, host, programaciones, identidad y permisos.
- Los modos development y production son paquetes de presets, no una escalera. Un target de pruebas sin modo no recibe ninguno de sus valores por defecto de seguridad.
- Una opción en el recurso gana a un preset, y un preset gana al modo. Si escribes a mano una programación como no pausada, se ejecuta en todas partes.
- Las variables del bundle se resuelven en el momento del despliegue. Pasa el catálogo al código como parámetro del job.
- Despliega con un service principal y ejecuta con otro. Cuando son distintos, solo se admiten jobs y pipelines.
Mantén el código idéntico en todos los targets y pon en cada bloque de target solo un conjunto pequeño y explícito de enlaces: catálogo, host, programaciones, identidad de ejecución y permisos. La recompensa: el commit que probaste en dev es el mismo commit que se ejecuta en prod, y una programación o un host escritos a mano no pueden colarse de un entorno al siguiente.
Un bundle no hace esa separación por ti. Desplegará encantado los mismos jobs en tres entornos, pero sus valores por defecto están desequilibrados: el modo development es prudente, el modo production comprueba algunas cosas y un target de pruebas en medio no recibe nada a menos que lo pidas.
Modelo con nombre: código fijo, targets enlazados, identidades separadas
- Código fijo: los notebooks, el SQL y las definiciones de jobs son idénticos en todos los targets. Nada de hosts, catálogos ni IDs en el código.
- Targets enlazados: cada target fija su catálogo, sus programaciones, su identidad de ejecución y sus permisos; el host viene del pipeline.
- Identidades separadas: una identidad de CI despliega; un service principal distinto ejecuta; las personas reciben permisos, no credenciales.
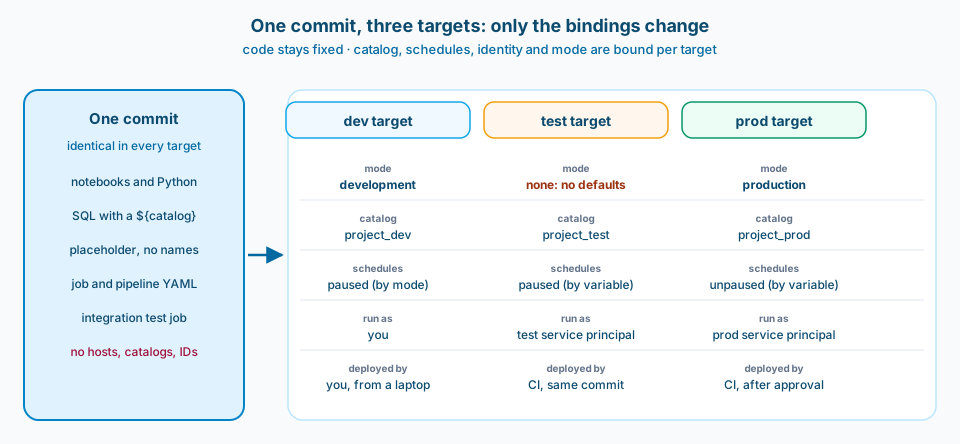
Figura 1. La columna del código nunca cambia. Si algo difiere entre entornos, va en el bloque del target.
Contexto y restricción
Los Declarative Automation Bundles describen jobs, pipelines y otros recursos en YAML junto al código, y la Databricks CLI los despliega por target. Hasta marzo de 2026 se llamaban Databricks Asset Bundles; el cambio de nombre no rompe nada (bundle FAQs).
La plantilla de bundle que mantengo es pequeña: un catálogo por entorno, jobs serverless, un job de pruebas de integración que se despliega con el bundle y un pipeline de Azure DevOps con workload identity federation. Trae dos targets, dev y prod. Lo que sigue sale de decidir qué va en esos bloques de target y qué cambia cuando añades un tercero.
Es el equivalente en Databricks del post 11 (parametrizar los enlaces de entorno) y del post 46 (promocionar por commit).
Diseño
1. Trata los modos como presets, no como una escalera
mode: development añade tu nombre de usuario como prefijo a los nombres de los recursos, etiqueta jobs y pipelines, pausa todas las programaciones y triggers, permite ejecuciones concurrentes y desactiva el bloqueo de despliegue. mode: production valida que los pipelines no estén en modo de desarrollo, comprueba opcionalmente que despliegas desde la rama de Git esperada y espera un service principal como run_as o bien run_as y permissions explícitos (deployment modes).
Los modos son opcionales, y no existe un modo de pruebas. Un target de pruebas sin modo no recibe prefijo, ni pausa de programaciones, ni comprobaciones de producción, salvo que añadas presets.
Luego viene la regla de precedencia de la misma página: las opciones del recurso prevalecen sobre los presets, y los presets sobre el modo. El propio ejemplo de Learn es el que te muerde: una programación fijada como UNPAUSED en el job sigue sin pausar aunque el preset trigger_pause_status del target diga PAUSED. Escribe pause_status: UNPAUSED en el YAML del job porque prod lo necesita, y todos los targets que desplieguen el job lo ejecutarán según la programación. Eso incluye el modo development: un pause_status: UNPAUSED explícito sigue sin pausar también en dev, así que fija tú el valor de dev (deployment modes).
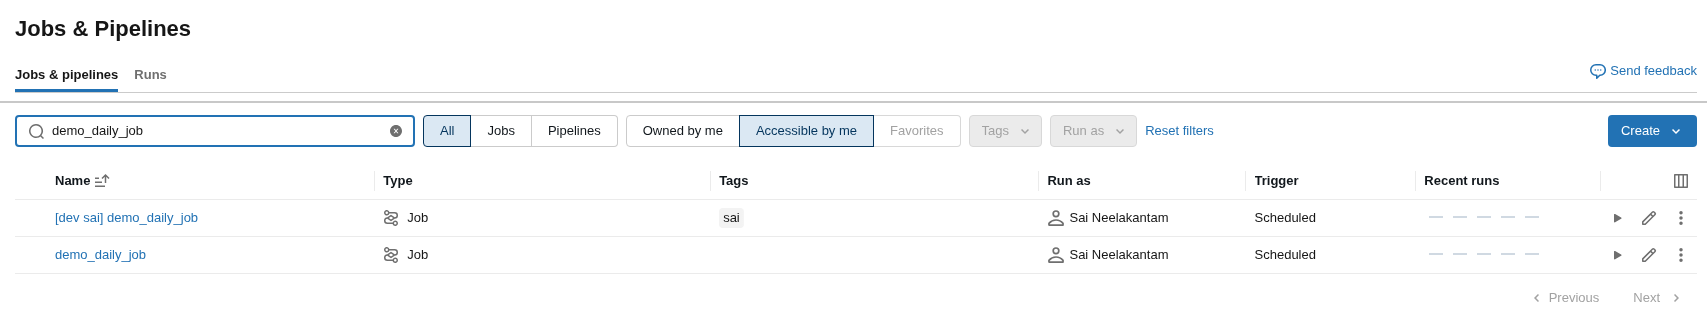
Figura 2. Un bundle desplegado en dev y prod da dos jobs. El modo development añadió el prefijo [dev sai] y una etiqueta, pero el job fija pause_status: UNPAUSED, así que la copia de dev siguió en Scheduled. Cuando hice esta captura, prod no tenía run_as y se ejecutaba como el usuario que desplegaba, algo que no recomiendo para un target de prod real. La figura 4 muestra el mismo job de prod después de añadir un service principal.
Por eso convierto el estado de la programación en una variable, pausada por defecto, y solo la reactivo en el target de prod:
variables:
  catalog:
    description: One Unity Catalog catalog per environment.
  schedule_pause_status:
    default: PAUSED
  test_sp_app_id:
    description: Application ID of the test run principal.
  prod_sp_app_id:
    description: Application ID of the prod run principal.

targets:
  dev:
    mode: development
    default: true
    variables:
      catalog: project_dev
  test:
    variables:
      catalog: project_test
    run_as:
      service_principal_name: ${var.test_sp_app_id}
  prod:
    mode: production
    git:
      branch: main
    variables:
      catalog: project_prod
      schedule_pause_status: UNPAUSED
    run_as:
      service_principal_name: ${var.prod_sp_app_id}
El job lee pause_status: ${var.schedule_pause_status}. Si te olvidas de fijarlo, el job sigue en pausa, que es justo el fallo que quieres.
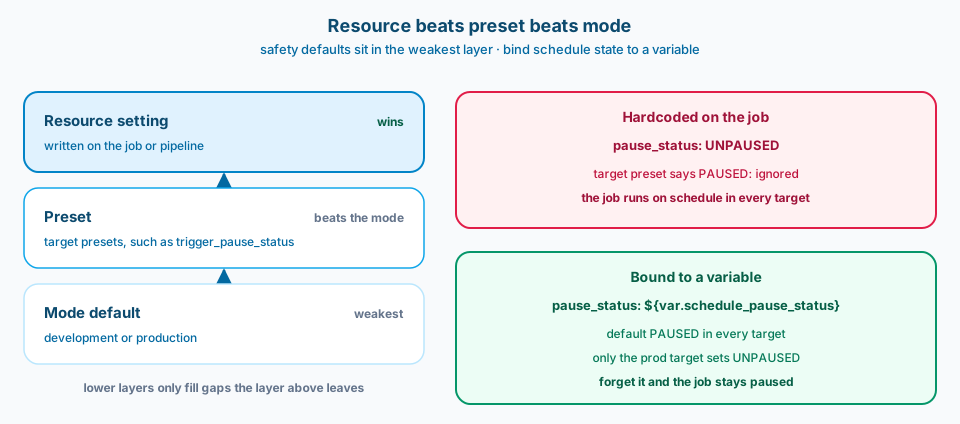
Figura 3. Los valores por defecto de seguridad viven en la capa más débil. Todo lo que escribes en el recurso gana.
2. Enlaza el catálogo al desplegar y léelo al ejecutar
Un catálogo por entorno es la disposición de Unity Catalog más sencilla que conozco que mantiene los entornos separados por diseño. El problema es cómo llega el catálogo al código. Las variables del bundle son valores del momento del despliegue: un job usa los valores de su último despliegue, y pasar otra variable en tiempo de ejecución no surte efecto. Learn dice que uses parámetros del job para los valores de ejecución (substitutions and variables).
Así que el job declara un parámetro catalog cuyo valor por defecto es ${var.catalog}. El SQL usa un marcador ${catalog}, Python lee el parámetro y ningún archivo de la carpeta de código nombra un catálogo. Un pequeño lint en CI hace fallar el build si encuentra en el código un host de workspace, un token, un nombre de catálogo o un ID de clúster.
Un detalle más: la precedencia de las variables va de --var a las variables de entorno BUNDLE_VAR_, al archivo de override por target, a los valores del target y al valor por defecto. Una variable de entorno olvidada en un agente de build gana a tu YAML sin avisar.
3. Separa la identidad de despliegue de la de ejecución
CI despliega como service principal mediante workload identity federation, así que no hay ningún secreto que rotar. En Azure DevOps es una service connection federada con la tarea de Azure CLI y DATABRICKS_AUTH_TYPE=azure-cli (authenticate with Azure DevOps); en GitHub Actions es github-oidc con id-token: write (GitHub Actions). El host del workspace se queda fuera del repo y llega desde variables del pipeline.
Después, las cargas de trabajo se ejecutan como un service principal distinto por entorno mediante run_as. Learn lo considera la forma más segura de ejecutar producción: la identidad de ejecución puede tener menos permisos que quien despliega, y solo ese principal, o alguien autorizado a usarlo, puede desplegar con él (run identity).
En mi demo, el job de prod muestra el service principal en Run as, mientras que yo sigo siendo el creador (figura 4). Dos pasos quedaron fuera del YAML: necesité el rol Service Principal User sobre él antes de que el despliegue pudiera fijarlo como run_as, y la primera ejecución falló con UnauthorizedError hasta que el service principal tuvo acceso al workspace. La segunda ejecución fue bien.
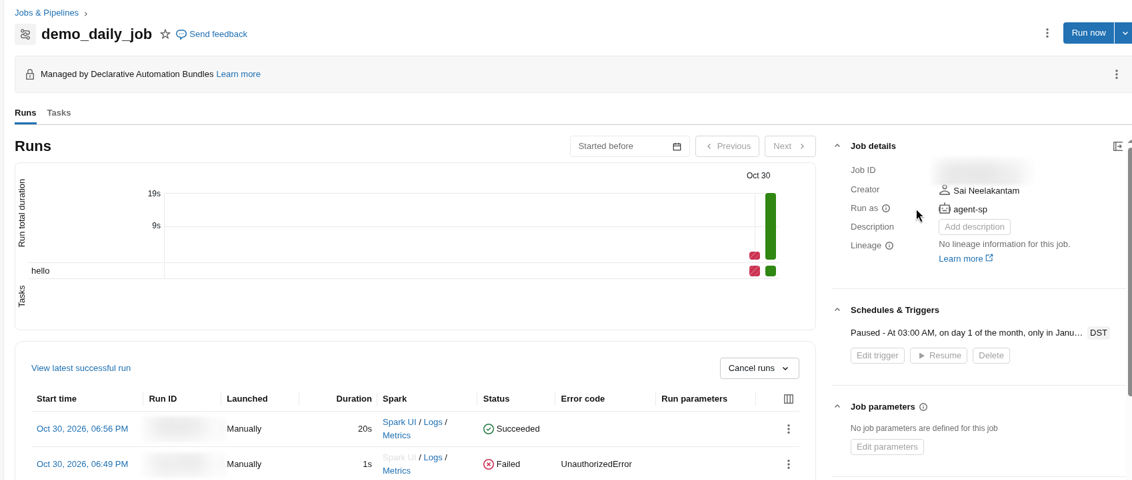
Figura 4. El job de prod se ejecuta como agent-sp, no como yo. La primera ejecución falló antes de que el service principal tuviera acceso al workspace; la segunda fue bien. La programación está pausada solo porque la demo la trae pausada.
Las aristas también están en esa página. Cuando la identidad que despliega es distinta de run_as, solo se admiten jobs y pipelines. El run_as de nivel superior y el del target aceptan un usuario o un service principal, no un grupo, y quien no es administrador solo puede ponerse a sí mismo. Los endpoints de model serving dan error si run_as está fijado en el mismo bundle. Si el bundle va a crecer más allá de jobs y pipelines, decide pronto dónde viven esos recursos.
4. Los permisos sobre jobs no son grants sobre datos
Los permissions de nivel superior dan a usuarios, grupos y service principals CAN_VIEW, CAN_RUN o CAN_MANAGE sobre todo lo que despliega el bundle, y Databricks recomienda ese enfoque. Un mismo principal no puede aparecer a la vez en el mapping de nivel superior y en los permissions propios de un recurso (bundle permissions).
Una trampa de nombres: el bundle usa CAN_RUN, y en un job la interfaz lo muestra como Can Manage Run (figura 5).
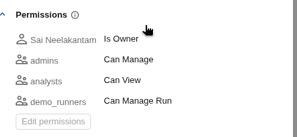
Figura 5. Permisos del job de prod desplegado. El grupo demo_runners recibió CAN_RUN en el bundle y aparece como Can Manage Run.
Esos permisos controlan quién puede ver, ejecutar o editar el job. No deciden qué puede leer y escribir el job. Eso lo deciden los grants de Unity Catalog para la identidad de ejecución sobre su propio catálogo, de modo que el principal de pruebas no puede tocar el catálogo de prod aunque alguien apunte un job hacia él.
En mi demo, el service principal de ejecución tiene USE CATALOG, USE SCHEMA, SELECT y MODIFY sobre su propio catálogo (figura 6).
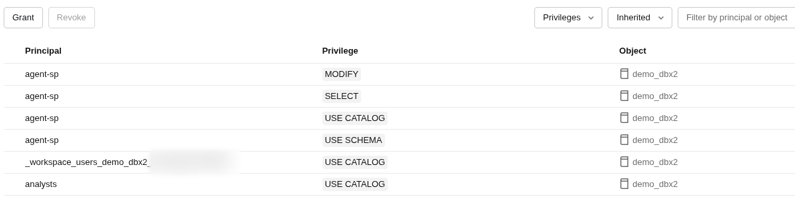
Figura 6. El acceso a datos es un grant de Unity Catalog a la identidad de ejecución, separado de quién puede ver o ejecutar el job.
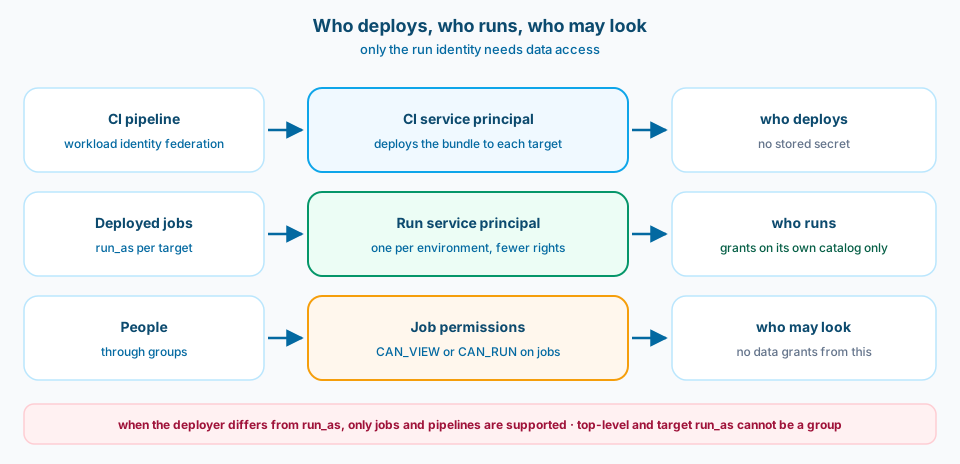
Figura 7. Tres preguntas distintas: quién despliega, quién ejecuta y quién puede mirar. Solo la identidad de ejecución necesita acceso a datos.
5. Promociona el commit y prueba donde se va a ejecutar
Todos los targets despliegan el mismo commit. El pipeline de mi plantilla ejecuta pruebas unitarias del agente sin Spark, despliega en dev, ejecuta el job de pruebas de integración del bundle en serverless con databricks bundle run y solo entonces despliega en prod, detrás de una aprobación de entorno. La comprobación de git.branch en el modo production es un segundo candado: un despliegue en prod desde cualquier otra rama falla salvo que alguien pase --force.
La misma idea que en el post 46: lo que llega a prod es un commit que puedes nombrar, no lo que haya en ese momento en la punta de la rama.
6. Añade un target de pruebas solo cuando aporte algo
Dos targets son una opción real. Un tercero cuesta un catálogo, un principal de ejecución, grants, una etapa de pipeline y datos de prueba. Compensa cuando otros equipos consumen la salida antes de prod, cuando necesitas datos con forma de prod que dev no debe tener o cuando un release necesita una validación formal en un entorno compartido estable. Si las pruebas de integración funcionan bien contra dev, un target de pruebas sobre todo añade otro sitio donde acumular deriva.
Cuando añado uno, copia la forma de prod, no la de dev: sin modo development, un service principal como run_as, programaciones pausadas y su propio catálogo.
Errores comunes
Escribir UNPAUSED a mano en el job. Las opciones del recurso ganan a los presets, así que test se ejecuta con la programación de prod.
Un target de pruebas sin modo y sin presets. No recibe ninguno de los valores por defecto de development ni ninguna de las comprobaciones de production.
Pasar el catálogo como variable del bundle en tiempo de ejecución. Las variables se resuelven al desplegar; usa un parámetro del job.
Nombres de catálogo en los notebooks. Un notebook copiado escribe en el entorno equivocado.
Un único service principal para desplegar y ejecutar. Funciona, pero la identidad de ejecución pasa a necesitar permisos de despliegue.
Permisos del job como acceso a datos. Gobiernan el job, no las tablas.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Código idéntico en todos los targets; el entorno solo en los bloques de target.
- Programaciones pausadas mediante una variable y reactivadas solo en prod.
- El catálogo como parámetro del job, con una variable del bundle como valor por defecto.
- Workload identity federation para CI y un service principal como
run_aspara test y prod.
Adáptalo antes de usarlo
- Si necesitas siquiera un target de pruebas, según los costes del apartado 6.
- Un workspace con un catálogo por entorno o, además, un workspace por entorno, según tus requisitos de aislamiento y de red.
- Si los jobs y pipelines comparten bundle con recursos que no pueden usar un
run_asseparado. - Carpetas de despliegue de solo lectura: la opción de carpetas inmutables está en Private Preview y requiere el motor de despliegue directo (configuration reference).
Pruébalo tú mismo
La demo de bundle para dev y prod de mi repo público tech-demos despliega un job en dos targets, para que veas qué hace el modo development con el nombre del job y su programación.
Relacionado
- Fabric CI/CD: ¿cómo limitas el blast radius entre workspaces de desarrollo? (parametrizar los enlaces de entorno en Fabric)
- Fabric CI/CD: ¿fusionar toda la escalera o hacer cherry-pick de lo que está listo? (promocionar por commit)
- Preparación de data agents: ¿Genie (y los agentes de Fabric) es en realidad un problema de modelado? (cómo debería ser el catálogo de prod cuando alguien le hace preguntas)
El bundle despliega cualquier cosa en cualquier sitio. Decide qué difiere por target, escríbelo una vez y deja que el código siga igual.