

Puntos clave
- Las dos plataformas pueden ejecutar un lakehouse medallion. Las listas de features rara vez deciden; deciden las personas, los consumidores, la gobernanza y el modelo de facturación.
- Si Power BI es el consumidor principal y el equipo piensa en SQL e informes, Fabric parte con ventaja. Si el equipo entrega código con pruebas y CI, la ventaja es de Databricks.
- Una capacidad de Fabric es compartida. Un job pesado en segundo plano puede llevar a los usuarios de informes a retrasos y rechazos.
- Databricks escala a cero, pero alguien tiene que ser responsable de las compute policies, o la factura se reparte entre muchas decisiones pequeñas.
- "Ambos" funciona cuando cada tabla tiene un único owner y los datos fluyen en un solo sentido. Un catálogo reflejado no conserva los grants de Unity Catalog.
Los clientes rara vez preguntan qué plataforma tiene más features. Preguntan de cuál se arrepentirán menos. La respuesta honesta depende menos de las plataformas que de las personas que lo van a operar en su segundo año.
Yo entrego en las dos. Los patrones medallion que uso, historial SCD2 en bronze, silver con la fila actual y gold dimensional, se ven igual en ambas. Lo que cambia es todo lo de alrededor: quién escribe el código, cómo se despliega, quién gobierna el acceso y cómo se comporta el coste.
Modelo con nombre: cinco preguntas, en este orden
- Personas: ¿quién lo construye y lo opera en el segundo año?
- Consumidores: ¿qué lee la capa gold, y es Power BI?
- Huella: ¿dónde aterrizan ya los datos y qué está ya gobernado?
- Coste: ¿una capacidad compartida que reservas o compute que pagas por uso?
- Extremo: ¿hay streaming o machine learning que marque el listón?
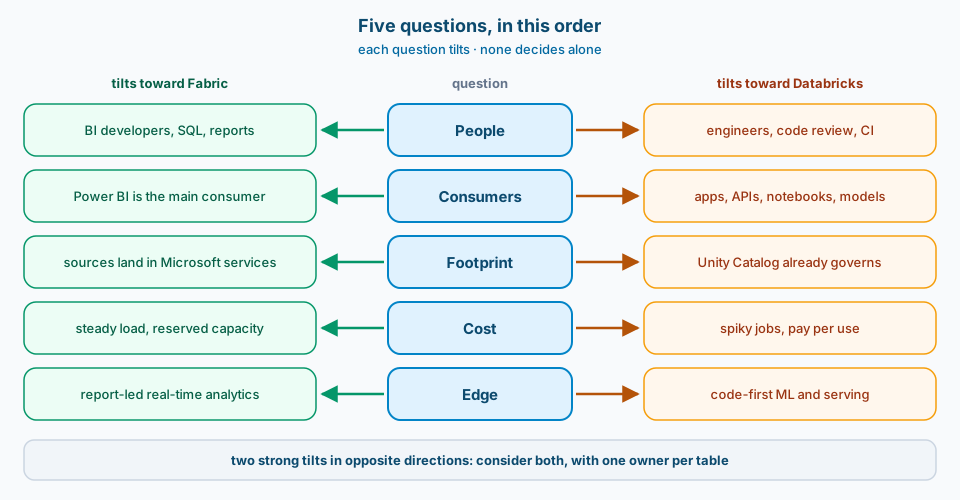
Figura 1. Cada pregunta inclina; ninguna decide sola. Dos inclinaciones fuertes en sentidos opuestos son la señal para usar ambas.
Contexto y restricción
Esto es un marco, no una tabla de puntuación. No pondero las preguntas ni las sumo; busco la una o las dos que no son negociables para ese cliente y dejo que manden. El estado de los productos que sigue es a octubre de 2026, con enlaces a Learn donde importa.
Diseño
1. Personas: quién lo opera en el segundo año
Fabric baja la barrera de entrada: pipelines, Dataflows, notebooks y Power BI en un workspace y en un solo sitio que mirar. Para un equipo de desarrolladores de BI y analistas es una ventaja real. El problema llega después: los workspaces low-code crecen rápido y se despliegan mal si nadie aporta disciplina de Git desde el principio. El post 11 y el post 46 muestran lo que cuesta esa disciplina.
Databricks da por hecho que hay ingenieros: código en un repo, bundles, pruebas, un pipeline. El post 50 muestra la escalera. Dáselo a un equipo sin ingenieros y no se vuelve más sencillo: se abandona, y los notebooks se editan en el workspace.
Así que mi primera pregunta no va de datos en absoluto: ¿quién, por parte del cliente, puede revisar un pull request?
2. Consumidores: ¿Power BI es lo importante?
En la mayoría de mis proyectos, Power BI es donde el negocio se encuentra con los datos, sea cual sea la plataforma que haya debajo. Si es el consumidor principal, Fabric se ahorra un salto: Direct Lake lee tablas Delta en OneLake sin refresh de importación, y el semantic model vive junto a los datos (post 9, post 24).
Los datos de Databricks también pueden llegar a Direct Lake. Un catálogo de Azure Databricks reflejado en Fabric está disponible de forma general: Fabric refleja la estructura del catálogo, lee las tablas a través de shortcuts sin copiarlas y puedes construir informes con Direct Lake encima (mirrored catalog). Los cambios pueden tardar de segundos a minutos en aparecer. Ten en cuenta dos requisitos previos: el privilegio EXTERNAL USE SCHEMA en el lado de Unity Catalog y acceso de red desde Fabric a la cuenta de almacenamiento que hay detrás del catálogo (tutorial). Publicar un catálogo en OneLake desde el lado de Databricks es una segunda vía, todavía en Public Preview (Fabric with Azure Databricks).
Si la capa gold también alimenta aplicaciones, APIs y notebooks y modelos de otros equipos, Power BI es un consumidor entre muchos y deja de ser el factor decisivo.
3. Huella: qué está ya gobernado
Dónde aterrizan hoy los datos importa más que dónde podrían aterrizar. Un cliente con una configuración de Unity Catalog ya existente, con grupos y grants en su sitio, no debería reconstruir esa gobernanza en otro producto para ahorrar un salto a los informes. Un cliente cuyas fuentes ya aterrizan en servicios de Microsoft y que aún no tiene lakehouse no tiene nada de lo que migrar.
El problema es tener la gobernanza en dos sitios. Los grants de Unity Catalog no viajan con un catálogo reflejado: el mismo tutorial te dice que configures el acceso en el modelo de permisos propio de Fabric, y las tablas con filtros de fila o máscaras de columna no se reflejan en absoluto (limitations). En el lado de Fabric, OneLake security está disponible de forma general, pero sus roles no restringen a los Admins, Members y Contributors del workspace (OneLake row and column security). Los roles del workspace son una decisión de seguridad, no una comodidad.
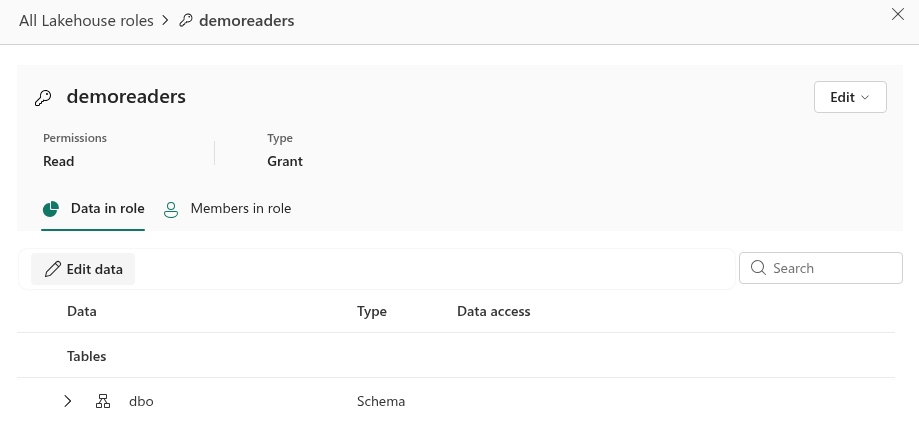
Figura 2. El rol de OneLake concede Read sobre un esquema, y se configura en el lakehouse, no en el workspace.
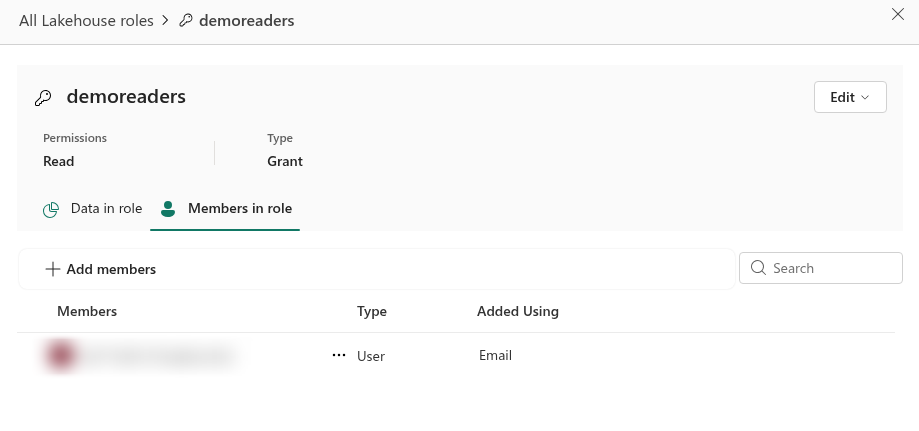
Figura 3. Los miembros se añaden al rol de OneLake por separado del acceso al workspace, y el rol no restringe a los Admins, Members y Contributors del workspace.
4. Coste: reservado y compartido, o por uso
Aquí no hay cifras, porque envejecen mal y dependen de tu contrato. Lo que importa es la forma.
Una capacidad de Fabric es compute reservado que comparten todas las cargas de trabajo que hay en ella. El smoothing reparte los jobs en segundo plano a lo largo de las 24 horas siguientes, lo que hace agradables las cargas estables. Pero si la sobrecargas, Fabric primero retrasa y luego rechaza las solicitudes interactivas, y los usuarios de informes son las solicitudes interactivas (throttling). Un job nocturno sobredimensionado se convierte en una mañana de informes lentos. Las soluciones habituales son capacidades separadas o la facturación bajo demanda para Spark, que saca Spark de la capacidad (on-demand billing for Spark).
Databricks factura el compute mientras se ejecuta, y el compute inactivo puede no costar nada. Eso encaja con cargas con picos. El problema es la responsabilidad: sin compute policies, terminación automática y etiquetas, la factura es la suma de muchas decisiones pequeñas que nadie revisa.
5. Extremo: streaming y machine learning
Las dos plataformas hacen streaming y las dos hacen machine learning. La pregunta es hasta qué punto. El ML code-first con su propio ciclo de vida, pipelines de features y model serving se inclina hacia Databricks. Los datos de eventos que los usuarios de negocio exploran y sobre los que configuran alertas se inclinan hacia Real-Time Intelligence de Fabric. Si ninguna de las dos cosas está en la hoja de ruta, no dejes que una hipotética elija la plataforma.
6. Cuando la respuesta honesta es ambas
Dos inclinaciones fuertes en sentidos opuestos, por ejemplo un equipo de ingeniería con una configuración de Unity Catalog ya existente y un negocio que vive en Power BI, suelen significar ambas. El patrón en el que confío: Databricks se encarga de la ingeniería y de las tablas; Fabric refleja el catálogo gold y se encarga de los semantic models y los informes.
Funciona si se cumplen tres reglas. Cada tabla tiene un owner y un único escritor. Los datos fluyen en un solo sentido por capa. Y el acceso se diseña dos veces a propósito: Unity Catalog para el lado de ingeniería, permisos de Fabric y OneLake security para los consumidores, revisados juntos.
El sentido inverso también existe. Azure Databricks puede leer tablas de Fabric Lakehouse y Warehouse mediante OneLake catalog federation, solo en lectura, y hay que activar varias opciones del tenant de Fabric (OneLake federation). Escribir desde Databricks en OneLake a través de una external location está en Beta, y Learn advierte que cualquiera que no sea viewer en ese workspace de Fabric puede leer, escribir y borrar los datos (OneLake external location). Yo todavía no construiría un flujo bidireccional sobre eso.
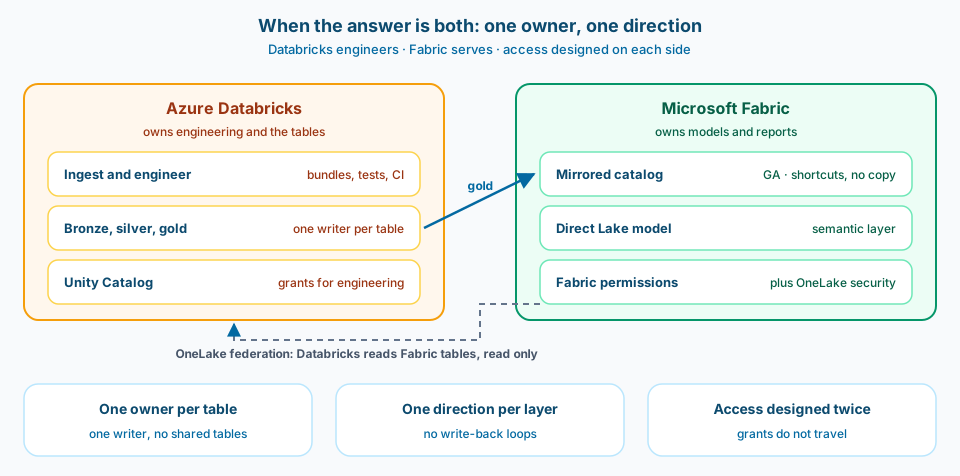
Figura 4. Un owner por tabla, un sentido por capa, dos modelos de permisos diseñados a propósito.
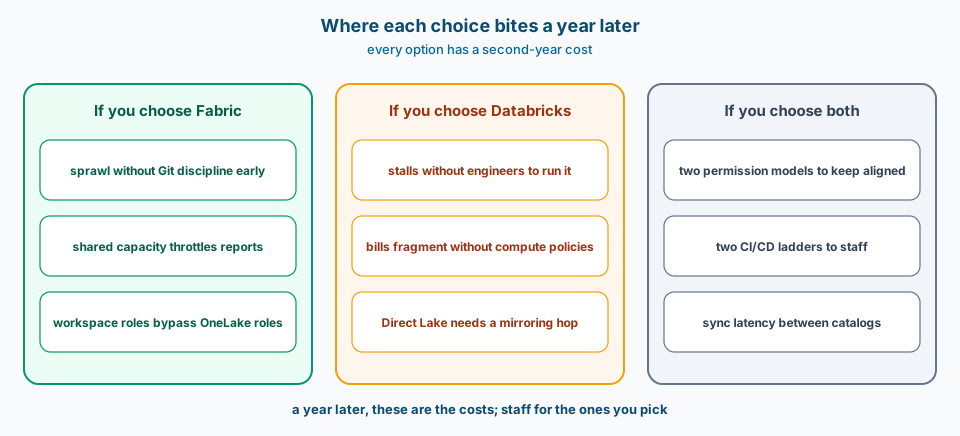
Figura 5. Elige los problemas para los que tengas personas.
Errores comunes
Elegir por la lista de features. Las dos tienen la feature; la pregunta es quién la va a operar.
Una sola capacidad para ingeniería e informes. El job nocturno ralentiza la mañana.
Databricks sin ingenieros. Acaba en notebooks editados a mano y una factura sin responsable.
Dar por hecho que reflejado significa gobernado. Los grants de Unity Catalog se quedan atrás; las tablas con máscaras no se reflejan.
Contributor del workspace por comodidad. Se salta los roles de OneLake security.
"Ambos" sin owner por tabla. Dos escritores, dos verdades.
Dejar que un futuro proyecto de ML decida hoy. Decide según lo que está en la hoja de ruta.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Las cinco preguntas, primero las personas.
- Un owner y un único escritor por tabla cuando usas las dos.
- Separar la ingeniería pesada de la capacidad de informes, o sacar Spark de ella.
- Diseñar el acceso de forma explícita en cada lado, sin dar nunca por hecho que se traslada.
Adáptalo antes de usarlo
- El orden entre consumidores y huella, cuando lo que ya existe es grande.
- Cómo divides la capacidad, por carga de trabajo o por entorno.
- Si los informes leen un catálogo reflejado o una capa gold copiada, teniendo en cuenta la latencia de sincronización y los límites con filtros de fila y máscaras de columna.
- Si necesitas siquiera el flujo inverso.
Pruébalo tú mismo
Los objetos de demo de Fabric y Databricks para este post están en mi repo público tech-demos, con un bundle y una compute policy que puedes desplegar para reconstruir el lado de Databricks.
Relacionado
- Databricks Bundles: ¿qué cambia en cada target? (lo que cuesta la escalera en Databricks)
- Fabric CI/CD: ¿cómo limitas el blast radius entre workspaces de desarrollo? (lo que cuesta la escalera en Fabric)
- Preparación de data agents: ¿Genie (y los agentes de Fabric) es en realidad un problema de modelado? (el modelado importa en las dos)
- Shortcuts de OneLake: ¿deberían quedarse solo en bronze? (dónde encajan los shortcuts en una arquitectura medallion)
- Direct Lake: ¿todavía hay que refrescar un semantic model? (el lado de Power BI del salto)
Elige la plataforma que tu equipo pueda operar y diseña las juntas a propósito.