

Das Wichtigste in Kürze
- Beide Plattformen können ein Medallion-Lakehouse betreiben. Feature-Listen entscheiden selten; Menschen, Konsumenten, Governance und das Abrechnungsmodell schon.
- Wenn Power BI der Hauptkonsument ist und das Team in SQL und Berichten denkt, liegt Fabric vorn. Wenn das Team Code mit Tests und CI ausliefert, liegt Databricks vorn.
- Eine Fabric-Kapazität ist geteilt. Ein schwerer Hintergrundjob kann Berichtsnutzer in Verzögerungen und Ablehnungen drängen.
- Databricks skaliert auf null, aber jemand muss die Compute Policies verantworten, sonst verteilt sich die Rechnung auf viele kleine Entscheidungen.
- "Beides" funktioniert, wenn jede Tabelle einen Owner hat und die Daten in eine Richtung fließen. Ein gespiegelter Catalog übernimmt keine Grants aus Unity Catalog.
Kunden fragen selten, welche Plattform mehr Features hat. Sie fragen, welche sie weniger bereuen werden. Die ehrliche Antwort hängt weniger von den Plattformen ab als von den Menschen, die das Ganze im zweiten Jahr betreiben.
Ich liefere auf beiden. Die Medallion-Muster, die ich verwende, SCD2-Historie in bronze, silver mit dem aktuellen Stand, dimensionales gold, sehen auf beiden gleich aus. Was sich ändert, ist alles drumherum: wer den Code schreibt, wie er deployt wird, wer den Zugriff regelt und wie sich die Kosten verhalten.
Benanntes Modell: fünf Fragen, in dieser Reihenfolge
- Menschen: Wer baut und betreibt es im zweiten Jahr?
- Konsumenten: Was liest die Gold-Schicht, und ist das Power BI?
- Bestand: Wo landen die Daten schon heute, und was ist bereits geregelt?
- Kosten: eine geteilte Kapazität, die du reservierst, oder Compute, das du nach Nutzung bezahlst?
- Spezialfall: Gibt es Streaming oder Machine Learning, das die Messlatte setzt?
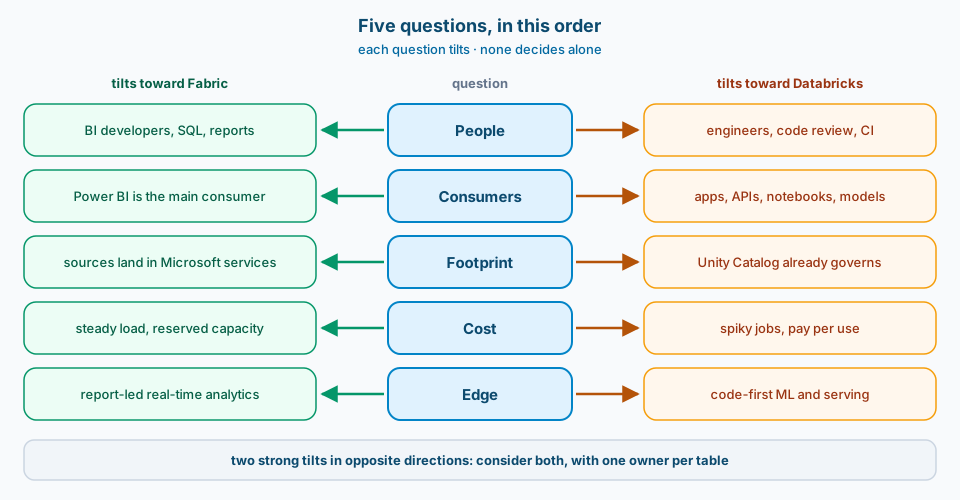
Abbildung 1. Jede Frage gibt eine Neigung vor; keine entscheidet allein. Zwei starke Neigungen in entgegengesetzte Richtungen sind das Signal für beides.
Kontext und Rahmenbedingung
Das ist ein Denkrahmen, keine Scorecard. Ich gewichte die Fragen nicht und zähle sie nicht zusammen; ich suche die eine oder zwei, die für diesen Kunden nicht verhandelbar sind, und lasse sie führen. Der Produktstand unten entspricht Oktober 2026, mit Links zu Learn, wo es darauf ankommt.
Design
1. Menschen: Wer betreibt es im zweiten Jahr?
Fabric senkt die Einstiegshürde: Pipelines, Dataflows, Notebooks und Power BI in einem Workspace und an einem Ort. Für ein Team aus BI-Entwicklern und Analysten ist das ein echter Vorteil. Der Haken kommt später: Low-Code-Workspaces wachsen schnell und lassen sich schlecht deployen, wenn niemand früh Git-Disziplin mitbringt. Beitrag 11 und Beitrag 46 zeigen, was diese Disziplin kostet.
Databricks setzt Engineers voraus: Code in einem Repo, Bundles, Tests, eine Pipeline. Beitrag 50 zeigt die Leiter. Gib das einem Team ohne Engineers, und es wird nicht einfacher, sondern es wird aufgegeben, und Notebooks werden direkt im Workspace bearbeitet.
Meine erste Frage hat deshalb gar nichts mit Daten zu tun: Wer auf Kundenseite kann einen Pull Request reviewen?
2. Konsumenten: Geht es um Power BI?
In den meisten meiner Projekte ist Power BI der Ort, an dem das Geschäft auf die Daten trifft, egal welche Plattform darunter liegt. Wenn es der Hauptkonsument ist, spart Fabric einen Zwischenschritt: Direct Lake liest Delta-Tabellen in OneLake ohne Import-Refresh, und das semantic model liegt neben den Daten (Beitrag 9, Beitrag 24).
Daten aus Databricks können Direct Lake trotzdem erreichen. Ein gespiegelter Azure Databricks Catalog in Fabric ist allgemein verfügbar: Fabric spiegelt die Catalog-Struktur, liest die Tabellen über Shortcuts, ohne sie zu kopieren, und du kannst darauf Berichte mit Direct Lake bauen (mirrored catalog). Änderungen können Sekunden bis Minuten brauchen, bis sie sichtbar sind. Plane zwei Voraussetzungen ein: das Privileg EXTERNAL USE SCHEMA auf der Seite von Unity Catalog und Netzwerkzugriff von Fabric auf das Storage Account hinter dem Catalog (tutorial). Einen Catalog von der Databricks-Seite aus in OneLake zu veröffentlichen, ist ein zweiter Weg, noch in Public Preview (Fabric with Azure Databricks).
Wenn die Gold-Schicht auch Anwendungen, APIs, Notebooks und Modelle anderer Teams versorgt, ist Power BI ein Konsument unter vielen und hört auf, der entscheidende Faktor zu sein.
3. Bestand: Was ist bereits geregelt?
Wo die Daten heute landen, zählt mehr als wo sie landen könnten. Ein Kunde mit einem bestehenden Setup in Unity Catalog, mit Gruppen und Grants, die schon eingerichtet sind, sollte diese Governance nicht in einem anderen Produkt neu bauen, nur um Berichten einen Zwischenschritt zu ersparen. Ein Kunde, dessen Quellen schon in Microsoft-Diensten landen und der noch kein Lakehouse hat, muss von nichts weg migrieren.
Der Haken ist Governance an zwei Orten. Grants aus Unity Catalog wandern nicht mit einem gespiegelten Catalog mit: Dasselbe Tutorial sagt dir, den Zugriff im eigenen Berechtigungsmodell von Fabric einzurichten, und Tabellen mit Zeilenfiltern oder Spaltenmasken werden gar nicht gespiegelt (limitations). Auf der Fabric-Seite ist OneLake security allgemein verfügbar, aber ihre Rollen schränken Workspace-Admins, Members und Contributors nicht ein (OneLake row and column security). Workspace-Rollen sind eine Sicherheitsentscheidung, keine Bequemlichkeit.
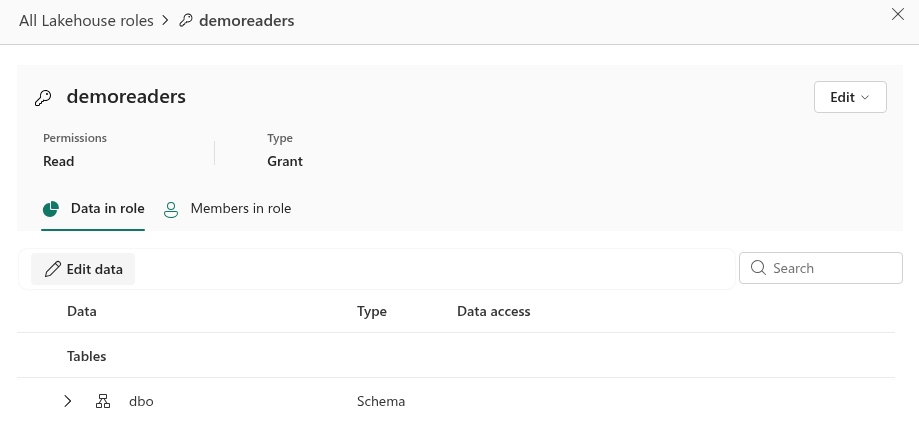
Abbildung 2. Die OneLake-Rolle gewährt Read auf ein Schema, und sie wird am Lakehouse gesetzt, nicht am Workspace.
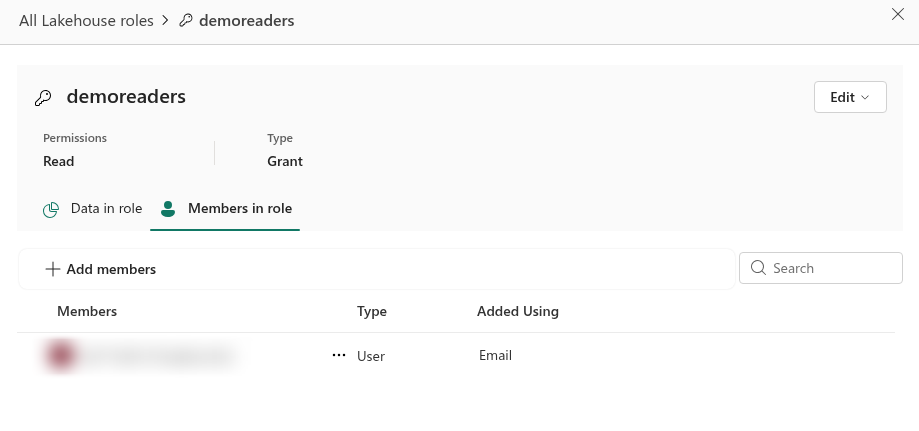
Abbildung 3. Mitglieder werden der OneLake-Rolle getrennt vom Workspace-Zugriff hinzugefügt, und Workspace-Admins, Members und Contributors werden von ihr nicht eingeschränkt.
4. Kosten: reserviert und geteilt oder nach Nutzung
Hier stehen keine Zahlen, weil sie schlecht altern und von deinem Vertrag abhängen. Es kommt auf die Muster an.
Eine Fabric-Kapazität ist reserviertes Compute, das sich alle Workloads darauf teilen. Smoothing verteilt Hintergrundjobs über die nächsten 24 Stunden, was gleichmäßige Lasten angenehm macht. Überlastest du sie aber, verzögert Fabric zuerst interaktive Anfragen und lehnt sie dann ab, und Berichtsnutzer sind die interaktiven Anfragen (throttling). Ein überdimensionierter nächtlicher Job wird zu einem Morgen voller langsamer Berichte. Getrennte Kapazitäten oder On-Demand-Abrechnung für Spark, die Spark aus der Kapazität herausnimmt (on-demand billing for Spark), sind die üblichen Lösungen.
Databricks rechnet Compute während der Laufzeit ab, und Compute im Leerlauf kann nichts kosten. Das passt zu sprunghaften Lasten. Der Haken ist die Verantwortung: Ohne Compute Policies, automatisches Beenden und Tags ist die Rechnung die Summe vieler kleiner Entscheidungen, die niemand prüft.
5. Spezialfall: Streaming und Machine Learning
Beide Plattformen können Streaming und beide können Machine Learning. Die Frage ist, wie tief es geht. Code-first ML mit eigenem Lebenszyklus, Feature-Pipelines und Model Serving spricht für Databricks. Ereignisdaten, die Fachanwender erkunden und auf die sie Alerts setzen, sprechen für Real-Time Intelligence in Fabric. Wenn beides nicht auf der Roadmap steht, lass kein hypothetisches Projekt die Plattform wählen.
6. Wenn die ehrliche Antwort beides ist
Zwei starke Neigungen in entgegengesetzte Richtungen, zum Beispiel ein Engineering-Team mit bestehendem Setup in Unity Catalog und ein Geschäft, das in Power BI lebt, bedeuten meist beides. Das Muster, dem ich vertraue: Databricks verantwortet das Engineering und die Tabellen; Fabric spiegelt den Gold-Catalog und verantwortet semantic models und Berichte.
Es funktioniert, wenn drei Regeln gelten. Jede Tabelle hat einen Owner und einen Schreiber. Die Daten fließen pro Schicht in eine Richtung. Und der Zugriff wird bewusst zweimal entworfen: Unity Catalog für die Engineering-Seite, Fabric-Berechtigungen und OneLake security für die Konsumenten, gemeinsam reviewt.
Die umgekehrte Richtung gibt es auch. Azure Databricks kann Tabellen aus Fabric Lakehouse und Warehouse über OneLake Catalog Federation lesen, nur lesend, und dafür müssen mehrere Fabric-Tenant-Einstellungen aktiviert werden (OneLake federation). Das Schreiben von Databricks nach OneLake über eine External Location ist in Beta, und Learn warnt, dass jeder in diesem Fabric-Workspace, der mehr als Viewer ist, die Daten lesen, schreiben und löschen kann (OneLake external location). Einen Fluss in beide Richtungen würde ich darauf noch nicht bauen.
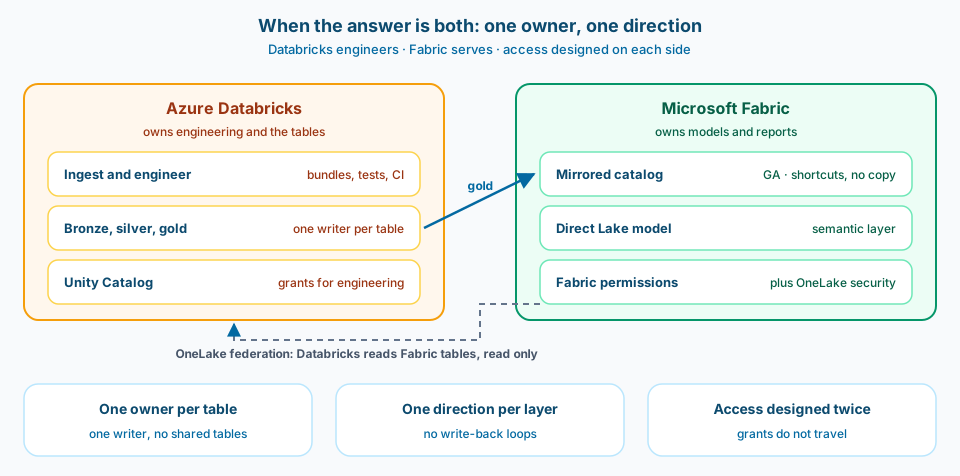
Abbildung 4. Ein Owner pro Tabelle, eine Richtung pro Schicht, zwei bewusst entworfene Berechtigungsmodelle.
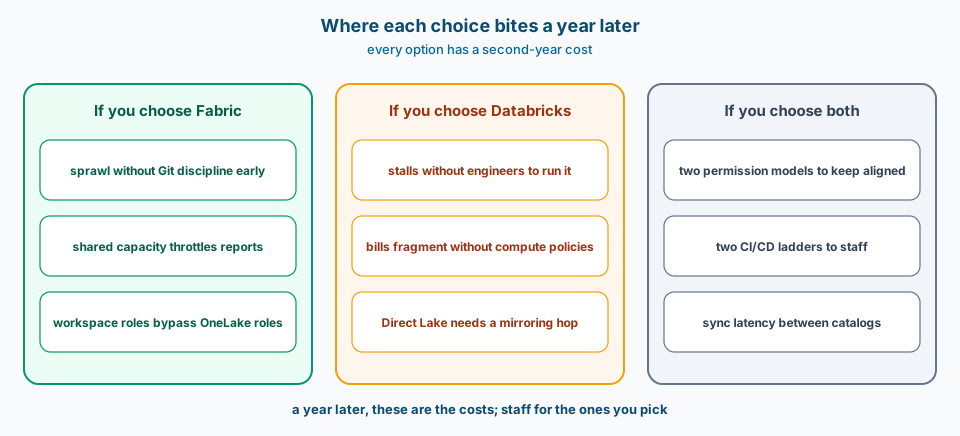
Abbildung 5. Wähle die Schmerzpunkte, für die du Leute hast.
Häufige Fehler
Nach der Feature-Liste wählen. Beide haben das Feature; die Frage ist, wer es betreibt.
Eine Kapazität für Engineering und Berichte. Der nächtliche Job bremst den Morgen.
Databricks ohne Engineers. Am Ende stehen bearbeitete Notebooks und eine Rechnung, für die niemand verantwortlich ist.
Annehmen, gespiegelt heiße geregelt. Grants aus Unity Catalog bleiben zurück; maskierte Tabellen werden nicht gespiegelt.
Workspace Contributor aus Bequemlichkeit. Das umgeht die Rollen von OneLake security.
"Beides" ohne Tabellen-Ownership. Zwei Schreiber, zwei Wahrheiten.
Ein künftiges ML-Projekt heute entscheiden lassen. Entscheide nach dem, was auf der Roadmap steht.
So übernehmen oder anpassen
So übernehmen
- Die fünf Fragen, Menschen zuerst.
- Ein Owner und ein Schreiber pro Tabelle, wenn du beide betreibst.
- Schweres Engineering von der Berichtskapazität trennen oder Spark aus ihr herausnehmen.
- Den Zugriff auf jeder Seite explizit entwerfen, nie annehmen, dass er mitwandert.
Vor dem Einsatz anpassen
- Die Reihenfolge von Konsumenten und Bestand, wenn das Vorhandene groß ist.
- Wie du die Kapazität aufteilst, nach Workload oder nach Umgebung.
- Ob Berichte einen gespiegelten Catalog oder eine kopierte Gold-Schicht lesen, angesichts der Sync-Latenz und der Grenzen bei Zeilenfiltern und Spaltenmasken.
- Ob du die umgekehrte Richtung überhaupt brauchst.
Probier es selbst aus
Die Demo-Objekte für Fabric und Databricks zu diesem Beitrag liegen in meinem öffentlichen Repo tech-demos, mit einem Bundle und einer Compute Policy, die du deployen kannst, um die Databricks-Seite nachzubauen.
Verwandte Notizen
- Databricks Bundles: Was ändert sich pro Target? (was die Leiter in Databricks kostet)
- Fabric CI/CD: Wie begrenzt du den Blast Radius über Dev-Workspaces hinweg? (was die Leiter in Fabric kostet)
- Data Agent Readiness: Sind Genie (und Fabric Agents) wirklich ein Modellierungsproblem? (Modellierung zählt auf beiden)
- OneLake Shortcuts: Sollten Shortcuts nur in Bronze bleiben? (wohin Shortcuts in einer Medallion-Architektur gehören)
- Direct Lake: Muss ein semantic model noch aktualisiert werden? (die Seite von Power BI beim Zwischenschritt)
Wähle die Plattform, die dein Team betreiben kann, und entwirf die Nahtstellen bewusst.