
Das Wichtigste in Kürze
- Eine große Faktentabelle ist ein Fakt in Gold mit schriftlich festgelegter Granularität.
- Key-Matching und Anreicherung werden mit den Schwester-Faktentabellen geteilt.
- Direct Lake (oder eine dokumentierte Ausnahme) für Faktentabellen mit hohem Volumen.
- Beschriftungen, Ordner und Beschreibungen sind beim Veröffentlichen Pflicht.
- Das Verhalten von Watermark und bereinigten Views in Bronze ist neben dem Fakt dokumentiert.
- Join-Tests über Fakten hinweg mit Fixture-Keys, einschließlich nicht zugeordneter Fälle.
Eine Quelltabelle, die nach der Pipeline benannt ist, die sie befüllt, lädt dazu ein, sie wie ein Wegwerf-Log zu behandeln. Berichte erfinden dann Granularität, Matching und Beschriftungen in DAX neu. Das Volumen drängt in den Import-Modus, bis der Refresh zum wöchentlichen Ausfall wird.
Benenne das fachliche Konzept. Reichere mit derselben Matching-Logik an, die die Schwester-Faktentabelle nutzt. Leg die Tabelle für Direct Lake in Gold ab. Beschriftungen, Abfrageordner und Beschreibungen gehören zur semantischen Übergabe. Watermark-Abkürzungen und bereinigte Views gehören zur Geschichte von Bronze nach Gold, nicht in die Fußnoten.
Benanntes Modell: große Faktentabellen in Gold
- Benennen: Nenn das Gold-Objekt so, wie die Analysten es nennen, nicht wie die Quelltabelle der Pipeline.
- Anreichern: Löse die Keys gegen die Dimensionstabelle mit demselben Matching-Modul auf, das die Schwester-Faktentabelle nutzt.
- Speichern: Direct Lake ist der Standard für Faktentabellen mit hohem Volumen, wenn das Delta-Layout mitspielt; Import nur als begrenzte Ausnahme.
- Übergeben: Beschriftungen, Abfrageordner, Beschreibungen, Doku zur Watermark und Join-Tests mit Fixtures werden mit dem Fakt ausgeliefert.
- Vertrag: Volumen ohne Granularität und gemeinsame Anreicherung ist nur ein schnelleres Chaos. Die Wahl des Modus verzeiht keinen semantischen Drift.
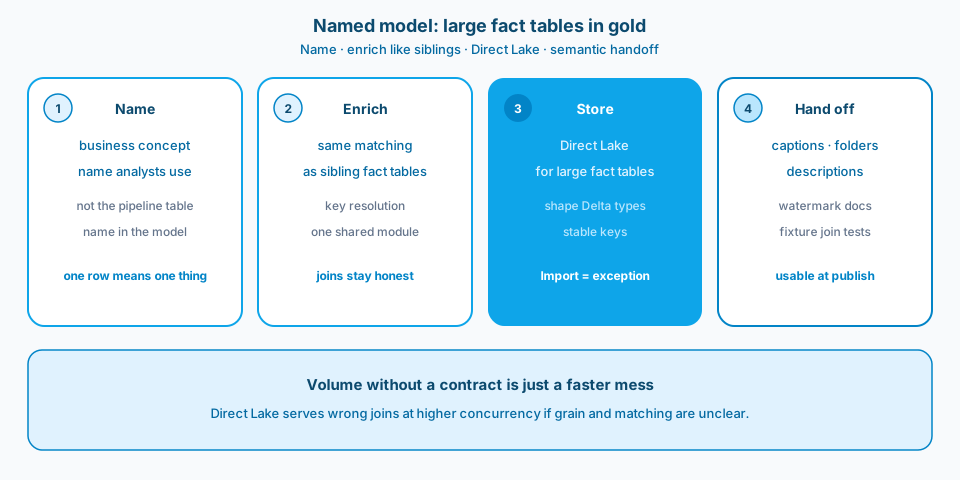
Abbildung 1. Große Faktentabellen in Gold. Benenne das fachliche Konzept, reichere wie die Schwester-Faktentabelle an, bevorzuge bei Volumen Direct Lake und übergib die Beschriftungen zusammen mit der Tabelle.
Kontext und Rahmenbedingung
Ein häufiger Fehler: Zeilenvolumen, die "im Labor in Ordnung" waren, treffen auf Refresh-Fenster im Import-Modus und auf Keys, die nicht zur Schwester-Faktentabelle passen. Der Lake hatte die Daten. Das semantic model hatte ein Log mit Ambitionen.
Direct Lake ist die Standardhaltung für große Faktentabellen, wenn das Delta-Layout mitspielt. Import ist bei dieser Granularität eine Falle. Die Anreicherung muss zum Matching der Schwester-Faktentabelle passen, damit Berichte sauber joinen, statt sich seitenübergreifend zu widersprechen. Watermarks und bereinigte Views in Bronze speisen Gold; sie ersetzen keinen Vertrag für den Fakt.
Abbildung 2 zeigt die Learn-Seite, die die Geschichte des Ziels sichtbar macht: Daten mit hohem Volumen landen als modellierte Ziele, nicht als Log-Haufen, den nur Import in einen Bericht hineinschummeln kann.
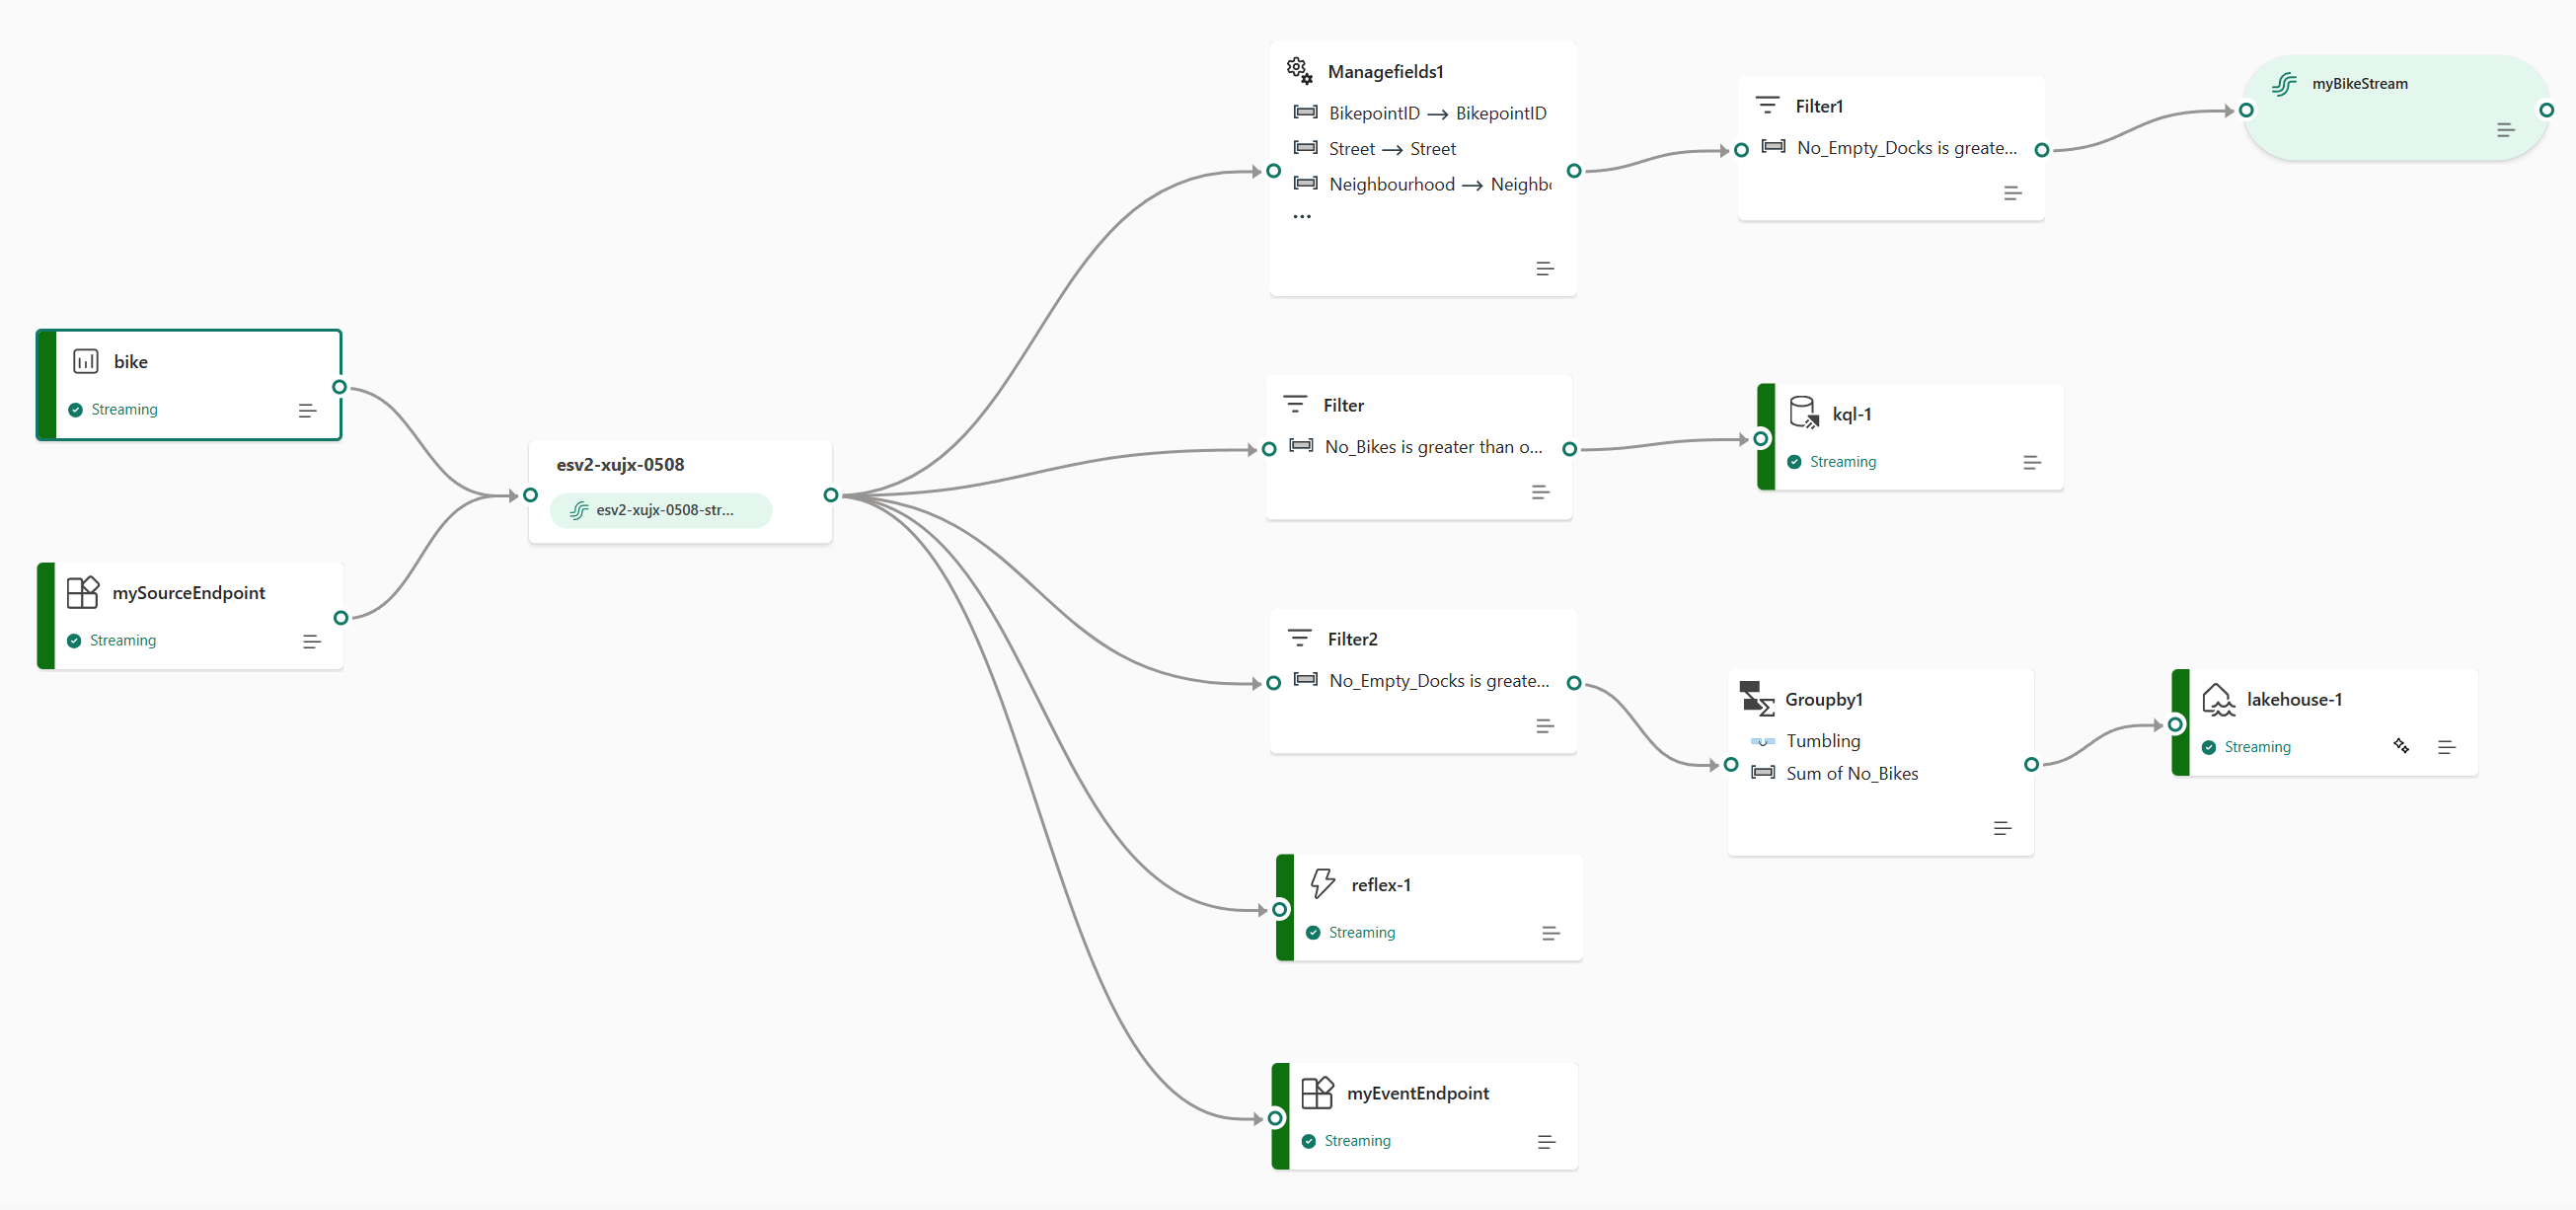
Abbildung 2. Daten mit hohem Volumen sind ein Fakt. Leg sie als modelliertes Ziel ab, nicht als Log-Haufen, den nur der Import-Modus in einen Bericht hineinschummeln kann. Quelle: Microsoft Learn: Eventstreams overview.
Design
1. Benenne das fachliche Konzept, nicht die Pipeline-Tabelle
Nenn das Gold-Objekt so, wie die Analysten es nennen. Pipeline-Namen (source_table_v3_compact) gehören in die Lineage-Doku, nicht in die Feldliste des semantischen Modells. Die Sprache entscheidet mit, ob Leute einen Fakt modellieren oder einen Dump.
2. Teile die Matching-Logik mit der Schwester-Faktentabelle
Wenn Faktentabelle A ihre Keys über ein Modul gegen eine Dimensionstabelle auflöst, nutzt Faktentabelle B dasselbe Modul. Unterschiedliches Matching erzeugt Zahlen, die sich zwischen Seiten widersprechen. Gemeinsame Logik ist eine Plattformregel, keine Gefälligkeit. Abbildung 3 zeigt diese Aufteilung der Verantwortung.
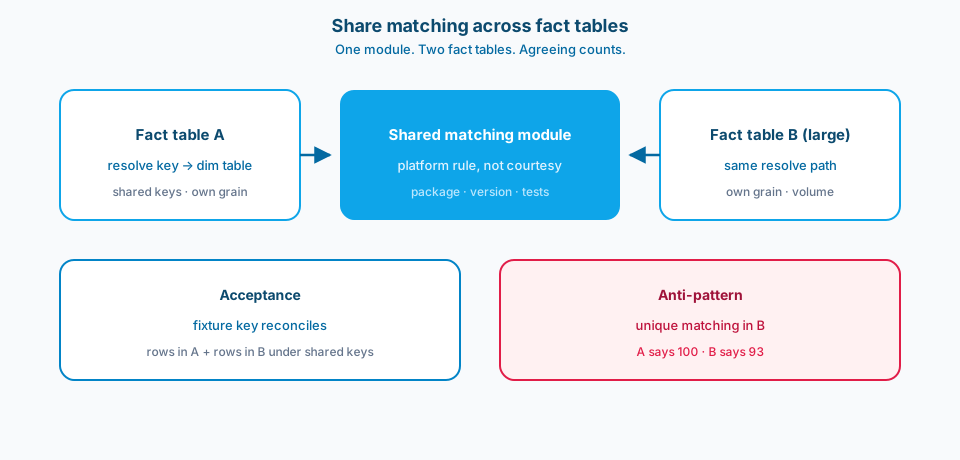
Abbildung 3. Teile das Matching über Faktentabellen hinweg. Ein Modul hält gemeinsame Keys im Einklang. Eigenes Matching in B ist der Grund, warum A 100 sagt und B 93.
3. Bevorzuge Direct Lake bei Volumen
Lange Historie und hohe Ladefrequenzen bestrafen Import-Refresh und Kapazität. Forme Delta für Direct Lake: sinnvolle Typen, stabile Keys, und vermeide es, Views im SQL endpoint davorzuschalten, wenn sie wieder Latenz einführen. Dokumentiere, wann eine hybride Lösung aus Dimension in Import und Fakt in Direct Lake beabsichtigt ist. Abbildung 4 zeigt Standard und Ausnahme.
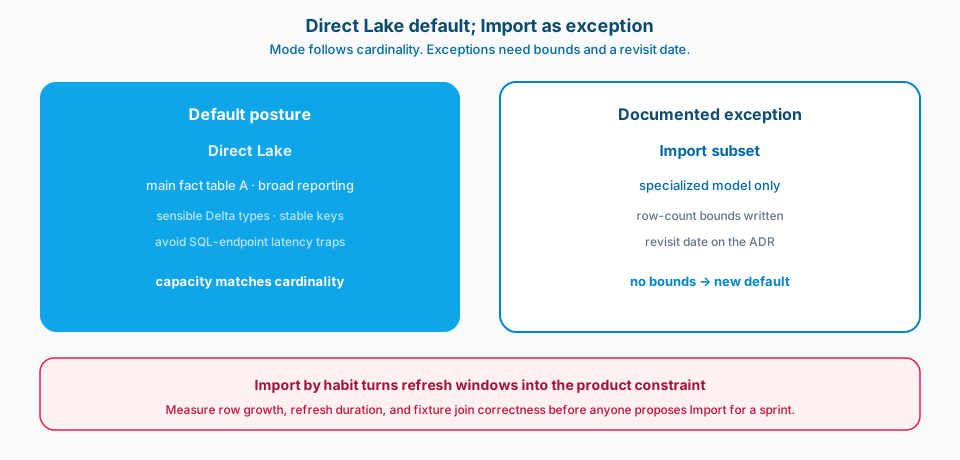
Abbildung 4. Direct Lake ist der Standard für die große Haupt-Faktentabelle. Import ist eine dokumentierte Ausnahme mit Zeilengrenzen und einem Termin zur Überprüfung, keine Gewohnheit.
Auch Direct Lake hat eine Speichergrenze pro Abfrage. Bei einer Milliarde Zeilen stieß eine Top-100-Abfrage auf Zeilenebene bei jedem Lauf daran (siehe Fabric Engines mit 1B Zeilen: nach Abfrageform wählen).
4. Beschriftungen, Ordner und Beschreibungen kommen mit dem Fakt
Rohe Payload-Spalten sind kryptisch. Verständliche Beschriftungen und Abfrageordner machen den Fakt erst nutzbar. Ergänze Beschreibungen für Einheiten und Enums. Das ist dieselbe Disziplin bei der semantischen Übergabe wie bei schmaleren Gold-Tabellen, bei diesem Volumen nur dringender.
5. Watermarks und Bereinigungen in Bronze gehören zur Geschichte
Shortcuts, Watermark-Fortschritte und schlanke bereinigte Views erklären Aktualität und verspätete Daten. Dokumentiere sie neben dem Vertrag für den Gold-Fakt, damit die Rufbereitschaft weiß, ob eine Lücke Ladeverzug oder ein semantischer Filter ist. Lass das Verhalten der Watermark nicht als Stammeswissen in einem Notebook liegen.
6. Teste Joins mit bekannten Keys über Fakten hinweg
Zur Abnahme gehört: Ein Key mit Zeilen in Faktentabelle A und Zeilen in Faktentabelle B stimmt über die gemeinsamen Keys überein. Prüfe nicht zugeordnete Keys in B stichprobenartig genauso wie in A. Volumen ist keine Ausrede, Tests der Granularität auszulassen; zieh die Stichproben bewusst.
Import-Modus als dokumentierte Ausnahme
Manchmal gehört eine kleine Teilmenge wirklich in Import, für ein spezielles Modell. Halte diese Ausnahme mit Zeilengrenzen und einem Termin zur Überprüfung schriftlich fest. Ausnahmen ohne Grenzen werden zum neuen Standard. Direct Lake bleibt die Haltung für die große Haupt-Faktentabelle, die das breite Reporting speist. Diese Klarheit verhindert, dass ein künftiger Engineer bei einem fremden Refactoring alles wieder auf Import "vereinfacht".
Volumen ohne Vertrag ist nur ein schnelleres Chaos
Direct Lake rettet keinen Fakt mit unklarer Granularität oder abweichendem Key-Matching. Es hilft dir nur, die falschen Joins bei höherer Parallelität auszuliefern. Bring zuerst den Namen, die gemeinsame Anreicherung und die semantische Übergabe in Ordnung. Dann wähle Direct Lake, damit Refresh und Abfragekapazität zu der Kardinalität passen, der du bereits vertrauen willst.
Miss früh: Zeilenwachstum pro Tag, Refresh-Dauer im gewählten Modus und die Korrektheit der Joins anhand eines Fixture-Pakets. Zahlen schlagen Meinungen, wenn jemand vorschlägt, "nur für diesen Sprint" auf Import zurückzugehen.
Auch die Kapazitätsplanung für Direct Lake braucht Verantwortliche; eine Moduswahl ohne Monitoring ist nur Optimismus.
Häufige Fehler
Log-Denken. Keine Aussage zur Granularität; jeder Bericht erfindet eine.
Import aus Gewohnheit. Refresh-Fenster werden zur Einschränkung des Produkts.
Eigenes Matching. Faktentabelle A meldet 100 Keys, Faktentabelle B 93.
Technische Namen im Modell. Die Akzeptanz stirbt, DAX-Forks vermehren sich.
Undokumentierte Watermarks. Die Debatten über Aktualität enden nie.
Keine Prüfung nicht zugeordneter Keys. Verwaiste Zeilen fallen still weg.
So übernehmen oder anpassen
So übernehmen
- Eine große Faktentabelle ist ein Fakt in Gold mit schriftlich festgelegter Granularität.
- Key-Matching und Anreicherung werden mit den Schwester-Faktentabellen geteilt.
- Direct Lake (oder eine dokumentierte Ausnahme) für Faktentabellen mit hohem Volumen.
- Beschriftungen, Ordner und Beschreibungen sind beim Veröffentlichen Pflicht.
- Das Verhalten von Watermark und bereinigten Views in Bronze ist neben dem Fakt dokumentiert.
- Join-Tests über Fakten hinweg mit Fixture-Keys, einschließlich nicht zugeordneter Fälle.
Vor dem Einsatz anpassen
Direct Lake braucht Delta-Hygiene und ein Verständnis für Framing. Import fühlt sich vertraut an und scheitert bei Größe. Gemeinsame Anreicherungsmodule verlangen Disziplin bei Paketen über Notebooks hinweg. Beschriftungen für breite Faktentabellen kosten Zeit; wer sie auslässt, kostet jede Person, die die Daten nutzt, Stunden. Die Doku zur Watermark in Bronze aktuell zu halten ist operativer Aufwand, der falsche Eskalationen von Vorfällen verhindert.
Wichtigste Quellen: Direct Lake overview, die Leitfäden zur Medallion-Architektur im Lakehouse und die Modellierungsdoku von Power BI für große Fakten. Verbinde die Wahl des Speichermodus mit dem Vertrag für die Anreicherung, damit Volumen keinen semantischen Drift entschuldigt.
Benenne sie, reichere sie wie ihre Schwestertabellen an, leg sie auf Direct Lake und übergib die Beschriftungen mit der Tabelle. Dann wird Volumen zu einer Kapazitätsfrage, die du planen kannst, statt zu einem wöchentlichen Überraschungsbrand beim Refresh.
Verwandte Notizen
- Spark Ingest: Wie lädst du große Tabellen ohne Driver OOM? (eine große Quelltabelle laden, ohne dass dem Driver der Speicher ausgeht)
- Einmal in Gold pivotieren: Wie ersetzt du breite Import-Pivots für Direct Lake? (ein vorab pivotierter Fakt in Gold statt breiter Import-Pivots)
- Große Fakten: Warum driftet ein grüner Refresh trotzdem? (der inkrementelle Vertrag, den ein großer Fakt braucht)