

Das Wichtigste in Kürze
- Analytics liest einen flachen Gold-Fakt. Verschachtelte Formen aus der Quelle bleiben aus Import-Pivots heraus.
- PySpark führt einen einzigen dokumentierten Pivot mit per Broadcast verteilten Attribut-Maps aus.
- Die Granularität ist eine Zeile pro Entität, Attribut und Periode mit stabilen Keys. Beschriftungen folgen dem Business-Glossar.
- Die Delta-Ausgabe ist bereit für Direct Lake. Für die Breite der Tabelle braucht es kein Import.
- Versioniere die Attribut-Map zusammen mit dem Fakt und dokumentiere das Verhalten historischer Daten.
- Paritätsprüfungen entscheiden über die Umstellung von OUTER APPLY Pfaden im Import-Modus.
Breite Pivots kommen zu spät. SQL OUTER APPLY, Import-Modus, Beschriftungen, die im Bericht erfunden werden. Die Aktualisierungszeit steigt. Direct Lake bekommt nie eine faire Chance. Das semantische Modell zahlt für eine Form, die in Gold hätte entschieden werden sollen.
Einmal in Gold pivotieren. Broadcast-Joins plus ein einziges groupBy/pivot in PySpark ergeben einen eigenständigen Fakt mit stabilen Keys. Die Beschriftungen entsprechen dem Glossar, das die Nutzer schon kennen. Materialisiere für Direct Lake. Hör auf, Import-Steuer für breite Pivots zu zahlen, die nur existieren, weil die Warehouse-View verschachtelt geblieben ist.
Benanntes Modell: einmal in Gold pivotieren
- Verschachtelte Quelle: Attribut-Bags und baumförmige Datensätze. OUTER APPLY Pivots im Import und im Bericht erfundene Beschriftungen sind die späte Steuer.
- Spark-Pivot in Gold: kleine Attribut-Maps per Broadcast verteilen, dann ein einziges groupBy/pivot. Ein Job, eine Ausgabegranularität, Beschriftungen aus dem Glossar.
- Flacher Direct Lake Fakt: typisiertes Delta, das das semantische Modell ohne Import-Krücken nutzen kann. Versionierte Attribut-Map. Parität entscheidet über die Umstellung.
- Vertrag: Pivots in Berichtsform gehören in die Materialisierung in Gold, nicht auf den Aktualisierungspfad des Imports.
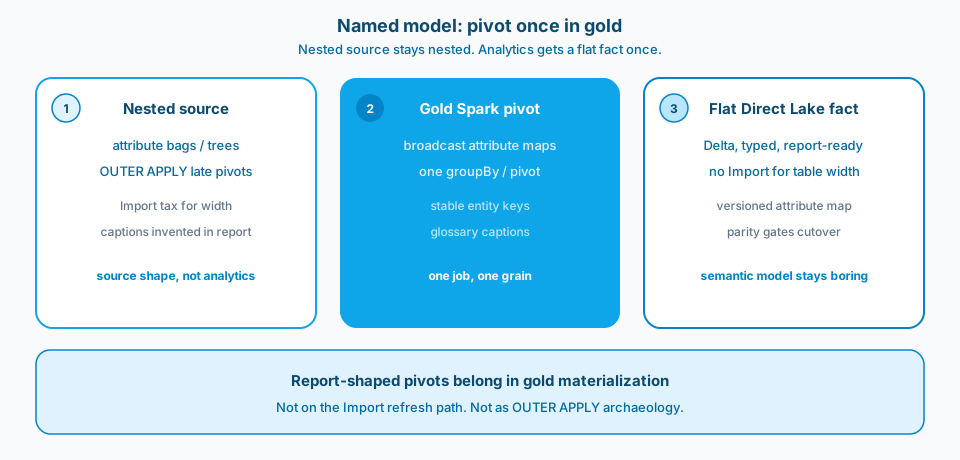
Abbildung 1. Einmal in Gold pivotieren. Die verschachtelte Quelle bleibt operativ. Analytics bekommt einen flachen, beschrifteten Fakt, den das semantische Modell ohne SQL-Archäologie erklären kann.
Kontext und Rahmenbedingung
Ein typischer Fehler: Datensätze aus der Quelle kommen als verschachtelte Attribut-Bags an. Berichtsautoren pivotieren in SQL für Import. Jedes neue Attribut bedeutet einen weiteren OUTER APPLY Zweig und eine längere Aktualisierung. Wenn du den Pivot in einen Spark-Job in Gold verlegst, wird das semantische Modell im besten Sinne langweilig.
Verschachtelte Bags sind eine operative Bequemlichkeit für Quellsysteme. Analytics braucht flache Fakten mit stabilen Keys und fachlichen Beschriftungen. Einmal in Spark umzuformen schlägt das Umformen in SQL bei jedem Import. Direct Lake liest dann eine Tabelle, die schon wie der Bericht aussieht.
Abbildung 2 zeigt die Oberfläche aus Learn für Beziehungen im Modell. Form und Keys zählen, bevor über den Speichermodus gestritten wird. Eine verschachtelte Struktur, die durch Import gepresst wird, ist trotzdem die falsche analytische Form.
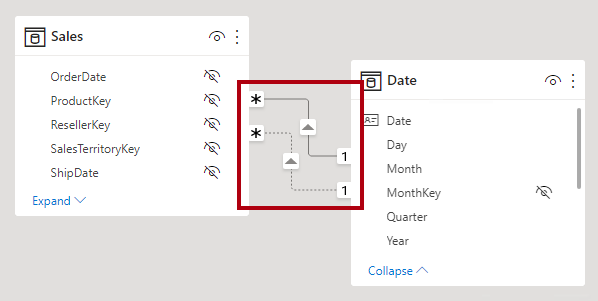
Abbildung 2. Form der Beziehungen und Keys sind Modellierungsentscheidungen. Direct Lake will berichtsfertige flache Fakten, keine verschachtelten Bäume, die nur der Import-Modus vortäuschen kann. Quelle: Microsoft Learn: Beziehungen verstehen.
Design
1. OUTER APPLY Pivots auf Import-Pfaden verbieten
Wenn ein Modell nur wegen eines breiten Pivots in SQL im Import bleibt, verlege den Pivot in die Quelle. Import sollte eine Entscheidung über den Speichermodus sein, keine Steuer für spätes Umformen. Behandle SQL, das Verschachteltes in Breites verwandelt, im Code-Review als Warnsignal.
2. Kleine Dimensionen per Broadcast verteilen, einmal pivotieren
Halte Attributdefinitionen und Beschriftungs-Maps so klein, dass sie per Broadcast verteilt werden können. Führe ein einziges groupBy/pivot über die Quellzeilen aus. Ein Job, eine Ausgabegranularität. Verkettete Pivots und spontane Self-Joins bauen das verschachtelte Chaos im Spark-Gewand nach.
3. Eine Zeile pro Entität, Attribut und Periode, mit stabilen Keys
Wähle eine Granularität, die du erklären kannst: Entitäts-Key, Attribut-Key, Periode, Wert und Status. Stabile Keys schlagen anonyme breite Spalten, die abdriften, wenn sich die Quelle ändert. Surrogate Keys sind in Ordnung, stille Umbenennungen von Spalten nicht. Abbildung 3 zeigt diese Granularität mit Disziplin bei den Beschriftungen.
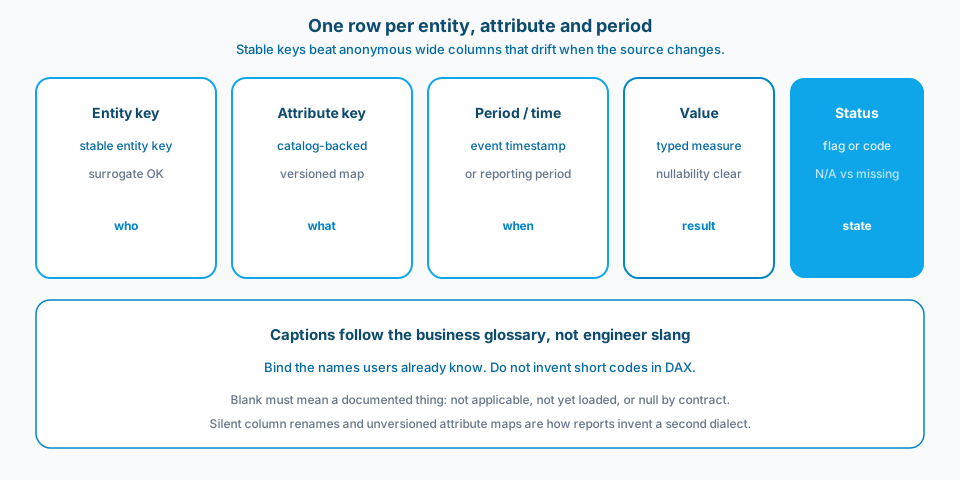
Abbildung 3. Eine Zeile pro Entität, Attribut und Periode mit stabilen Keys. Beschriftungen folgen dem Glossar. Ein leerer Wert muss etwas Dokumentiertes bedeuten, keinen privaten Dialekt.
4. Beschriftungen folgen dem Business-Glossar, nicht dem Jargon der Engineers
Nutzer haben schon Namen für Attribute. Setze diese Beschriftungen auf den Fakt oder auf eine verbundene Dimension, an die das semantische Modell binden kann. Erfinde in DAX keine Kurzcodes, die niemand benutzt. Sprachliche Kontinuität ist Teil des Vertrauens.
5. Bewusst für Direct Lake materialisieren
Schreibe Delta mit Typen und Nullability, die Direct Lake und das semantische Modell ohne Import-Krücken nutzen können. Prüfe im Notebook die Anzahl der Spalten und die Eindeutigkeit der Keys. Ein Pivot, der erst nach einem Import in Desktop funktioniert, ist nicht fertig.
6. Die Attribut-Map zusammen mit dem Fakt versionieren
Wenn Attribute hinzukommen oder wegfallen, versioniere die Beschriftungs-Map und dokumentiere, wie sich historische Zeilen verhalten. Ein Pivot, der ohne Vertrag still breiter wird, ist der Grund, warum der Bericht von gestern das Dashboard von morgen kaputt macht. Behandle den Attributkatalog als Produktdaten.
Was der Gold-Vertrag sagen sollte
Veröffentliche die Granularität, die Key-Spalten, die Wertspalten und die Quelle der Beschriftungen. Lege fest, ob fehlende Attribute als Null-Spalten, fehlende Zeilen oder Status-Flag erscheinen. Lege fest, wie späte Korrekturen ankommen. Autoren semantischer Modelle sollten nicht das Notebook zurückentwickeln müssen, um zu erfahren, ob ein leerer Wert "nicht zutreffend" oder "noch nicht geladen" bedeutet. Mehrdeutigkeit in einem flachen Fakt wird zu falschen Zahlen in Meetings.
Direct Lake ist ohne die richtige Form kein Selbstläufer
Direct Lake belohnt Tabellen, die schon analytisch sind. Verschachtelte Structs, Arrays, die im Modell aufgefächert werden, und Pivots zur Laufzeit der Measures drängen dich zurück zu Import oder zu schmerzhaftem DAX. Wenn deine Geschichte einen Pivot braucht, um lesbar zu sein, mach diesen Pivot vor dem semantischen Modell. Die Kapazitätsmetriken sehen dann besser aus, aber der tiefere Gewinn ist ein Modell, das Reviewer ohne SQL-Archäologie erklären können.
Migrieren ohne große Stichtagsumstellung
Halte den alten Import-Pfad lesbar, während der Gold-Fakt seine Parität beweist. Vergleiche die Zeilenzahlen auf der Granularität des Fakts, prüfe stichprobenartig eine feste Menge von Attributen gegen die alte Ausgabe und richte erst dann das semantische Modell auf den flachen Fakt aus. Kündige die OUTER APPLY View mit einem Datum ab. Parallelbetrieb ohne Abschaltdatum lässt beide Pfade verrotten. Abbildung 4 zeigt die Reihenfolge der Umstellung.
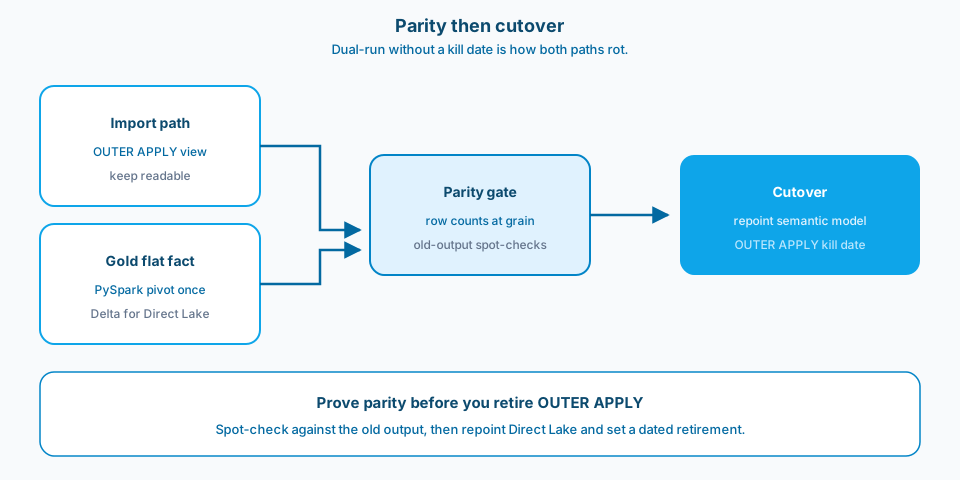
Abbildung 4. Beweise die Parität, bevor du OUTER APPLY abschaltest. Prüfe stichprobenartig gegen die alte Ausgabe, richte dann Direct Lake neu aus und lege ein Datum für die Abschaltung fest.
Häufige Fehler
Für immer verschachtelt. Die Form der Quelle wird aus Trägheit zur Form der Analytics.
Import als Entschuldigung. Breite SQL-Pivots erzwingen Import, und niemand fragt, warum.
Abdriftende Beschriftungen. Engineers benennen Spalten um, Fachanwender erkennen ihre Measures nicht mehr.
Mehrstufige Spark-Pivots. Breite Zwischentabellen, die niemandem gehören.
Kein ADR zur Granularität. Mitten im Incident sind sich zwei Autoren uneinig, wofür "eine Zeile pro" eigentlich steht.
Glossar ignoriert. Berichtsbeschriftungen erfinden einen zweiten Dialekt.
So übernehmen oder anpassen
So übernehmen
- Analytics liest einen flachen Gold-Fakt. Verschachtelte Formen aus der Quelle bleiben aus Import-Pivots heraus.
- PySpark führt einen einzigen dokumentierten Pivot mit per Broadcast verteilten Attribut-Maps aus.
- Die Granularität ist eine Zeile pro Entität, Attribut und Periode mit stabilen Keys. Beschriftungen folgen dem Business-Glossar.
- Die Delta-Ausgabe ist bereit für Direct Lake. Für die Breite der Tabelle braucht es kein Import.
- Änderungen an der Attribut-Map werden mit ausdrücklich festgelegtem Verhalten für historische Daten versioniert.
- Paritätsprüfungen entscheiden über die Umstellung von OUTER APPLY Pfaden im Import-Modus.
Vor dem Einsatz anpassen
Vorab in Gold zu pivotieren bringt einen Spark-Job und eine Abhängigkeit von der Attribut-Map mit. Späte SQL-Pivots fühlen sich flexibel an, bis Aktualisierung und Direct Lake auf dem Tisch liegen. Breite Fakten können viele Spalten haben. Das ist immer noch billiger als Import-Theater, wenn die Granularität ehrlich ist. Disziplin bei den Beschriftungen verlangsamt die erste Lieferung und beschleunigt jedes Review danach. Die Attribut-Map zu versionieren ist Zeremonie. Unversionierte Maps sind Incidents.
Wichtigste Quellen: Übersicht über Direct Lake und die Hinweise zu Fabric Spark und Delta auf Microsoft Learn. Ergänze sie um ein Dokument zur Verantwortung für den Attributkatalog, damit die Beschriftungen einen menschlichen Verantwortlichen haben. Kontext zur Modellierung von Beziehungen: Beziehungen verstehen.
Flach machen in Gold. Beschriften in der Sprache des Geschäfts. Materialisieren für Direct Lake. Lass OUTER APPLY Pivots im Archivordner, wo sie hingehören.