

Puntos clave
- La analítica lee un hecho gold plano; las formas anidadas del origen se quedan fuera de los pivotes de Import.
- PySpark hace un único pivote documentado con mapas de atributos distribuidos por broadcast.
- El grano es una fila por entidad, atributo y periodo con claves estables; las etiquetas siguen el glosario de negocio.
- La salida Delta está lista para Direct Lake; no hace falta Import por el ancho de la tabla.
- Versiona el mapa de atributos junto con el hecho y documenta el comportamiento histórico.
- Las comprobaciones de paridad deciden el paso desde las rutas de Import con OUTER APPLY.
Los pivotes anchos llegan tarde. OUTER APPLY en SQL, modo Import, etiquetas inventadas en el informe. El tiempo de actualización sube. Direct Lake nunca tiene una oportunidad justa. El modelo semántico paga por una forma que debería haberse decidido en gold.
Pivota una vez en gold. Joins por broadcast más un único groupBy/pivot en PySpark producen un hecho autónomo con claves estables. Las etiquetas coinciden con el glosario que los usuarios ya conocen. Materializa para Direct Lake. Deja de pagar el impuesto de Import por pivotes anchos que solo existen porque la vista del warehouse siguió anidada.
Modelo con nombre: pivotar una vez en gold
- Origen anidado: bolsas de atributos y registros con forma de árbol. Los pivotes OUTER APPLY en Import y las etiquetas inventadas en el informe son el impuesto tardío.
- Pivote de Spark en gold: distribuye por broadcast los mapas de atributos pequeños y después un único groupBy/pivot. Un job, un grano de salida, etiquetas del glosario.
- Hecho plano para Direct Lake: Delta tipado que el modelo semántico puede consumir sin muletas de Import. Mapa de atributos versionado. La paridad decide el paso.
- Contrato: los pivotes con forma de informe pertenecen a la materialización en gold, no a la ruta de actualización de Import.
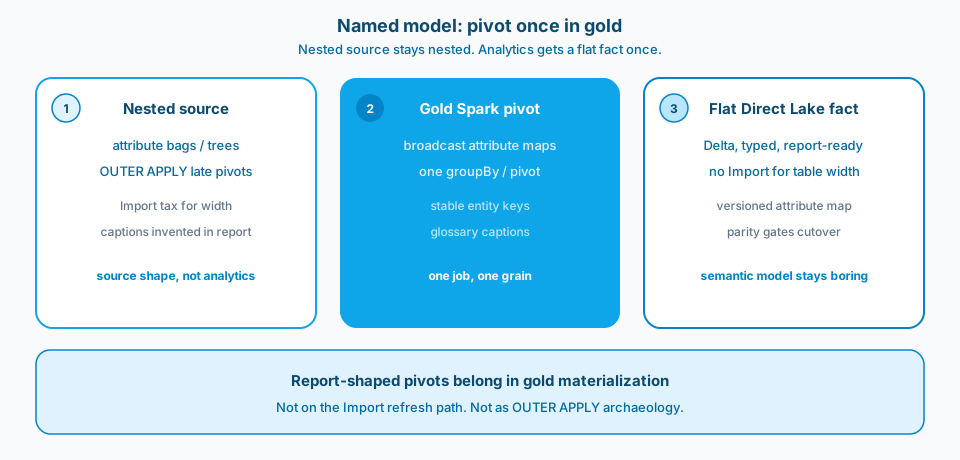
Figura 1. Pivotar una vez en gold. El origen anidado sigue siendo operativo. La analítica recibe un hecho plano y etiquetado que el modelo semántico puede explicar sin arqueología de SQL.
Contexto y restricción
Un fallo habitual: los registros del origen llegan como bolsas de atributos anidadas. Los autores de informes pivotan en SQL para Import. Cada atributo nuevo supone otra rama OUTER APPLY y una actualización más larga. Llevar el pivote a un job de Spark en gold vuelve aburrido el modelo semántico, en el mejor sentido.
Las bolsas anidadas son una comodidad operativa para los sistemas de origen. La analítica necesita hechos planos con claves estables y etiquetas de negocio. Remodelar una vez en Spark es mejor que remodelar en SQL en cada Import. Así Direct Lake lee una tabla que ya se parece al informe.
La figura 2 es la superficie de Learn para las relaciones del modelo. La forma y las claves importan antes de discutir el modo de almacenamiento. Una estructura anidada forzada a través de Import sigue siendo la forma analítica equivocada.
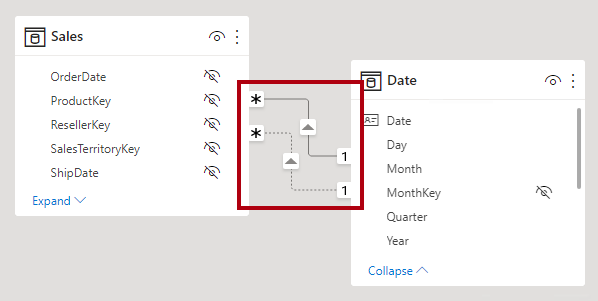
Figura 2. La forma de las relaciones y las claves son decisiones de modelado. Direct Lake quiere hechos planos listos para el informe, no árboles anidados que solo el modo Import puede disimular. Fuente: Microsoft Learn: comprender las relaciones.
Diseño
1. Prohíbe los pivotes OUTER APPLY en las rutas de Import
Si la única razón por la que un modelo sigue en Import es un pivote ancho en SQL, lleva el pivote al origen. Import debería ser una elección de modo de almacenamiento, no un impuesto por remodelar tarde. Trata el SQL que convierte lo anidado en ancho como una señal de alarma en la revisión de código.
2. Distribuye por broadcast las dimensiones pequeñas y pivota una vez
Mantén las definiciones de atributos y los mapas de etiquetas lo bastante pequeños para distribuirlos por broadcast. Haz un único groupBy/pivot sobre las filas del origen. Un job, un grano de salida. Los pivotes encadenados y los self-joins improvisados recrean el lío anidado con ropa de Spark.
3. Una fila por entidad, atributo y periodo, con claves estables
Elige un grano que puedas explicar: clave de entidad, clave de atributo, periodo, valor y estado. Las claves estables son mejores que columnas anchas anónimas que se desvían cuando cambia el origen. Las claves subrogadas están bien; los renombrados silenciosos de columnas, no. La figura 3 muestra ese grano con disciplina en las etiquetas.
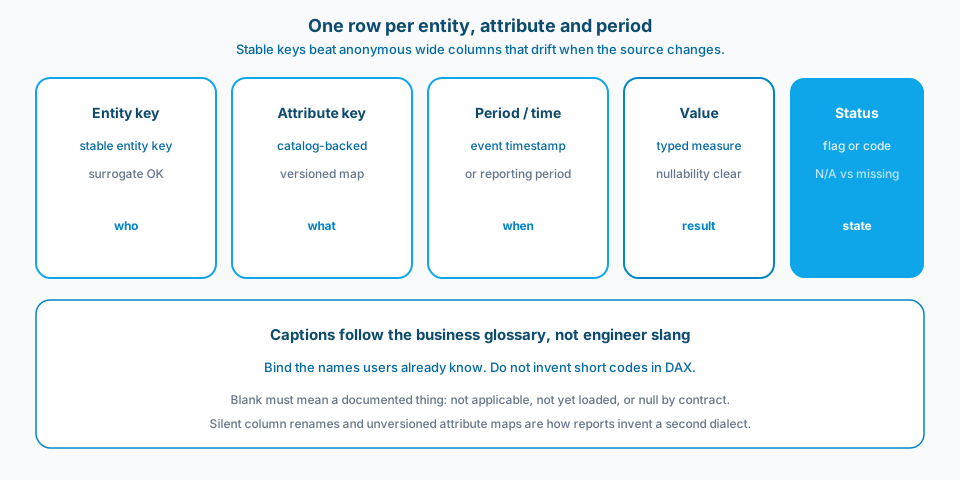
Figura 3. Una fila por entidad, atributo y periodo con claves estables. Las etiquetas siguen el glosario. Un valor en blanco tiene que significar algo documentado, no un dialecto privado.
4. Las etiquetas siguen el glosario de negocio, no la jerga de ingeniería
Los usuarios ya tienen nombres para los atributos. Pon esas etiquetas en el hecho o en una dimensión relacionada que el modelo semántico pueda enlazar. No inventes en DAX códigos cortos que nadie usa. La continuidad del lenguaje es parte de la confianza.
5. Materializa para Direct Lake de forma deliberada
Escribe Delta con tipos y nulabilidad que Direct Lake y el modelo semántico puedan consumir sin muletas de Import. Valida en el notebook el número de columnas y la unicidad de las claves. Un pivote que solo funciona tras un Import en Desktop no está terminado.
6. Versiona el mapa de atributos junto con el hecho
Cuando se añadan o retiren atributos, versiona el mapa de etiquetas y documenta cómo se comportan las filas históricas. Ensanchar el pivote en silencio y sin contrato es la forma en que el informe de ayer rompe el panel de mañana. Trata el catálogo de atributos como datos de producto.
Qué debería decir el contrato de gold
Publica el grano, las columnas clave, las columnas de valor y el origen de las etiquetas. Indica si los atributos que faltan son columnas nulas, filas ausentes o un indicador de estado. Indica cómo llegan las correcciones tardías. Los autores del modelo semántico no deberían tener que hacer ingeniería inversa del notebook para saber si un blanco significa "no aplica" o "todavía no cargado". La ambigüedad en un hecho plano se convierte en números equivocados en las reuniones.
Direct Lake no sale gratis sin la forma adecuada
Direct Lake premia las tablas que ya son analíticas. Los structs anidados, los arrays que se despliegan en el modelo y los pivotes en tiempo de medida te empujan de vuelta a Import o a un DAX doloroso. Si tu historia necesita un pivote para que una persona la pueda leer, haz ese pivote antes del modelo semántico. Las métricas de capacidad mejorarán, pero la ganancia de fondo es un modelo que los revisores pueden explicar sin una sesión de arqueología de SQL.
Cómo migrar sin un cambio de golpe
Mantén legible la ruta antigua de Import mientras el hecho gold demuestra la paridad. Compara el número de filas al grano del hecho, revisa por muestreo un conjunto fijo de atributos frente a la salida antigua y solo entonces apunta el modelo semántico al hecho plano. Retira la vista OUTER APPLY con una fecha. Ejecutar ambas en paralelo sin fecha de cierre es la forma en que las dos rutas se pudren. La figura 4 muestra ese orden de cambio.
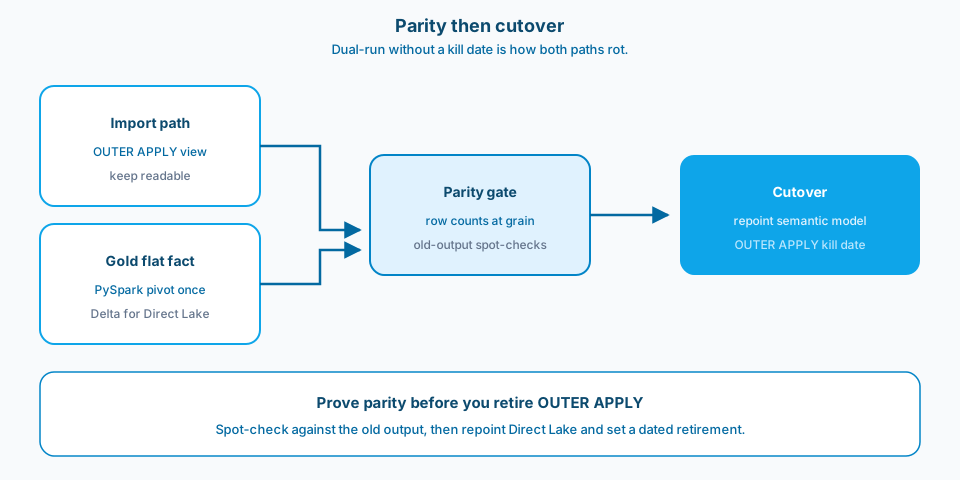
Figura 4. Demuestra la paridad antes de retirar OUTER APPLY. Revisa por muestreo frente a la salida antigua, después vuelve a apuntar Direct Lake y fija una fecha de retirada.
Errores comunes
Anidado para siempre. La forma del origen se convierte por inercia en la forma de la analítica.
Import como disculpa. Los pivotes anchos en SQL obligan a usar Import y nadie pregunta por qué.
Deriva de etiquetas. Ingeniería renombra columnas y los usuarios de negocio dejan de reconocer las medidas.
Pivotes de Spark en varios pasos. Tablas anchas intermedias de las que nadie es responsable.
Ningún ADR sobre el grano. En pleno incidente, dos autores no se ponen de acuerdo en "una fila por qué".
Glosario ignorado. Las etiquetas del informe inventan un segundo dialecto.
Úsalo tal cual o adáptalo
Úsalo tal cual
- La analítica lee un hecho gold plano; las formas anidadas del origen se quedan fuera de los pivotes de Import.
- PySpark hace un único pivote documentado con mapas de atributos distribuidos por broadcast.
- El grano es una fila por entidad, atributo y periodo con claves estables; las etiquetas siguen el glosario de negocio.
- La salida Delta está lista para Direct Lake; no hace falta Import por el ancho de la tabla.
- Los cambios en el mapa de atributos se versionan con un comportamiento histórico explícito.
- Las comprobaciones de paridad deciden el paso desde las rutas de Import con OUTER APPLY.
Adáptalo antes de usarlo
Pivotar de antemano en gold añade un job de Spark y una dependencia del mapa de atributos. Los pivotes tardíos en SQL parecen flexibles hasta que la actualización y Direct Lake entran en la conversación. Los hechos anchos pueden tener muchas columnas; aun así salen más baratos que el teatro de Import cuando el grano es honesto. La disciplina en las etiquetas ralentiza la primera entrega y acelera todas las revisiones posteriores. Versionar el mapa de atributos es ceremonia; los mapas sin versionar son incidentes.
Referencias principales: introducción a Direct Lake y la guía de Spark y Delta de Fabric en Microsoft Learn. Acompáñalas de un documento de responsabilidad del catálogo de atributos para que las etiquetas tengan una persona responsable. Contexto sobre el modelado de relaciones: comprender las relaciones.
Aplana en gold. Etiqueta en el lenguaje del negocio. Materializa para Direct Lake. Deja los pivotes OUTER APPLY en la carpeta de historia, que es donde deben estar.