


Das Wichtigste in Kürze
- Verbiete InsertAll über die ganze Entität auf dem Driver oberhalb dokumentierter Schwellen für Zeilen oder Bytes.
- Mach Batchgröße und Parallelität pro Entität ausdrücklich, einstellbar und dokumentiert.
- Logge pro Batch ID, Zeilen, Dauer und Erfolg oder Fehler als strukturierte Logs.
- Unterstütze Filter nach Entität und Key-Bereich, damit Wiederholungen endlich bleiben.
- Halte Neuaufbau und inkrementelles Laden als getrennte Modi mit getrennten Einstiegspunkten.
- Bring das Muster nur mit Beobachtbarkeit pro Batch und einem Runbook in Produktion.
InsertAll über die ganze Tabelle auf einem einzigen Driver ist bei großen Tabellen ein bekanntes Fehlerbild. Das Notebook sieht einfach aus. Der Driver stirbt. Jemand fordert einen größeren Cluster. Die nächste Neuladung stirbt später, mit einer höheren Rechnung.
Behandle Massen-Neuladungen als Orchestrierung: paralleler Ingest in Batches von Seiten, Fortschrittsüberwachung und Filter nach Entität für beherrschbare Wiederholungen. Trenne einmalige Neuaufbau-Pfade von inkrementellen Watermarks. Bring das Muster erst in Produktion, wenn es Beobachtbarkeit pro Batch gibt. OOM ist hier ein Designgeruch in der Nutzung der Notebook-API, kein Beweis, dass "Fabric unzuverlässig ist".
Benanntes Modell: Batch → Fortschritt → Filter → Beobachten
- Batch: Schreiben pro Seite oder Key-Bereich mit ausdrücklicher Größe und Parallelität; kein Collect der ganzen Entität auf dem Driver oberhalb der Schwelle.
- Fortschritt: strukturierte Logs pro Batch (ID, Zeilen, Dauer, Erfolg oder Fehler), damit "hängt es?" zu einer Zahl wird.
- Filter: Wiederherstellung nach Entität, Partition oder Key-Bereich, ohne die ganze Ladung erneut abzuspielen.
- Beobachten: Metriken pro Batch und ein Runbook sind das Gate vor der Produktion.
- Vertrag: Durchsatz bei großen Tabellen kommt aus kontrollierten Batches und Sichtbarkeit, nicht aus der Hoffnung, dass der Driver alles auf einmal materialisieren kann.
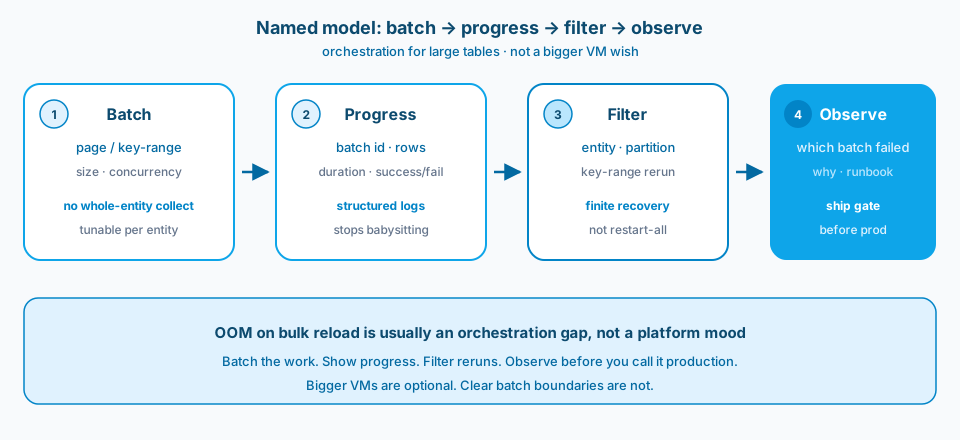
Abbildung 1. Batch, Fortschritt, Filter, Beobachten. Größere VMs sind optional. Klare Grenzen zwischen Batches nicht.
Kontext und Rahmenbedingung
Ein häufiges Muster: Komplette Neuladungen funktionieren bei kleinen Tabellen und brechen bei den großen zusammen. Die API und Spark waren in Ordnung. Der Driver sollte ein ganzes Universum halten. Sobald wir mit Fortschritt und Filtern in Batches geladen haben, wurden Neuladungen zu langweiligen Vorgängen statt zu Heldentaten am Wochenende.
Parallelität ohne Grenzen zwischen Batches führt trotzdem zu OOM; sie scheitert nur schneller. Fortschrittsüberwachung macht aus "hängt es?" eine Zahl. Filter nach Entität erlauben dir, den fehlgeschlagenen Ausschnitt erneut laufen zu lassen, ohne die ganze Ladung zu wiederholen. Inkrementelle Watermarks sind keine Strategie für den Neuaufbau; halte die Pfade getrennt. Beobachtbarkeit ist ein Gate für das Muster, kein nettes Dashboard für später.
Abbildung 2 zeigt die Einordnung aus Learn für Kopierarbeit innerhalb einer Pipeline. InsertAll über die ganze Tabelle auf einem Driver ist ein Geruch in der Orchestrierung. Ingest in Batches gehört in eine beherrschbare Pipeline.
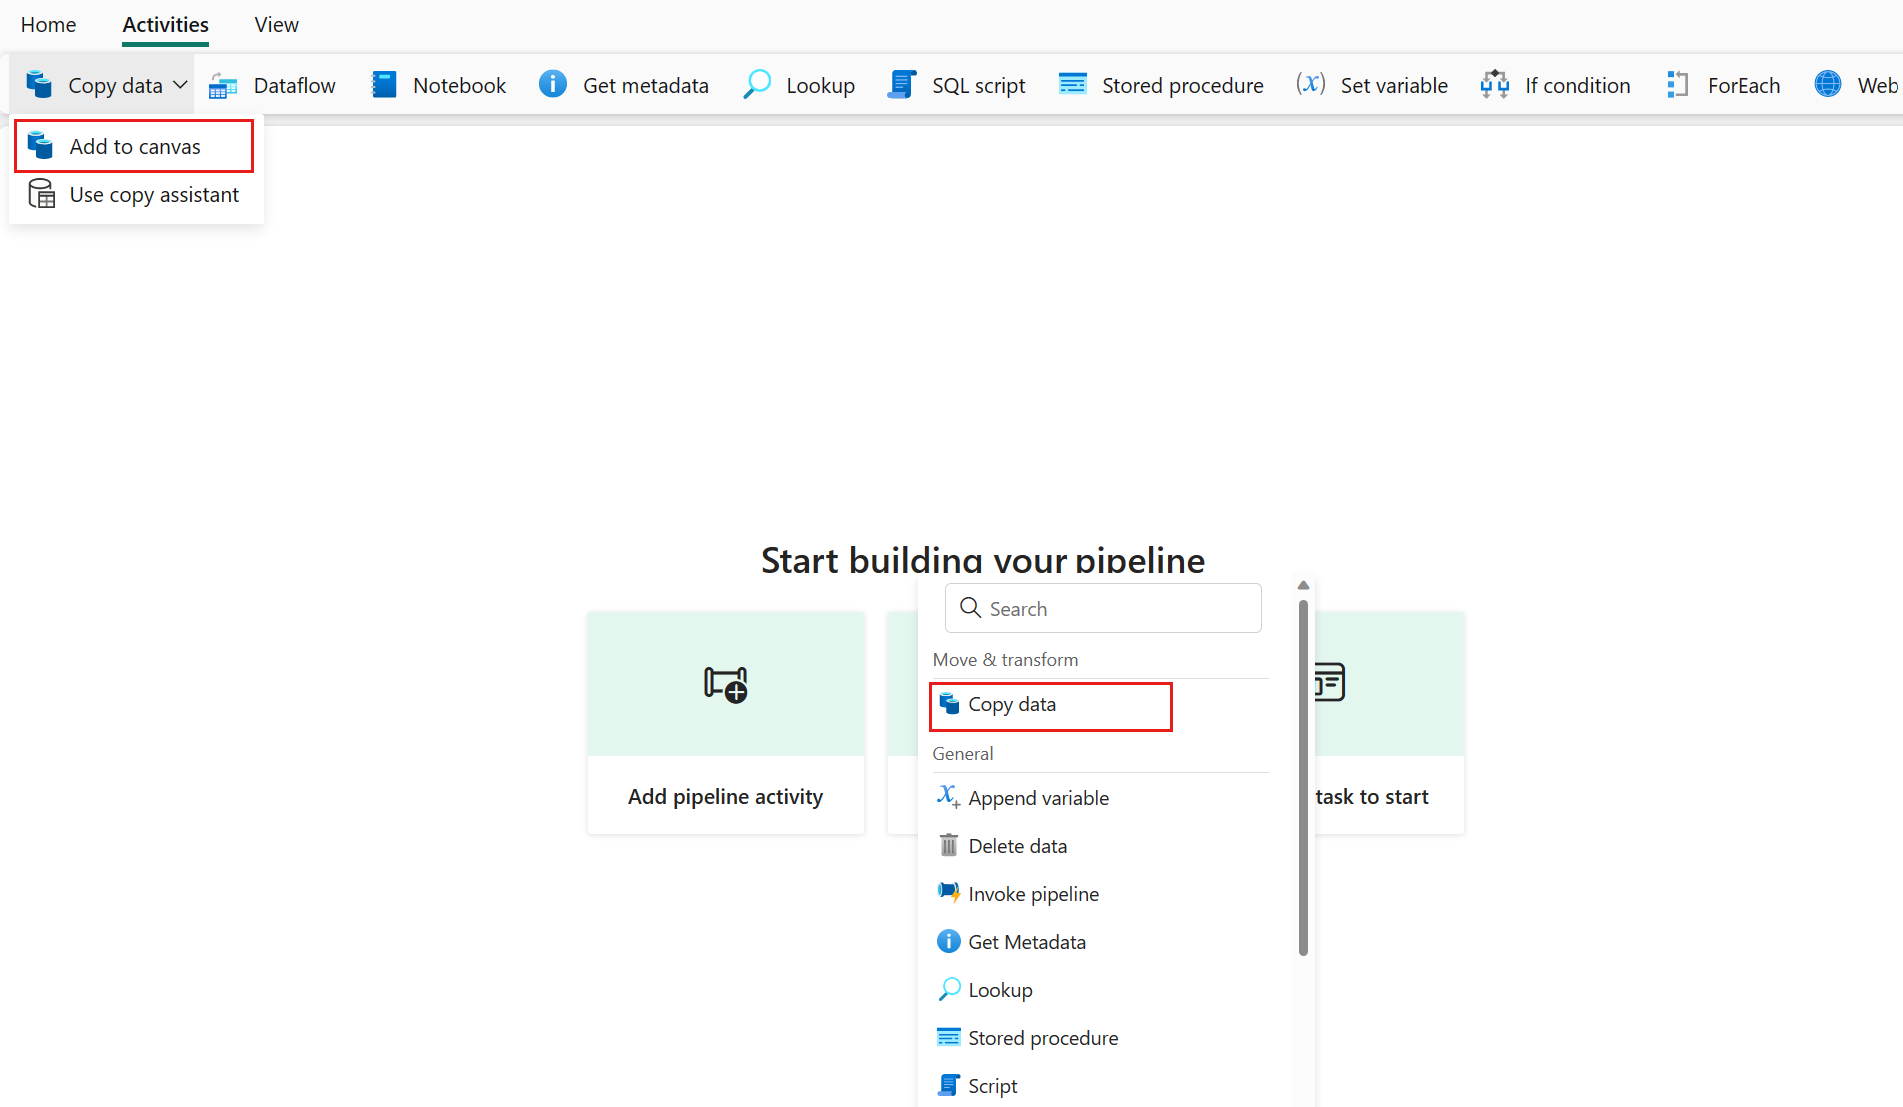
Abbildung 2. InsertAll über die ganze Tabelle auf einem Driver ist ein Geruch in der Orchestrierung. Ingest in Batches gehört in eine beherrschbare Pipeline. Quelle: Microsoft Learn: copy data activity.
Abbildung 3 zeigt die Einordnung aus Learn für einen geplanten Lauf. Lade in Batches mit Fortschritt und Filtern nach Entität und befördere das Muster dann wie jede andere geplante Pipeline.
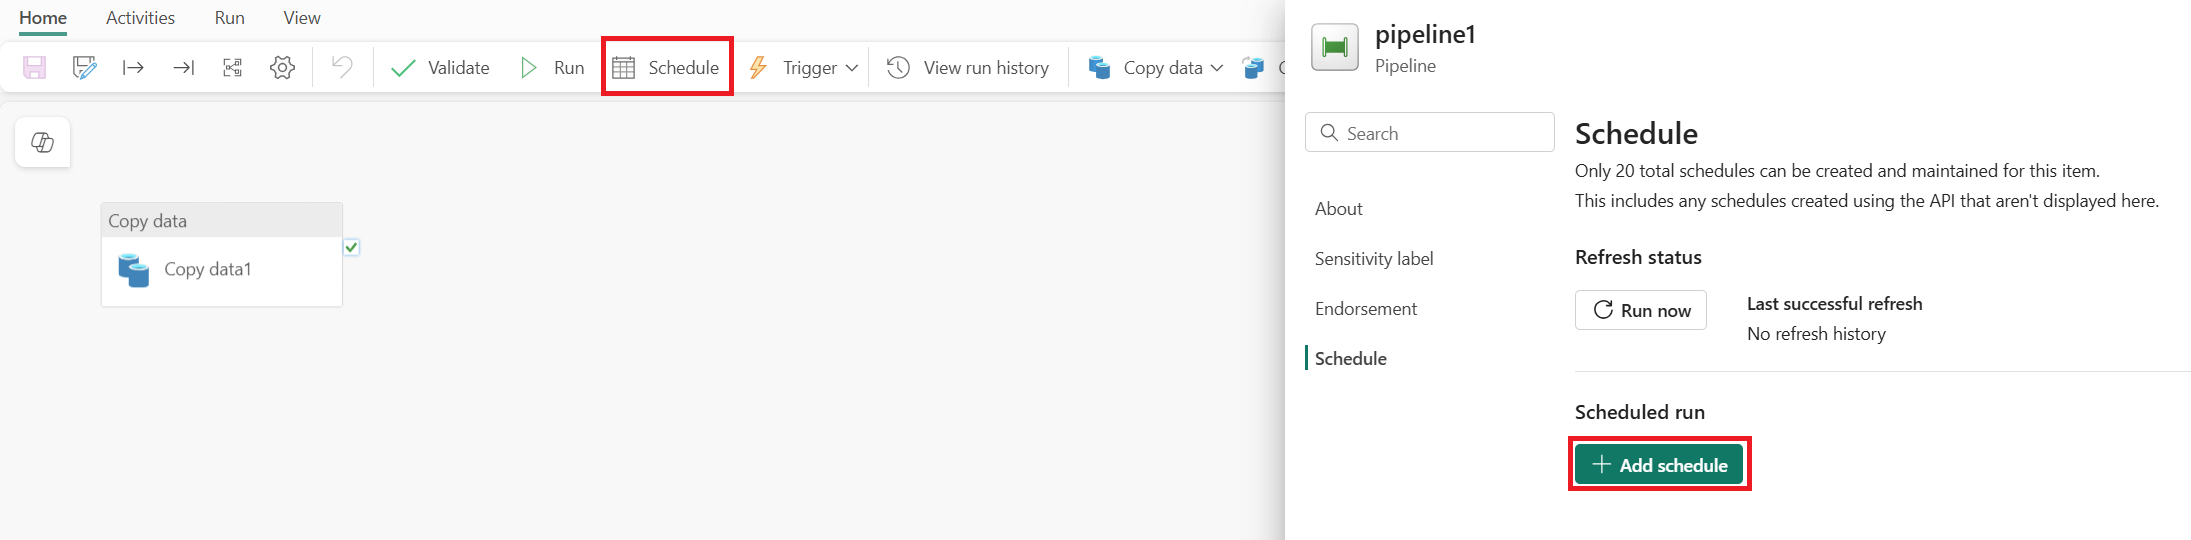
Abbildung 3. Lade in Batches mit Fortschritt und Filtern nach Entität und befördere das Muster dann wie jede andere geplante Pipeline. Quelle: Microsoft Learn: pipeline overview.
Design
1. Collects der ganzen Entität auf dem Driver bei großen Tabellen verbieten
Wenn das Muster verlangt, dass der Driver die ganze Entität vor dem Schreiben zusammensetzt, scheitert es bei Größe. Entwirf für Batches nach Seiten oder Key-Bereichen, die inkrementell schreiben. Einfachheit, die nur bei kleinen Tabellen funktioniert, ist eine Falle. Abbildung 4 zeigt die Aufteilung der Verantwortung, die den Speicher schlank hält.
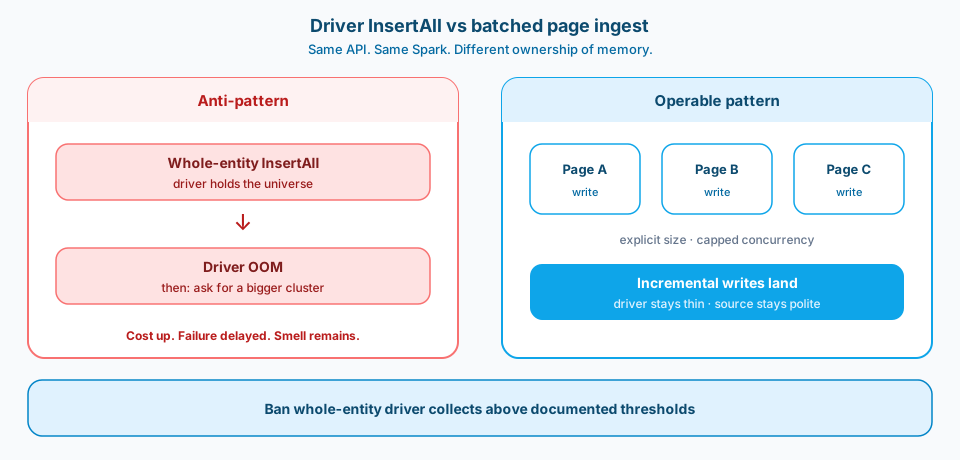
Abbildung 4. Gleiche API. Gleiches Spark. Andere Verantwortung für den Speicher. Verbiete Collects der ganzen Entität auf dem Driver oberhalb dokumentierter Schwellen.
2. In Batches mit ausdrücklichen Reglern für Größe und Parallelität laden
Wähle Batchgrößen, die du pro Entität einstellen kannst. Begrenze die Parallelität, damit du weder die Quelle noch deine eigene Kapazität lahmlegst. Dokumentiere die Standardwerte und die Regler, die der Betrieb drehen darf. Magische Zahlen, die in einer Zelle vergraben sind, werden unter Druck zu Folklore.
3. Fortschritt pro Batch ausgeben
Logge Batch-ID, Zeilenzahlen, Dauer und Erfolg oder Fehler. Der Betrieb braucht eine Spur, wenn eine lange Neuladung mittendrin stehen bleibt. Fortschritt fließt auch in SLAs und die Kapazitätsplanung ein. Stille Schleifen sind kein Enterprise-Ingest.
4. Filter nach Entität für beherrschbare Wiederholungen
Unterstütze das erneute Laden einer Partition, einer Entität oder eines Key-Bereichs, ohne alles zu leeren. Ein kompletter Neustart als einziger Weg zur Wiederherstellung garantiert Ermüdung und Abkürzungen. Filter machen aus Störungen endliche Arbeit.
5. Neuaufbau von inkrementellem Laden trennen
Inkrementelle Pfade auf Basis von Watermarks sind für den Normalbetrieb optimiert. Neuaufbau-Pfade sind für Korrektheit nach Änderungen an Schema oder Logik optimiert. Beides zu mischen erzeugt halb angewendete Zustände, die schwer zu erklären sind. Benenne die Modi im Notebook und in der Pipeline. Abbildung 5 zeigt die Trennung plus das Gate vor dem Ausliefern.
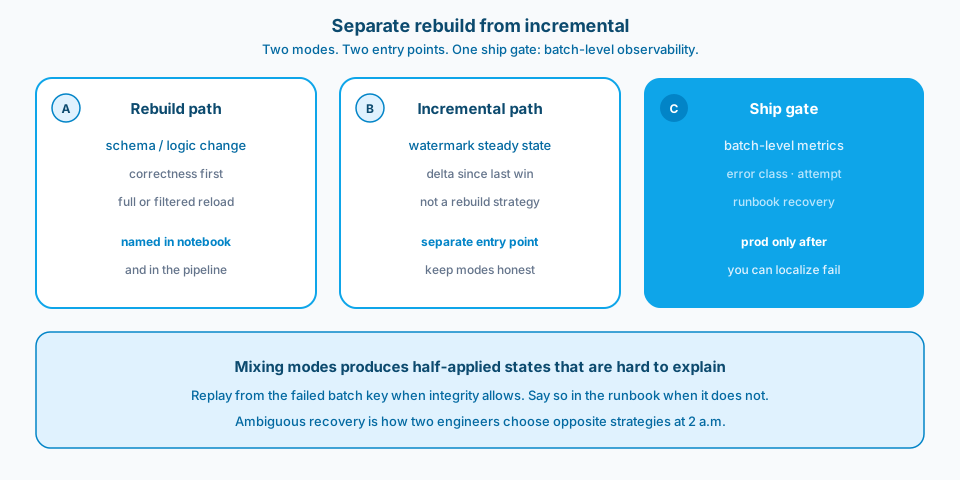
Abbildung 5. Zwei Modi. Zwei Einstiegspunkte. Ein Gate vor dem Ausliefern: Beobachtbarkeit pro Batch. Gemischte Modi erzeugen halb angewendete Zustände, die schwer zu erklären sind.
6. Beobachtbarkeit pro Batch vor der Produktion verlangen
Geh in Produktion, wenn du beantworten kannst, welcher Batch warum fehlgeschlagen ist, nicht wenn eine Demo im Idealfall einmal durchgelaufen ist. Metriken und strukturierte Logs gehören zum Ingest-Vertrag. Ohne sie wird jeder OOM zu einer Beschwerde über die Plattform.
Wie gutes Logging pro Batch aussieht
Jeder Batch sollte eine Zeile oder einen Logeintrag hinterlassen, aus dem du eine kleine Tabelle bauen könntest: Entität, Filter, Batch-Key, Versuch, gelesene Zeilen, geschriebene Zeilen, Dauer, Fehlerklasse. Aggregiere das zu einer Zusammenfassung des Laufs. Bei einem Fehler spielt der Betrieb ab dem fehlgeschlagenen Batch-Key erneut ab, nicht ab null, es sei denn, die Integrität verlangt einen sauberen Neuaufbau. Wenn die Integrität einen sauberen Neuaufbau verlangt, schreib das ins Runbook. Unklare Wiederherstellung ist der Grund, warum sich zwei Engineers um 2 Uhr nachts für gegensätzliche Strategien entscheiden.
In einer Demo-Ladung mit fünf Batches scheiterte batch_03 bei beiden Versuchen an einem simulierten Schemakonflikt. Die anderen vier wurden geladen, und die Zusammenfassung des Laufs sagt, ab wo erneut abgespielt wird, statt es der Person in Bereitschaft zu überlassen (Abbildung 6).
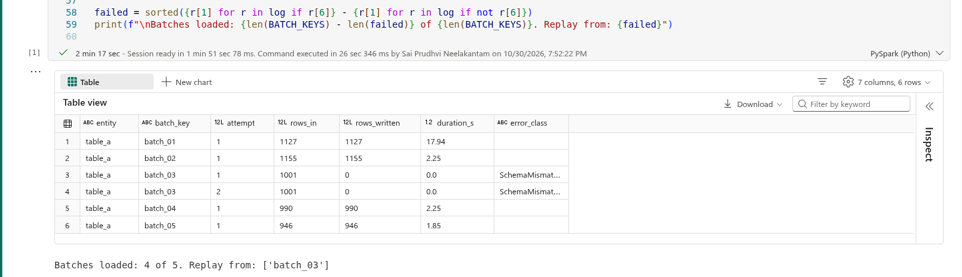
Abbildung 6. Eine Zeile pro Batch-Versuch: Entität, Batch-Key, Versuch, gelesene Zeilen, geschriebene Zeilen, Dauer und Fehlerklasse. Die Zusammenfassung nennt den fehlgeschlagenen Batch-Key, also spielt die Wiederholung batch_03 ab und nicht die ganze Ladung.
Rücksicht auf die Quelle gehört zur Zuverlässigkeit
Quell-APIs haben reale Drosselungsgrenzen. Das Batch-Design muss sie respektieren: Backoff, Obergrenzen für Parallelität und klare Fehlerklassen für Drosselung im Unterschied zu harten Fehlern. Wer Drosselung als allgemeinen Spark-Fehler behandelt, bringt Leuten bei, Cluster zu vergrößern. Wer sie als eigenständiges Signal behandelt, bringt Leuten bei, den Orchestrator zu tunen. Schreib die Regeln zur Rücksicht neben die Batch-Regler, damit "schneller" eine dokumentierte Obergrenze hat.
Schwellen gehören in die ADR, nicht ins Gedächtnis
Leg ungefähre Schwellen für Zeilen oder Bytes fest, ab denen ein Collect auf dem Driver verboten ist. Unter der Linie dürfen einfache Pfade für winzige Entitäten bleiben. Über der Linie ist Orchestrierung in Batches Pflicht. Pass die Schwellen an, wenn du dazulernst; tu nicht so, als wäre jede Entität für immer gleich groß. Der Sinn einer Zahl ist, mitten in einer Störung den Streit zu beenden, ob "diese hier" als groß gilt.
Häufige Fehler
Größere VM als Architektur. Kosten rauf, Fehler nur aufgeschoben.
Unbegrenzte Parallelität. Drosselung an der Quelle und Chaos im Cluster.
Kein Fortschritt. Menschen brechen Jobs ab, die noch liefen (oder sitzen ewig daneben).
Wiederherstellung nur durch alles neu laden. Engineers lassen Neuladungen aus; die Drift wächst.
Inkrementell, das so tut, als wäre es ein Neuaufbau. Fehlende Historie, unklare Watermarks.
Muster in Produktion ohne Metriken pro Batch. Der Support kann den Fehler nicht eingrenzen.
So übernehmen oder anpassen
So übernehmen
- Komplette Ladungen großer Tabellen nutzen Schreibvorgänge in Batches; InsertAll über den ganzen Driver ist oberhalb dokumentierter Schwellen verboten.
- Batchgröße und Parallelität sind pro Entität ausdrücklich, einstellbar und dokumentiert.
- Fortschritt und Ergebnisse pro Batch werden als strukturierte Logs geschrieben.
- Es gibt Filter für die Wiederherstellung nach Entität und Key-Bereich.
- Neuaufbau und inkrementelles Laden sind getrennte Modi mit getrennten Einstiegspunkten.
- Das Muster kommt nur mit Beobachtbarkeit pro Batch und einem Runbook in Produktion.
Vor dem Einsatz anpassen
Orchestrierung in Batches bringt mehr Code und mehr Regler. Die Einfachheit eines Collects auf dem Driver scheitert bei großen Tabellen. Weniger Parallelität ist langsamer und sicherer; tune mit Metriken, nicht mit Stolz. Getrennte Neuaufbau-Pfade duplizieren etwas Logik; duplizierte Modi schlagen beschädigte Modi. Beobachtbarkeit kostet vorab ein oder zwei Tage und spart Wochen an Störungsarchäologie.
Probier es selbst aus
Die batched ingest replay demo in meinem öffentlichen Repo tech-demos lädt fünf Batches in einem Fabric-Notebook, loggt jeden Versuch und endet mit 4 von 5 geladenen Batches und batch_03 zum erneuten Abspielen, sodass du das Lauf-Log und die Liste für die Wiederholung selbst sehen kannst.
Wichtigste Quellen: die Hinweise zur Überwachung von Spark-Jobs und zu Notebooks in Fabric auf Microsoft Learn, dazu die Dokumentation zur API-Drosselung der Quellsysteme für deine Konnektoren. Kombiniere sie mit einem Runbook, das Neuaufbau und inkrementelles Laden benennt. Beginne mit copy data activity und pipeline overview.
Teile die Arbeit in Batches. Zeig den Fortschritt. Filtere Wiederholungen. Halte den Neuaufbau ehrlich. Beobachte die Batches, bevor du das Muster produktionsreif nennst. Größere VMs sind optional. Klare Grenzen zwischen Batches nicht.