


Puntos clave
- Prohíbe el InsertAll de la entidad entera en el driver por encima de umbrales documentados de filas o bytes.
- Haz que el tamaño de lote y la concurrencia sean explícitos, ajustables y documentados por entidad.
- Registra por lote el id, las filas, la duración y el éxito o fallo como logs estructurados.
- Admite filtros por entidad y por rango de claves para que las repeticiones sigan siendo finitas.
- Mantén la reconstrucción y la carga incremental como modos separados con puntos de entrada separados.
- Lleva el patrón a producción solo con observabilidad por lote y un runbook.
Un InsertAll de la tabla entera en un solo driver es un modo de fallo conocido con tablas grandes. El notebook parece sencillo. El driver muere. Alguien pide un clúster más grande. La siguiente recarga muere más tarde, con una factura mayor.
Trata la recarga masiva como orquestación: ingesta paralela por lotes de páginas, seguimiento del progreso y filtros por entidad para repeticiones manejables. Separa las rutas de reconstrucción puntual de las marcas de agua incrementales. Lleva el patrón a producción solo cuando exista observabilidad por lote. Aquí, un OOM es una mala señal de diseño en el uso de la API del notebook, no una prueba de que "Fabric es inestable".
Modelo con nombre: lote → progreso → filtro → observación
- Lote: escrituras por página o por rango de claves con tamaño y concurrencia explícitos; nada de recolectar la entidad entera en el driver por encima del umbral.
- Progreso: logs estructurados por lote (id, filas, duración, éxito o fallo) para que "¿se ha quedado colgado?" se convierta en un número.
- Filtro: recuperación por entidad, partición o rango de claves sin volver a ejecutar toda la carga.
- Observación: las métricas por lote y un runbook son la puerta antes de producción.
- Contrato: el rendimiento con tablas grandes sale de lotes controlados y visibilidad, no de la esperanza de que el driver pueda materializarlo todo de una vez.
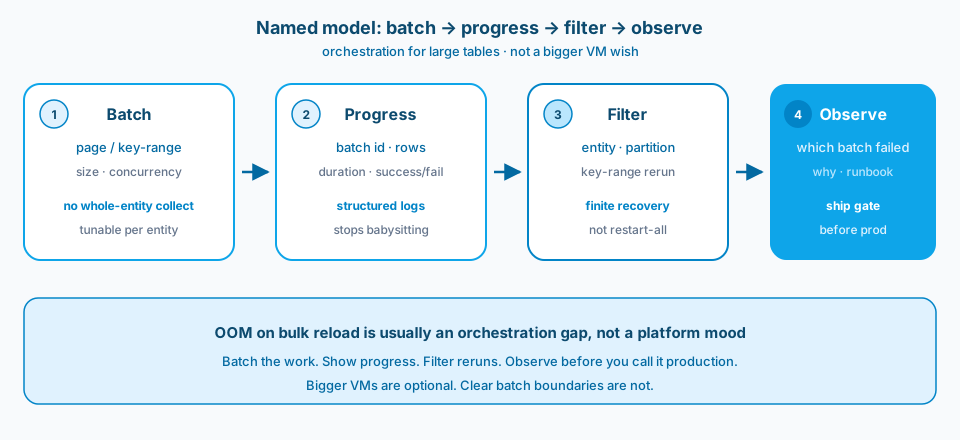
Figura 1. Lote, progreso, filtro, observación. Las VM más grandes son opcionales. Los límites claros entre lotes, no.
Contexto y restricción
Un patrón habitual: las recargas completas funcionan con tablas pequeñas y se hunden con las grandes. La API y Spark estaban bien. Al driver se le pedía sostener un universo. En cuanto cargamos por lotes con progreso y filtros, las recargas pasaron a ser operaciones aburridas en lugar de heroicidades de fin de semana.
El paralelismo sin límites entre lotes sigue provocando OOM; solo falla antes. El seguimiento del progreso convierte "¿se ha quedado colgado?" en un número. Los filtros por entidad te permiten repetir el trozo que falló sin volver a ejecutar toda la carga. Las marcas de agua incrementales no son una estrategia de reconstrucción; mantén las rutas separadas. La observabilidad es una puerta para el patrón, no un dashboard bonito para más adelante.
La figura 2 es el planteamiento de Learn para el trabajo de copia dentro de un pipeline. Un InsertAll de la tabla entera en un driver es una mala señal de orquestación. La ingesta por lotes pertenece a un pipeline manejable.
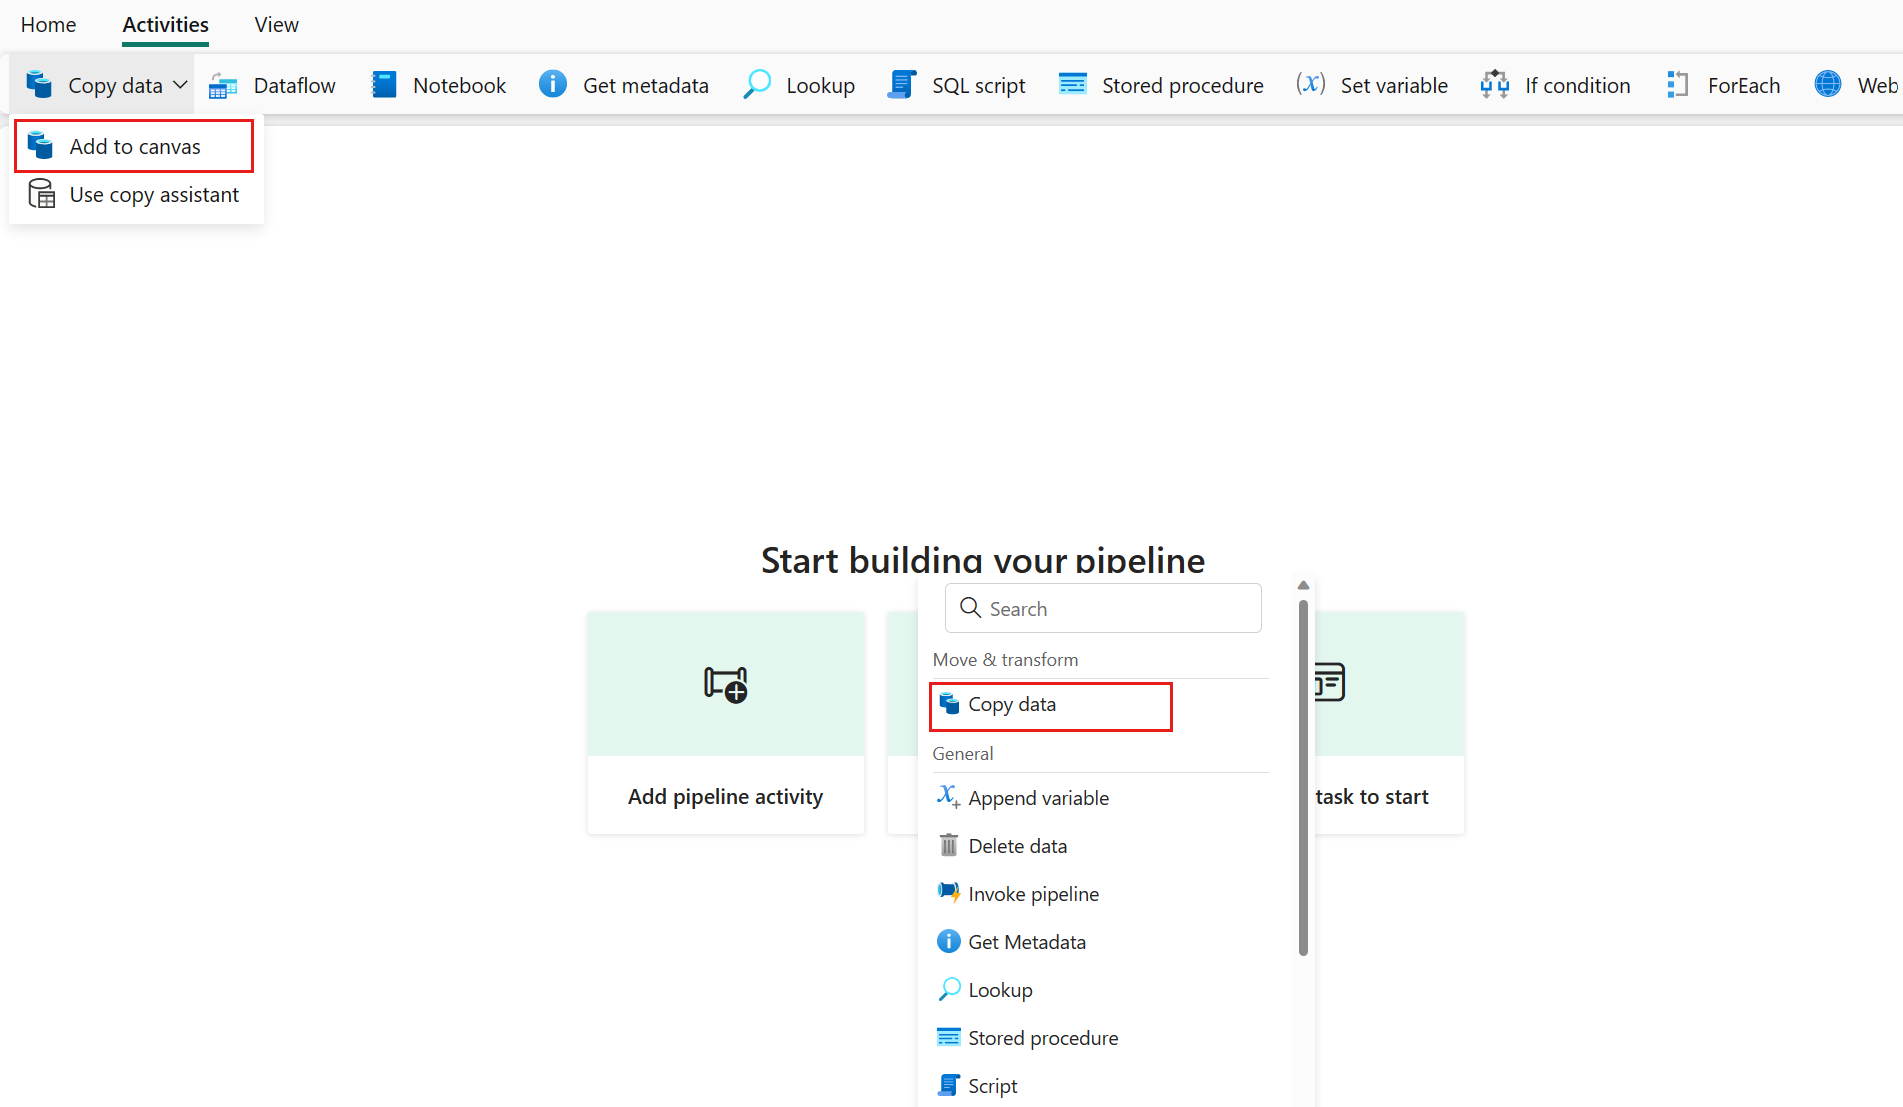
Figura 2. Un InsertAll de la tabla entera en un driver es una mala señal de orquestación. La ingesta por lotes pertenece a un pipeline manejable. Fuente: Microsoft Learn: copy data activity.
La figura 3 es el planteamiento de Learn para promover una ejecución programada. Carga por lotes con progreso y filtros por entidad, y después promueve el patrón como cualquier otro pipeline programado.
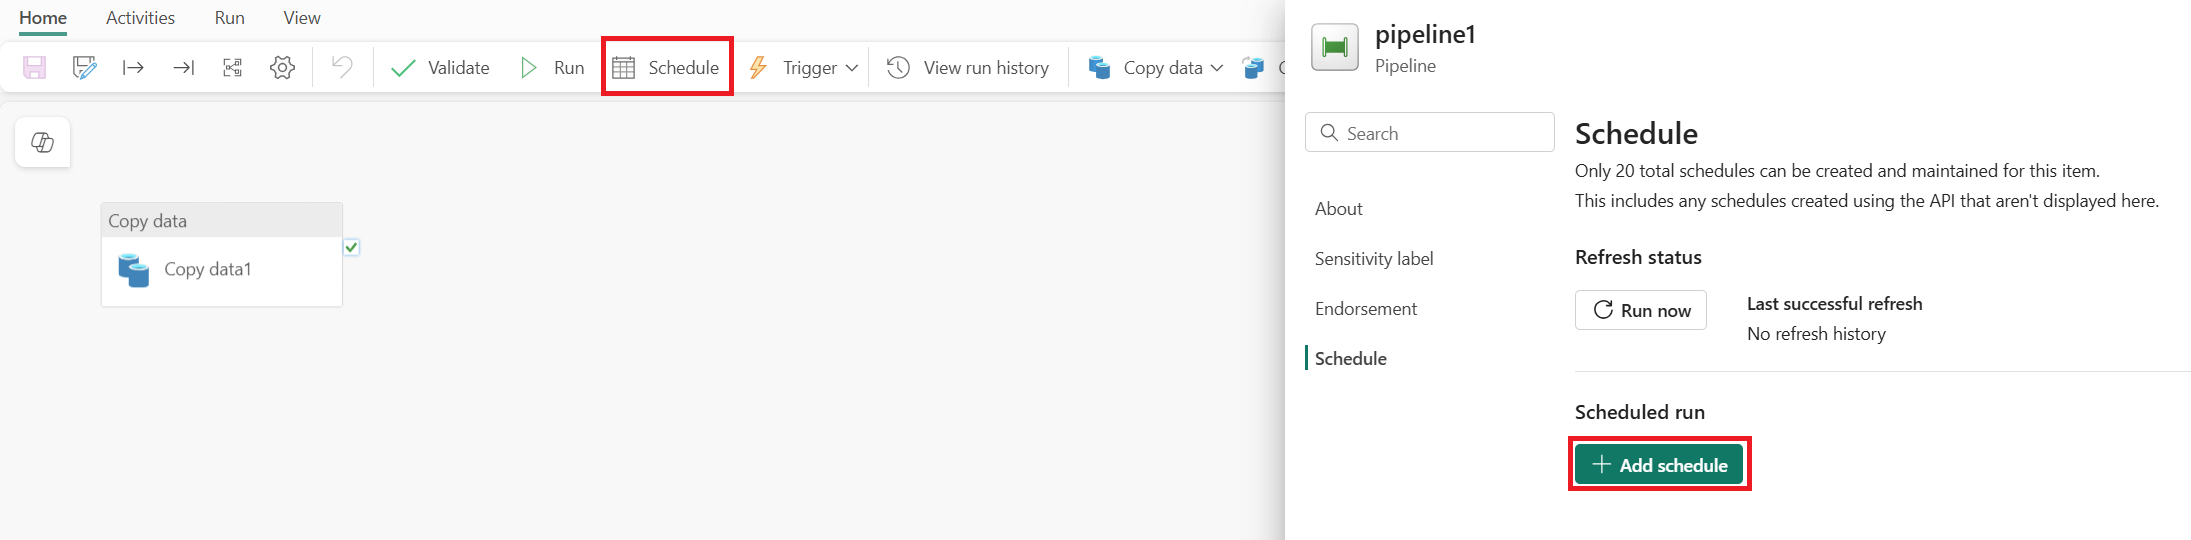
Figura 3. Carga por lotes con progreso y filtros por entidad, y después promueve el patrón como cualquier otro pipeline programado. Fuente: Microsoft Learn: pipeline overview.
Diseño
1. Prohíbe recolectar la entidad entera en el driver con tablas grandes
Si el patrón exige que el driver reúna la entidad completa antes de escribir, fallará a escala. Diseña para lotes por página o por rango de claves que escriban de forma incremental. Una sencillez que solo funciona con tablas pequeñas es una trampa. La figura 4 muestra el reparto de responsabilidades que mantiene ligera la memoria.
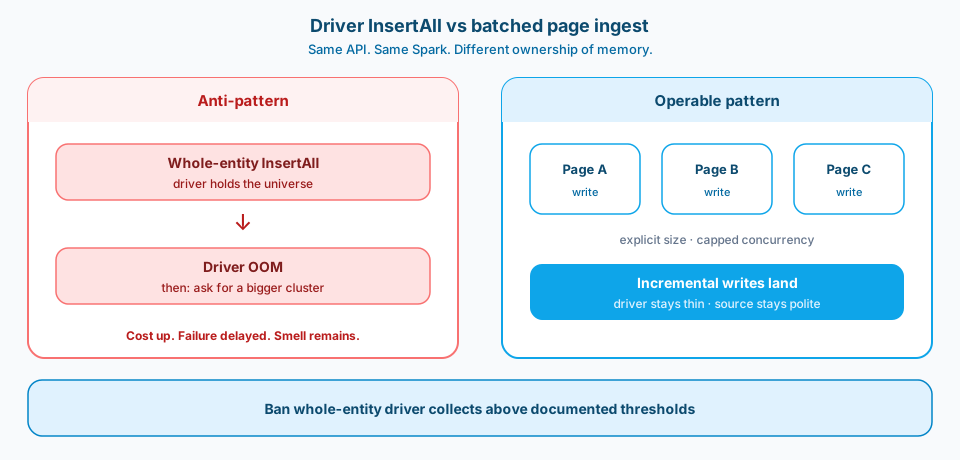
Figura 4. La misma API. El mismo Spark. Otro reparto de la memoria. Prohíbe recolectar la entidad entera en el driver por encima de umbrales documentados.
2. Carga por lotes con controles explícitos de tamaño y concurrencia
Elige tamaños de lote que puedas ajustar por entidad. Limita la concurrencia para no tumbar el origen ni tu propia capacidad. Documenta los valores por defecto y los controles que puede tocar operaciones. Los números mágicos enterrados en una celda se vuelven folclore bajo presión.
3. Emite progreso por lote
Registra el id del lote, los recuentos de filas, la duración y el éxito o fallo. Operaciones necesita un rastro cuando una recarga larga se detiene a medias. El progreso también alimenta los SLA y la planificación de capacidad. Los bucles silenciosos no son ingesta de nivel empresarial.
4. Filtros por entidad para repeticiones manejables
Permite volver a cargar una partición, una entidad o un rango de claves sin vaciarlo todo. Un reinicio completo como única vía de recuperación garantiza cansancio y atajos. Los filtros convierten los incidentes en trabajo finito.
5. Separa la reconstrucción de la carga incremental
Las rutas incrementales basadas en marcas de agua están optimizadas para el régimen estable. Las rutas de reconstrucción están optimizadas para la corrección tras cambios de esquema o de lógica. Mezclarlas produce estados aplicados a medias que cuesta explicar. Nombra los modos en el notebook y en el pipeline. La figura 5 muestra la separación y la puerta antes de entregar.
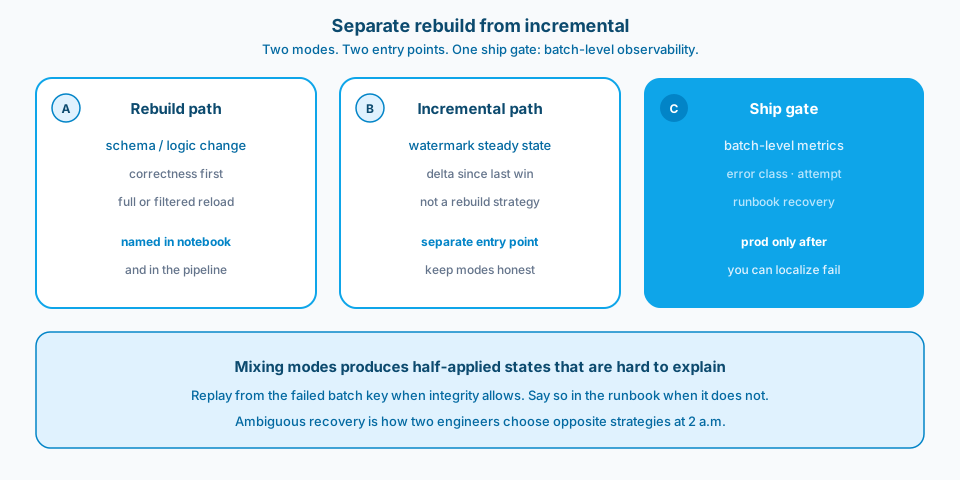
Figura 5. Dos modos. Dos puntos de entrada. Una puerta antes de entregar: observabilidad por lote. Mezclar modos produce estados aplicados a medias que cuesta explicar.
6. Exige observabilidad por lote antes de producción
Pasa a producción cuando puedas responder qué lote falló y por qué, no cuando una demo del camino feliz terminó una vez. Las métricas y los logs estructurados forman parte del contrato de ingesta. Sin ellos, cada OOM se convierte en una queja contra la plataforma.
Cómo es un buen registro por lote
Cada lote debería dejar una fila o una línea de log con la que pudieras montar una tabla pequeña: entidad, filtro, clave del lote, intento, filas leídas, filas escritas, duración, clase de error. Agrégalo en un resumen de la ejecución. Ante un fallo, operaciones repite desde la clave del lote que falló, no desde cero, salvo que la integridad exija una reconstrucción limpia. Si la integridad exige una reconstrucción limpia, dilo en el runbook. Una recuperación ambigua es la razón de que dos ingenieros elijan estrategias opuestas a las 2 de la madrugada.
En una carga de demo con cinco lotes, batch_03 falló en los dos intentos por un desajuste de esquema simulado. Los otros cuatro se cargaron, y el resumen de la ejecución dice desde dónde repetir en lugar de dejarlo en manos de quien esté de guardia (figura 6).
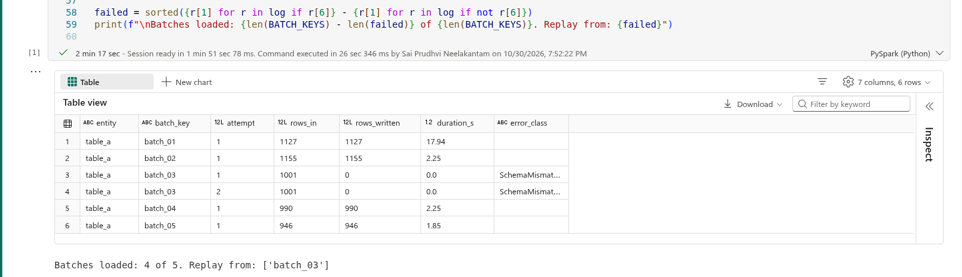
Figura 6. Una fila por intento de lote: entidad, clave del lote, intento, filas leídas, filas escritas, duración y clase de error. El resumen nombra la clave del lote que falló, así que la repetición vuelve a ejecutar batch_03 y no toda la carga.
Cuidar el origen forma parte de la fiabilidad
Las API de origen tienen límites de throttling reales. El diseño de los lotes tiene que respetarlos: backoff, límites de concurrencia y clases de error claras para distinguir throttling de fallo duro. Tratar el throttling como un error genérico de Spark enseña a la gente a agrandar clústeres. Tratarlo como una señal de primera clase les enseña a ajustar el orquestador. Pon las reglas de cortesía junto a los controles de los lotes para que "ir más rápido" tenga un techo documentado.
Los umbrales van en el ADR, no en la memoria
Define umbrales aproximados de filas o bytes a partir de los cuales se prohíbe recolectar en el driver. Por debajo de la línea pueden quedarse rutas sencillas para entidades diminutas. Por encima, la orquestación por lotes es obligatoria. Actualiza los umbrales cuando aprendas; no finjas que todas las entidades tendrán siempre el mismo tamaño. Un número sirve para cortar a mitad de un incidente la discusión sobre si "esta" cuenta como grande.
Errores comunes
Una VM más grande como arquitectura. Más coste y el fallo solo se retrasa.
Paralelismo sin límites. Throttling en el origen y caos en el clúster.
Sin progreso. La gente cancela jobs que seguían funcionando (o los vigila eternamente).
Recuperar solo volviendo a ejecutarlo todo. Los ingenieros se saltan las recargas; la deriva crece.
Una carga incremental que se hace pasar por reconstrucción. Historial perdido y marcas de agua poco claras.
Patrón en producción sin métricas por lote. Soporte no puede localizar el fallo.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Las cargas completas de tablas grandes usan escrituras por lotes; el InsertAll de todo en el driver está prohibido por encima de umbrales documentados.
- El tamaño de lote y la concurrencia son explícitos, ajustables y documentados por entidad.
- El progreso y el resultado de cada lote se registran como logs estructurados.
- Existen filtros para recuperar por entidad y por rango de claves.
- La reconstrucción y la carga incremental son modos separados con puntos de entrada separados.
- El patrón llega a producción solo con observabilidad por lote y un runbook.
Adáptalo antes de usarlo
La orquestación por lotes añade código y controles. La sencillez de recolectar en el driver falla a la escala de las tablas grandes. Menos concurrencia es más lento y más seguro; ajústala con métricas, no con orgullo. Las rutas de reconstrucción separadas duplican algo de lógica; los modos duplicados son mejores que los modos corruptos. La observabilidad cuesta uno o dos días al principio y ahorra semanas de arqueología de incidentes.
Pruébalo tú mismo
La batched ingest replay demo de mi repo público tech-demos carga cinco lotes en un notebook de Fabric, registra cada intento y termina con 4 de 5 lotes cargados y batch_03 pendiente de repetir, para que veas por ti mismo el log de la ejecución y la lista de repetición.
Referencias principales: la guía de monitorización de jobs de Spark y de notebooks de Fabric en Microsoft Learn, junto con la documentación de throttling de las API de los sistemas de origen de tus conectores. Combínalas con un runbook que distinga reconstrucción e incremental. Empieza por copy data activity y pipeline overview.
Divide el trabajo en lotes. Muestra el progreso. Filtra las repeticiones. Mantén honesta la reconstrucción. Observa los lotes antes de decir que el patrón está listo para producción. Las VM más grandes son opcionales. Los límites claros entre lotes, no.