

Das Wichtigste in Kürze
- Ein vollständiges Inventar der Views und ein Abhängigkeitsgraph sind die Voraussetzung für jede Massenumstellung auf MLVs.
- Regeln für die Auflösung von Schemas und Shortcuts sind dokumentiert, bevor die Silver- und Gold-Wellen starten.
- Ein vertikaler POC muss Parität und Laufzeit bestehen, bevor der lange Rest in Batches folgt.
- Ein Notebook (oder eine kleine Gruppe) pro MLV; gemeinsame Logik nur in Bibliotheken.
- Erfolg = Paritätsprüfungen + Laufzeitbudget, nicht die Existenz eines Objekts im Portal.
- Befördere in Wellen pro Schicht, mit Abbruchkriterien und einer benannten verantwortlichen Person pro Batch.
Eine Handvoll Warehouse Views auf Materialized Lake Views umzustellen ist ein Rewrite. Eine große Menge umzustellen ist ein Programm. Teams, die den langen Rest wie ein Wochenend-Notebook behandeln, lernen die Reihenfolge der Abhängigkeiten meist auf die harte Tour: Gold bricht, Silver dreht durch, und die Shortcuts in Bronze wurden nie als echte Quelle der Wahrheit registriert.
Rahme die Arbeit als Weg von Bronze über Silver nach Gold, mit Gates. Zähle die Views. Ordne sie nach Abhängigkeiten. Beweise einen repräsentativen POC. Dann stell mit einem Notebook pro View um, damit der Blast Radius lokal bleibt. Erfolg heißt Parität plus Laufzeit, nicht "das Portal zeigt eine MLV".
Benanntes Modell: von Bronze über Silver nach Gold, mit Gates
- Inventar und Reihenfolge: jede Warehouse View, ihre Referenzen und ihre Nutzer in einem Graphen, bevor irgendjemand SQL umschreibt.
- Bronze-Welle: Shortcut-Definitionen und Schemaauflösung stabilisieren sich zuerst, damit Namen für jede nachgelagerte MLV gleich aufgelöst werden.
- Silver-Welle: Transformationen werden zu MLVs in isolierbaren Notebooks; Parität und Laufzeit werden pro Batch verfolgt.
- Gold-Welle: Nutzer und bekannte Measures ziehen zuletzt um, wenn die Keys stabil sind.
- Gates: Ein vertikaler POC und ausdrückliche Abbruchkriterien liegen zwischen den Wellen. Die Zahl der Objekte im Portal ist kein Gate.
- Fertig: vereinbarte Parität gegenüber einer festgeschriebenen Baseline, plus eine Laufzeit innerhalb des Refresh-Fensters, das du tatsächlich fährst.
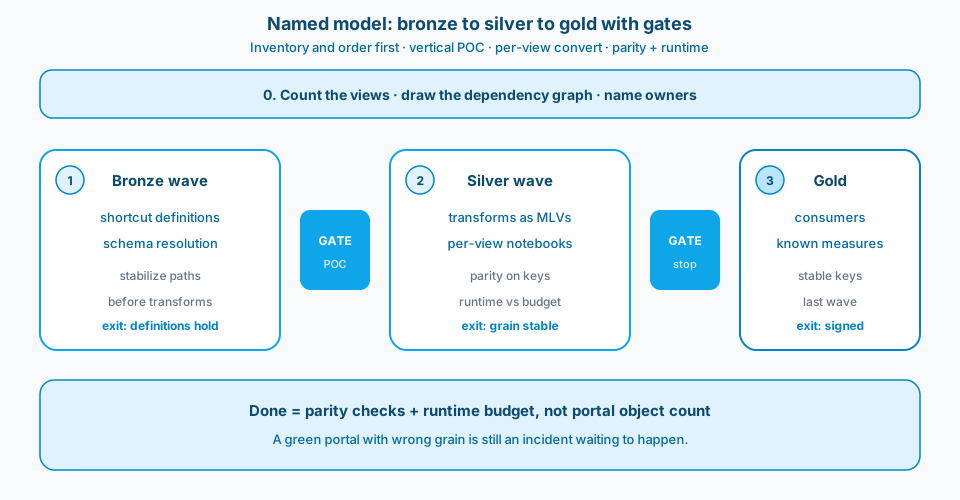
Abbildung 1. Benanntes Modell: von Bronze über Silver nach Gold, mit Gates. Zuerst Inventar und Reihenfolge. Wellen müssen sich die Beförderung verdienen. Grün im Portal ist keine Abnahme.
Kontext und Rahmenbedingung
Ein Graph von Warehouse Views sieht auf einer Folie oft flach aus und ist in Wirklichkeit tief verschachtelt. Ein Mega-Notebook, das "fast alles" umstellt, hinterlässt dem Team stillen Drift bei der Granularität. Das Portal war grün. Die fachlichen Measures nicht.
Lakehouses mit Schemas und Shortcut-Layouts in Bronze verändern, wie Namen aufgelöst werden. Views, die einen Warehouse-Katalog voraussetzten, brauchen eine ausdrückliche Antwort auf die Pfadfrage. Ein repräsentativer POC muss Parität und Laufzeit bestehen, bevor der lange Rest beginnt. Ein Notebook pro View hält Fehler isolierbar. "Die Views existieren" ist ein Statusbericht. "Die Views stimmen und werden im Budget fertig" ist ein Release.
Abbildung 2 zeigt die Medallion-Einordnung aus Learn. Schichten sind eine gemeinsame Bedeutung. Das Paket braucht trotzdem Gates, wenn du viele Views umstellst.
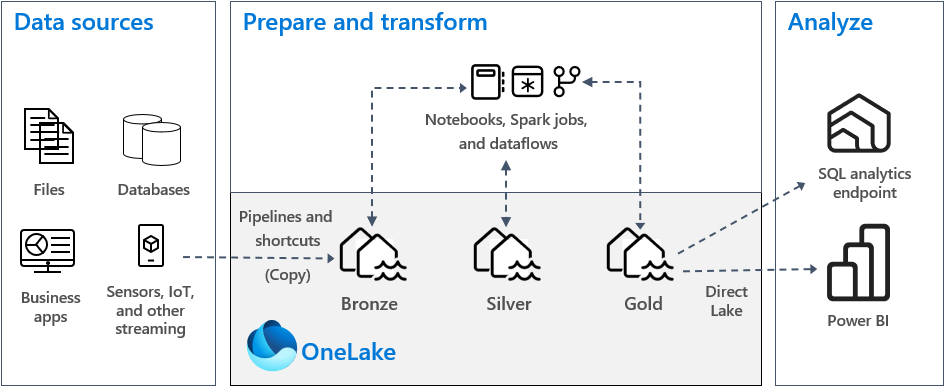
Abbildung 2. Die Migration auf MLVs ist ein Programm über Bronze, Silver und Gold. Gates gehören zwischen die Schichten, nicht in einen Wunsch nach einer Umstellung am Wochenende. Quelle: Microsoft Learn: medallion lakehouse architecture.
Design
1. Zuerst zählen und nach Abhängigkeiten ordnen
Erfasse jede Warehouse View, ihre Referenzen und ihre Nutzer (Berichte, nachgelagerte Views, Notebooks). Zeichne die Kanten, bevor du SQL umschreibst. Massenumstellung ohne Graph ist der Weg, auf dem du Blätter vor Stämmen umstellst und eine Woche fehlenden Objekten hinterherjagst. Zahlen schlagen Optimismus: Zähle die Views, nenne die Zahl und plane die Batches.
2. Die Auflösung für Lakehouses mit Schemas neu entwerfen
Shortcuts und Schemas sind keine Kosmetik. Pfade in Bronze können von flachen Warehouse-Objekten zu Lakehouse-Tabellen mit Schema-Präfix wechseln. Passe das Denkmodell und das SQL gemeinsam an. Dokumentiere, wie MLVs Bronze auf Basis von Shortcuts lesen und wie verwaltetes Silver. Die Migration ist zum Teil eine Namensraum-Migration, die sich als Syntax-Migration ausgibt.
3. Einen repräsentativen POC als Gate setzen
Wähle einen vertikalen Ausschnitt, der Shortcuts in Bronze, eine nicht triviale Transformation in Silver und einen Nutzer in Gold mit bekannten Measures berührt. Weise Zeilenzahlen, Key-Parität, Aggregate kritischer Spalten und die Laufzeit unter realistischer Parallelität nach. Erst dann öffne die Schleusen. Ein POC, der nur drei isolierte Views in Bronze umstellt, lehrt dich fast nichts über deinen echten Graphen.
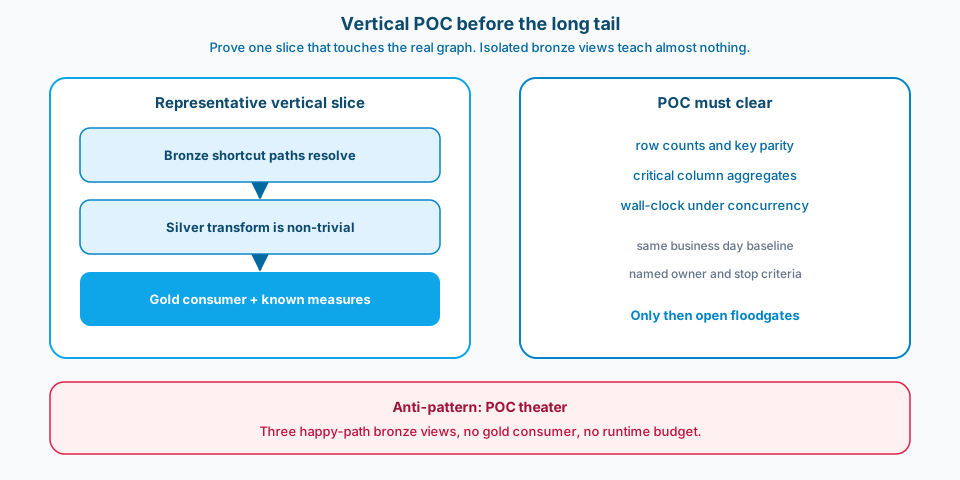
Abbildung 3. Vertikaler POC vor dem langen Rest. Ausschnitte nur aus Bronze im Idealfall sind POC-Theater.
4. Ein Notebook pro View statt eines Mega-Notebooks
Ein Notebook pro MLV (oder eine kleine, eng gekoppelte Gruppe) begrenzt den Blast Radius, klärt die Verantwortung und macht CI-Diffs lesbar. Mega-Notebooks verbergen, welches Objekt fehlgeschlagen ist, und laden dazu ein, "alles neu laufen zu lassen" als einzige Wiederherstellung. Gemeinsame Helfer gehören in Bibliotheken; Objektdefinitionen gehören in isolierbare Einheiten.
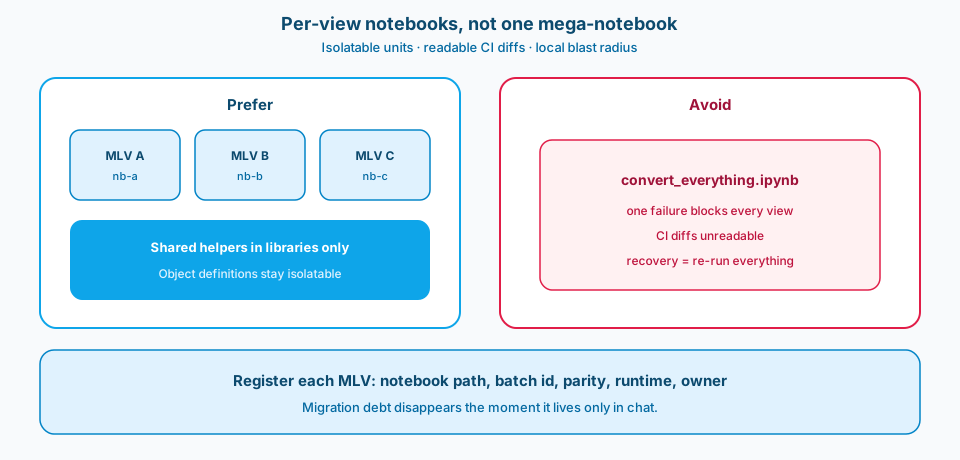
Abbildung 4. Ein Notebook pro View schlägt ein Mega-Notebook. Registriere für jede MLV Notebook-Pfad, Batch, Parität, Laufzeit und verantwortliche Person.
5. Erfolg als Parität plus Laufzeit definieren
Präsenz im Portal heißt nicht fertig. Fertig heißt, dass vereinbarte Paritätsprüfungen gegen die Warehouse-Baseline (oder einen eingefrorenen Snapshot) bestehen und die Laufzeit in das Refresh-Fenster passt, das du tatsächlich fährst. Verfolge beide Kennzahlen pro Batch. Eine schnelle, falsche MLV ist eine Fabrik für Regressionen.
6. In Wellen pro Schicht mit ausdrücklichen Abbruchkriterien befördern
Zuerst die Shortcut-Definitionen in Bronze, wenn sich Shortcuts stabilisieren müssen. Danach Silver für die Transformationen. Gold zuletzt, wenn Nutzer von stabilen Keys abhängen. Jede Welle hat Ausstiegskriterien und einen Plan für den Rollback. Wer Wellen überspringt, um "Zeit zu sparen", gibt sie meist doppelt im Störungsmodus aus.
Was die verantwortliche Person der Migration verfolgen sollte
Führe ein lebendes Register: Name der View, Schicht, Abhängigkeiten, Notebook-Pfad, POC- oder Batch-ID, Paritätsstatus, Laufzeit gegenüber Budget, verantwortliche Person. Geh es in demselben Meeting durch, in dem die Feature-Arbeit priorisiert wird. Migrationsschulden werden in dem Moment unsichtbar, in dem sie nur noch im Chat verfolgt werden. Wenn ein Batch rutscht, verschieb das Datum im Register; erweitere nicht still die Liste der Paritätsausnahmen.
Parallelbetrieb, ohne dich selbst zu belügen
Wenn du Warehouse Views neben den MLVs weiterlaufen lässt, binde den Vergleich an denselben Geschäftstag und dieselbe Menge an Keys. Ein Parallelbetrieb, der das Warehouse vom Dienstag mit dem Lakehouse vom Mittwoch vergleicht, produziert falsche Fehler und falsches Vertrauen. Halte fest, welchen Baseline-Snapshot der Paritätsjob verwendet hat. Wenn Stakeholder fragen, warum ein Batch zu spät ist, zeig das Register und die fehlschlagende Stufe, nicht ein vages Gefühl, dass "Spark langsam ist".
Häufige Fehler
Erst umschreiben, nie inventarisieren. Cleveres SQL, unbekannte Abhängige, überraschend kaputte Berichte.
Ein Notebook, sie alle zu knechten. Ein einzelner Fehler blockiert viele Objekte, die nichts miteinander zu tun haben.
POC-Theater. Nur Views für den Idealfall; kein Nutzer in Gold; kein Laufzeitbudget.
Annahme, Warehouse-Namen ließen sich eins zu eins übertragen. Schemas und Shortcuts verändern die Auflösung; still werden falsche Tabellen gelesen.
Sieg anhand der Objektzahl erklären. Ein Batch MLVs mit mehreren Paritätsfehlern ist keine Migration.
Gold umstellen, bevor es die Shortcuts in Bronze gibt. Du materialisierst Fiktion und gibst dann Spark die Schuld.
So übernehmen oder anpassen
So übernehmen
- Ein vollständiges Inventar der Views und ein Abhängigkeitsgraph sind die Voraussetzung für jede Massenumstellung auf MLVs.
- Regeln für die Auflösung von Schemas und Shortcuts sind dokumentiert, bevor die Silver- und Gold-Wellen starten.
- Ein vertikaler POC muss Parität und Laufzeit bestehen, bevor der lange Rest in Batches folgt.
- Ein Notebook (oder eine kleine Gruppe) pro MLV; gemeinsame Logik nur in Bibliotheken.
- Erfolg = Paritätsprüfungen + Laufzeitbudget, nicht die Existenz eines Objekts im Portal.
- Beförderung in Schichten mit Abbruchkriterien und einer benannten verantwortlichen Person pro Batch.
Vor dem Einsatz anpassen
Programm-Overhead fühlt sich neben "stell es einfach um" langsam an. Er ist schneller als eine halbe Umstellung, die das Reporting einfriert. Ein Notebook pro View erzeugt mehr Dateien; dafür verschwindet das Rätselraten. Strenge POC-Gates nerven Stakeholder, die lieber ein Datum als einen Nachweis wollen. Gib ihnen beides: ein Datum, das von den Kennzahlen der Gates abhängt. Ein Redesign der Schemas kann vorübergehend Kosten für einen Parallelbetrieb erzwingen. Plane sie ein. Parallelbetrieb ohne Paritätsjobs ist Theater.
Wichtigste Quellen: Materialized Lake Views und lakehouse schemas auf Microsoft Learn. Kombiniere sie mit deinem Shortcut-Inventar und einem schriftlich festgelegten Paritäts-Harness.
Zähle den Graphen. Beweise einen Ausschnitt. Stell in isolierbaren Einheiten um. Erklär es für fertig, wenn Parität und Laufzeit übereinstimmen, nicht wenn das Portal beschäftigt aussieht.
Verwandte Notizen
- MLV + SCD2: Ist SCD2 in Bronze das richtige Muster vor Silver MLVs? (Historientabellen als MLVs vor Stichtagsberichten)
- MLV-Datenqualität: Warum gibt es keine nativen Eindeutigkeitsprüfungen pro Spalte? (Prüfungen pro Spalte für jede Umstellung)
- Warehouse Views: Solltest du schwere Views für Direct Lake materialisieren? (welche schweren Views sich zuerst zu materialisieren lohnen)
- NEE Fallback: Warum weichen Ergebnisse mit und ohne Native Execution Engine ab? (wohin die Laufzeit einer MLV tatsächlich geht)