

Das Wichtigste in Kürze
- Performance-Arbeit an MLVs beginnt mit Baselines der tatsächlichen Laufzeit und einer Zuordnung pro View.
- NEE-Warnungen werden als behebbar, zu untersuchen oder akzeptiert eingestuft, jeweils mit Verantwortlichem.
- Umschreiben braucht eine gemessene Wirkung auf die Latenz, nicht nur weniger Warnungen.
- Langsame Knoten lassen sich mit Diagnose-Notebooks pro View isolieren.
- Akzeptierte Warnungen sind für die Rufbereitschaft dokumentiert und werden nach Runtime-Änderungen neu geprüft.
- Prüfungen von Kapazität und Parallelität begleiten die Analyse der SQL-Fallbacks.
Läufe von Materialized Lake Views spucken Fluten von Warnungen aus, die Fallbacks der Native Execution Engine erwähnen. Teams schreiben panisch Spark SQL um, um jeder Zeile hinterherzujagen. Währenddessen versteckt sich die Laufzeit des DAG weiter in einem langsamen Knoten, den niemand gemessen hat.
Miss zuerst. Die eingefügten Warnungen enthalten Interna von Delta und von MLV-Metadaten, die du weder entfernen kannst noch musst. Eine Zuordnung der Laufzeit schlägt Umschreiben aus Angst. Behebe die wenigen Fallbacks, die die Latenz bewegen. Ignoriere den Rest bewusst. Dokumentiere akzeptierte Warnungen, damit die Rufbereitschaft nicht ins Schleudern kommt. Kombiniere das mit Notebooks pro View, damit sich langsame Knoten isolieren lassen.
Benanntes Modell: Baseline → einstufen → die Treiber beheben
- Baseline: Halte die Gesamtdauer des MLV DAG und die Zeiten pro View fest, bevor irgendwer SQL umschreibt.
- Einstufen: Sortiere NEE-Zeilen in behebbar, zu untersuchen oder akzeptiert, mit Verantwortlichem und Anlass für eine erneute Prüfung.
- Treiber beheben: Belege die Latenz vorher und nachher auf den heißen Stages. Lass günstige Fallbacks dokumentiert in Ruhe.
- Regel: Behebbare Fallbacks sind eine Frage des Latenzbudgets, kein Reinheitswettbewerb um null Warnungen.
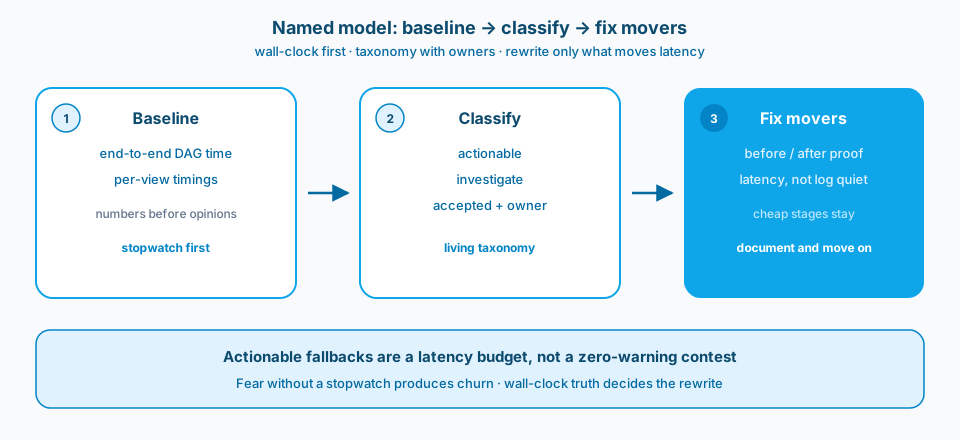
Abbildung 1. Benanntes Modell für die Arbeit an NEE bei Materialized Lake Views. Zuerst Zahlen, dann eine Einteilung, Umschreiben nur dort, wo sich die Laufzeit bewegt.
Kontext und Rahmenbedingung
Wände aus Warnungen wirken dringend und enthalten meist sehr wenig, das sich beheben lässt. Die nützliche Arbeit beginnt, wenn du Stages misst, Views isolierst und eine Liste akzeptierter Warnungen pflegst. Die Latenz sinkt, wenn du die wenigen Fallbacks behebst, die zählen, nicht wenn du jedem nachjagst, der nicht zählt.
Manche NEE-Meldungen sind Umgebungsrauschen rund um Metadaten und Interna der Plattform. Andere markieren Operatoren, die tatsächlich den nativen Pfad verlassen und Minuten kosten. Deine Aufgabe ist die Zuordnung: Welche Warnungen hängen mit der Laufzeit zusammen, welche sind akzeptiert und welche verdienen ein Umschreiben? Angst ohne Stoppuhr erzeugt nur Unruhe.
Abbildung 2 zeigt die Oberfläche für Spark-Jobs in Fabric, die die Zeit pro Stage sichtbar macht. Ordne dort zuerst zu. Den Text der Warnungen auf dem kritischen Pfad öffnest du danach.
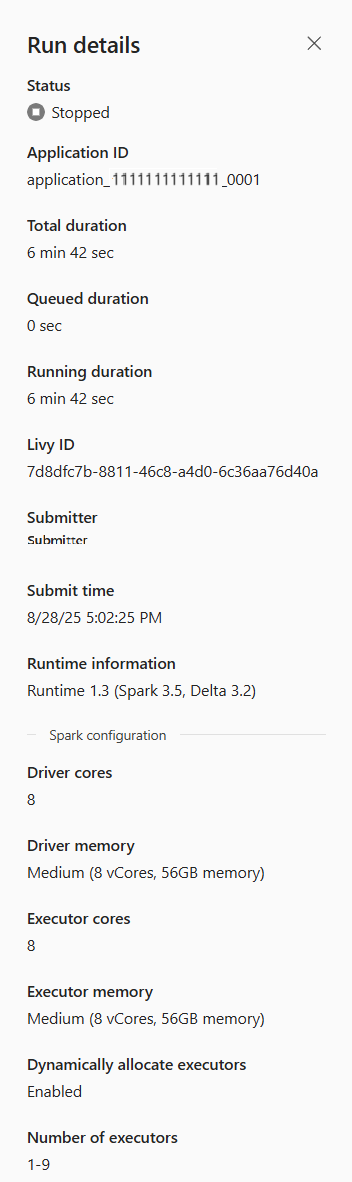
Abbildung 2. Ordne die MLV-Zeit mit Job-Details und dem tatsächlichen DAG zu. Behandle nicht jede NEE-Warnung als Auftrag zum Umschreiben. Quelle: Microsoft Learn: Übersicht über das Spark-Monitoring.
1. Die Laufzeit erfassen, bevor du SQL umschreibst
Halte die Gesamtdauer des MLV DAG und die Zeiten pro View fest. Ohne Baseline sieht jede Änderung im Meeting wie ein Gewinn aus und in Produktion wie ein Nullsummenspiel. Erst Zahlen, dann Meinungen. Abbildung 1 zeigt diese Reihenfolge als drei Schritte.
2. Warnungen in behebbar und akzeptiert einteilen
Baue eine kurze Einteilung: bekanntes Rauschen, untersuchen, muss behoben werden. Aktualisiere sie, wenn sich die Plattform ändert. Eine lebende Liste ist besser, als jedes Quartal denselben beängstigenden Text neu zu entdecken. Abbildung 3 zeigt die Einteilung, die die Rufbereitschaft auch um 2 Uhr nachts lesen kann.
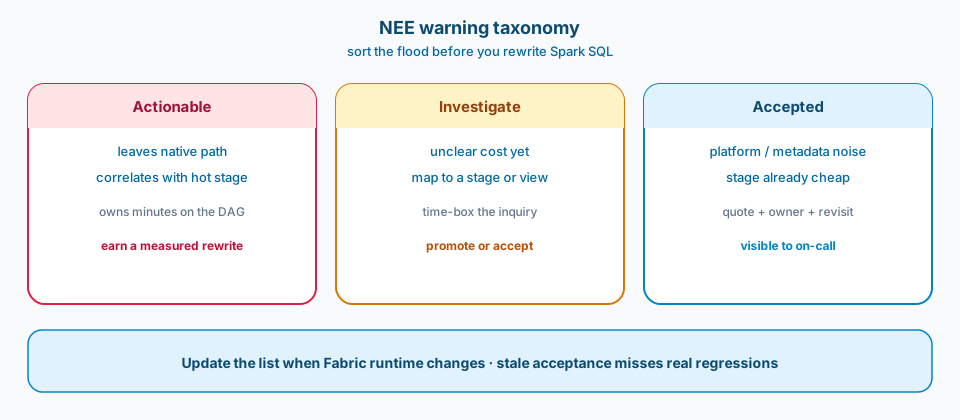
Abbildung 3. Sortiere die Flut, bevor du umschreibst. Behebbares kostet Minuten und hat einen Verantwortlichen. Zu Untersuchendes bekommt ein festes Zeitfenster. Akzeptiertes bleibt sichtbar, mit Verantwortlichem und Anlass für eine erneute Prüfung.
3. Nur Fallbacks beheben, die die Latenz bewegen
Belege mit Zeiten vorher und nachher, dass ein Umschreiben hilft. Wenn ein Fallback bleibt und die Stage ohnehin günstig ist, dokumentiere es und mach weiter. Heldenhaftes SQL, das einen winzigen Teil eines langen DAG einspart, ist Theater.
4. Langsame Knoten mit Notebooks pro View isolieren
Wenn ein DAG undurchsichtig ist, führe verdächtige Views einzeln aus. Durch die Isolierung wird aus "die MLV ist langsam" ein "dieses Join-Muster ist langsam". Geteilte Cluster und geteilte Schuld helfen niemandem. Abbildung 4 zeigt die Aufteilung der Verantwortung, die mit den Legenden Schluss macht.
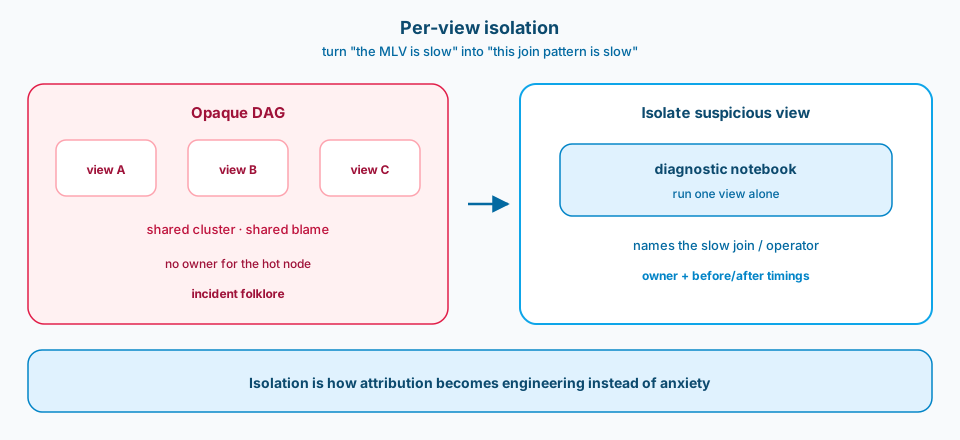
Abbildung 4. Undurchsichtige DAGs erzeugen geteilte Schuld. Ein Diagnose-Notebook, das eine einzige View ausführt, benennt den langsamen Operator und gibt ihm einen Verantwortlichen.
5. Akzeptierte Warnungen für die Rufbereitschaft sichtbar halten
Veröffentliche die Liste der akzeptierten Warnungen neben dem Runbook. Die Rufbereitschaft sollte sich um 2 Uhr nachts nicht wegen dokumentiertem Rauschen selbst alarmieren. Schweigen ohne Dokumentation ist der Weg, auf dem aus Rauschen später ein ignoriertes Signal wird.
6. Nach Plattform-Upgrades neu prüfen
Native Engines entwickeln sich weiter. Eine Warnung, die Rauschen war, kann behebbar werden, oder umgekehrt. Plane erneute Prüfungen nach Änderungen an der Fabric Runtime ein. Veraltete Listen akzeptierter Warnungen sind der Grund, warum echte Regressionen übersehen werden.
Zuordnen, ohne in der Spark UI zu ertrinken
Beginne mit der Gesamtdauer des MLV-Laufs und den drei Stages mit der meisten Zeit. Ordne die Stages den Views oder Operatoren zu, für die du verantwortlich bist. Erst dann öffnest du den Text der Warnungen für diese heißen Stages. Wer in einem kalten Lauf jede Warnung liest, lernt Angst. Wer die Warnungen auf dem kritischen Pfad liest, lernt Engineering. Speichere vollständige Dumps der Warnungen als Artefakte und analysiere gezielt.
Was in ein ADR für akzeptierte Warnungen gehört
Zitiere das Muster der Warnung, warum sie auftritt, warum sie akzeptiert ist, wer die erneute Prüfung verantwortet und welche Kennzahl ein Wiederaufrollen erzwingen würde. Füge eine Beispielzeile aus dem Log hinzu. Eine vage Akzeptanz ("Plattformkram") lässt die nächste neue Kollegin im Stich. Eine konkrete Akzeptanz übersteht Upgrades und Audits.
Zusammen mit der Wahrheit über Kapazität und Parallelität
Manchmal ist die Laufzeit einer MLV Warteschlange und Drosselung, nicht NEE. Miss Kennzahlen zu Parallelität und Kapazität neben der Arbeit an den Fallbacks. Sonst verbrennst du eine Woche damit, Spark zu "reparieren", während die Plattform einfach denselben Slot überbucht hat. Zur Zuordnung gehört die Umgebung, nicht nur die Form des SQL.
Ergebnisse kommunizieren ohne Warnungstheater
Wenn du Stakeholdern erzählst, dass eine MLV schneller geworden ist, zeig die Laufzeit und die ein oder zwei Fallbacks, die du behoben hast. Feiere kein ruhigeres Log, wenn sich die Dauer nicht bewegt hat. Ruhige Logs bei unveränderter Latenz bringen der Führung bei, Kosmetik zu finanzieren. Laute Logs mit einer klaren Liste akzeptierter Warnungen bringen ihr bei, Messung zu finanzieren. Zeig lieber Diagramme der Dauer pro View als Screenshots von gelbem Warntext.
Häufige Fehler
Null Warnungen als KPI. Teams schreiben für die Kosmetik um. Das Log ist ruhig, der DAG unverändert.
Keine Baseline. Änderungen lassen sich nicht beurteilen. Jeder PR behauptet einen Gewinn.
Legenden nur auf DAG-Ebene. "Das war schon immer langsam." Niemand benennt eine View oder eine Stage.
Undokumentierte Akzeptanz. Jede Rufbereitschaft lernt die Panik über dieselben Metadatenzeilen neu.
Nie neu prüfen. Alte Einstufungen als Rauschen überleben nach einem Runtime-Upgrade die Wahrheit.
Geteilte Schuld. Keine Isolierung pro View, keine Verantwortlichen. Abbildung 4 macht diesen Fehler sichtbar.
So übernehmen oder anpassen
So übernehmen
- Performance-Arbeit an MLVs beginnt mit Baselines der tatsächlichen Laufzeit und einer Zuordnung pro View.
- NEE-Warnungen werden als behebbar, zu untersuchen oder akzeptiert eingestuft, jeweils mit Verantwortlichem.
- Umschreiben braucht eine gemessene Wirkung auf die Latenz, nicht nur weniger Warnungen.
- Langsame Knoten lassen sich mit Diagnose-Notebooks pro View isolieren.
- Akzeptierte Warnungen sind für die Rufbereitschaft dokumentiert und werden nach Runtime-Änderungen neu geprüft.
- Prüfungen von Kapazität und Parallelität begleiten die Analyse der SQL-Fallbacks.
Vor dem Einsatz anpassen
Listen akzeptierter Warnungen fühlen sich wie Aufgeben an. Kreuzzüge für null Warnungen fühlen sich produktiv an und verschwenden Wochen. Notebooks pro View fügen operative Pfade hinzu, undurchsichtige DAGs verlängern Incidents. Termine für erneute Prüfungen belasten den Kalender. Sie auszulassen ist ein stilles Risiko für Regressionen. Gewinne bei der Latenz zu belegen verlangsamt PRs und verhindert Blogposts über falsche Siege.
Wichtigste Quellen: Übersicht über das Spark-Monitoring und Übersicht über Materialized Lake Views auf Microsoft Learn. Kombiniere sie mit deiner Liste akzeptierter Warnungen, damit Engineers wissen, welche Realität sie optimieren.
Miss den DAG. Stufe das Rauschen ein. Behebe, was die Latenz bewegt. Dokumentiere, was du akzeptierst. Isoliere langsame Views. Prüfe nach Upgrades neu. Die meisten NEE-Zeilen sind nicht dein Notfall. Die gemessene Laufzeit ist es.