

Das Wichtigste in Kürze
- Behandle ein Fabric-Deployment als Operation am Workspace: Item-Graph, stabile IDs und eine schriftliche Liste dessen, was nie blind übernommen wird.
- Git meldet die Änderung im Quellcode; der Deployer meldet, was er abgleichen wird. Diese Mengen hängen zusammen, sind aber nicht identisch.
- Halte die GUIDs von Workspace, Lakehouse und Connections in der Konfiguration. Anzeigenamen sind nur Beschriftungen.
- Parametrisiere Connections und Deployment-Regeln, damit Prod nicht die Bindungen aus Dev erbt.
- Gruppiere nach release train; schließe Item-Typen, die an Connections hängen, aus oder behandle sie gesondert.
- Beweise Filter, Ersetzungen und die Auflösung der Connections in einer Wegwerf-Sandbox, bevor du gemeinsame Stages anfasst.
Deine Pipeline läuft. Die Hälfte der Notebooks hast du nicht angefasst. Sie werden trotzdem veröffentlicht.
Das ist nicht immer ein Fehler in deinem YAML. Die Deployment-Modelle von Fabric und die Paarung der Items sind oft auf einen konsistenten Workspace ausgelegt, nicht auf minimale Diffs wie in Git. Wenn du so planst, als würden nur geänderte Dateien bewegt, belehrt dich die Produktion eines Besseren.
Behandle ein Fabric-Deployment als Operation am Workspace, mit einem expliziten Item-Graph, stabilen Identitäten und einer schriftlichen Liste dessen, was nie blind befördert werden darf. Git sagt dir, was sich im Quellcode geändert hat. Der Deployer sagt dir, was er im Ziel abgleichen wird. Diese Mengen hängen zusammen, sind aber nicht identisch.
Benanntes Modell: Git-Änderung gegen Deploy-Fläche
- Git-Change-Set: die Dateien, die du angefasst hast, Pfadfilter und der Diff des PR. Beantwortet, was sich im Quellcode geändert hat.
- Abgleichsmenge des Deployers: der Item-Graph, den das Tool für einen Ordner oder eine Pipeline-Stage veröffentlicht, einschließlich gepaarter Mitläufer.
- Nie-blind-Liste: Connections, Bindungen, Remap-Regeln für semantische Modelle, stagespezifische Zugriffe und persönliche Standardwerte aus einem Spike, die ohne explizite Regeln nicht befördert werden dürfen.
- Vertrag: zusammenhängende Mengen, keine identischen. Mach Dry Runs, bis Menschen jedes Item benennen können, das das Tool anfasst.
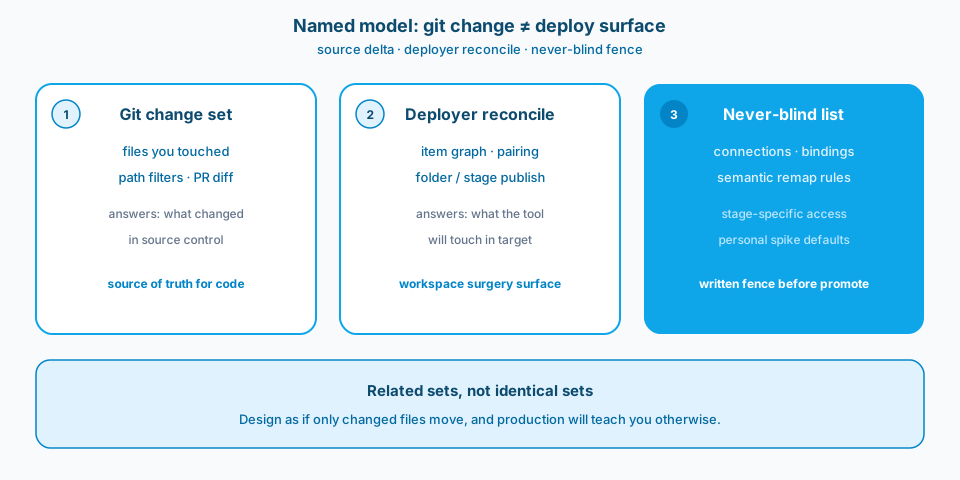
Abbildung 1. Git meldet die Änderung im Quellcode. Der Deployer meldet die Fläche der Operation am Workspace. Die Nie-blind-Liste ist der schriftliche Zaun. Plane so, als wären diese Mengen identisch, und die Produktion korrigiert dich.
Kontext und Rahmenbedingung
Ich habe gesehen, wie Läufe von fabric-cicd und Deployment Pipelines nach einer einzeiligen Änderung in einem Notebook einen breiten Graph von Items neu veröffentlicht haben. Der Git-Diff war winzig. Die Operation am Workspace nicht. Der Blast Radius ist eine Designvorgabe für Analytics-CI/CD, kein nachträglicher Gedanke für den Incident-Kanal.
Deployment Pipelines, fabric-cicd und Promotions im Portal haben jeweils eigene Vorstellungen davon, wie Items gepaart und parametrisiert werden und welche Item-Typen mitlaufen. Kenne diese Vorstellungen vor dem ersten Lauf in einer gemeinsamen Stage, und strukturiere die Ordner so, dass ein lautes Publish nicht versehentlich Flächen überschreibt, die an Connections hängen.
Abbildung 2 zeigt die Learn-Darstellung eines Deployments als Operation am Workspace, nicht als Dateikopie des Git-Diffs.
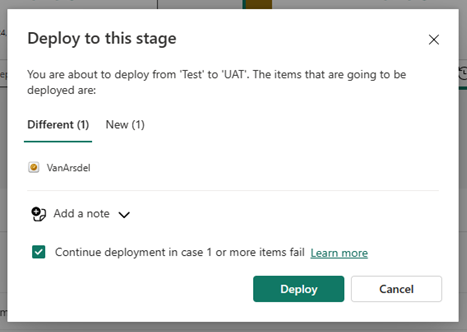
Abbildung 2. Ein Deployment ist eine Operation am Workspace. Quelle: Microsoft Learn: deployment pipelines.
Design für den Blast Radius
1. Stabile IDs statt schöner Namen
Den Anzeigenamen eines Workspace zu ändern sollte nicht erfordern, Lakehouses neu anzulegen. Halte die GUIDs von Workspace, Lakehouse und Connections in der Konfiguration. Anzeigenamen sind nur Beschriftungen. Pipelines, die sich an Anzeigetexten orientieren, brechen beim ersten Mal, wenn jemand im Portal das Branding aufräumt. Wenn Items über Dev, Test und Prod gepaart sind, gehört die Identität der Paarung zu deinem Vertrag. Ein Item neu anzulegen, um einen Namen zu reparieren, trennt oft die Paarung und macht aus dem nächsten Deployment eine Operation, die alles neu anlegt. Abbildung 3 zeigt diese Aufteilung der Zuständigkeit.
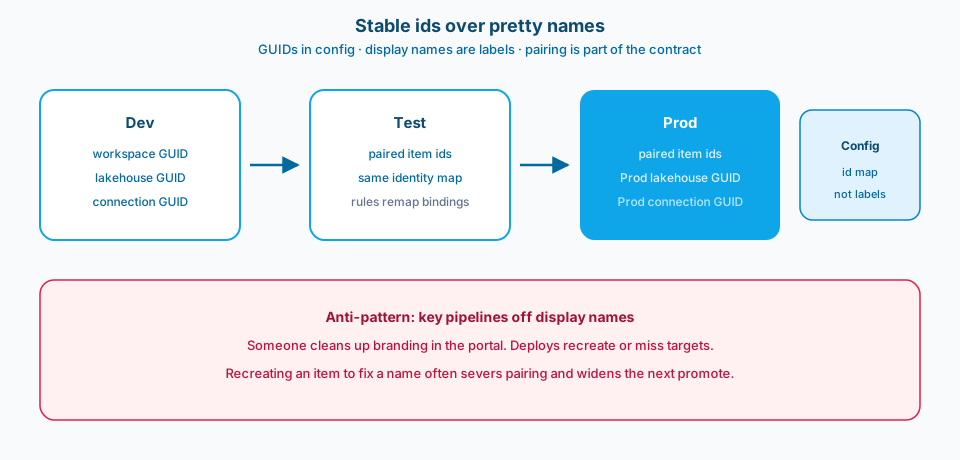
Abbildung 3. Stabile IDs reisen in der Konfiguration mit. Anzeigenamen sind Beschriftungen. Wer Deployments an schönen Namen festmacht, verwandelt ein Branding-Aufräumen in ein Neuanlegen oder einen Fehltreffer.
2. Wisse, was dein Deployer als Änderung betrachtet
Manche Tools deployen einen ganzen Graph von Items neu, wenn du einen Workspace-Ordner oder eine Pipeline-Stage deployst. Mach einen Dry Run in einer Sandbox, bevor du darauf vertraust, dass nur Deltas bewegt werden. Lies die Hinweise des Tools zu Notebooks, semantischen Modellen, Pipelines, Lakehouses und Environment-Items. "Keine Git-Änderung" garantiert nicht "kein Publish". Wenn du fabric-cicd aus Azure DevOps oder GitHub verwendest, richte lokale Skripte an denselben Pfaden, Parametern und Item-Filtern aus. Abweichende Abkürzungen auf dem Laptop werden zu Überraschungen, wenn der Serverpfad mehr neu veröffentlicht.
Die Git-Seite dieses Vergleichs ist eine Liste pro Item. In einem Trial-Workspace zum Ausprobieren, der mit einem Wegwerf-Branch verbunden ist, zeigt Source control Changes (2): demo_nb und demo_git_lh, beide neu, und die Workspace-Liste markiert dieselben zwei Items als Uncommitted. Der SQL analytics endpoint des Lakehouse hat keinen eigenen Git-Status; er läuft mit dem Lakehouse mit (Abbildung 4). Diese Liste ist das, was Git committen wird. Sie ist nicht die Liste, die ein Deployer im Ziel abgleichen wird.
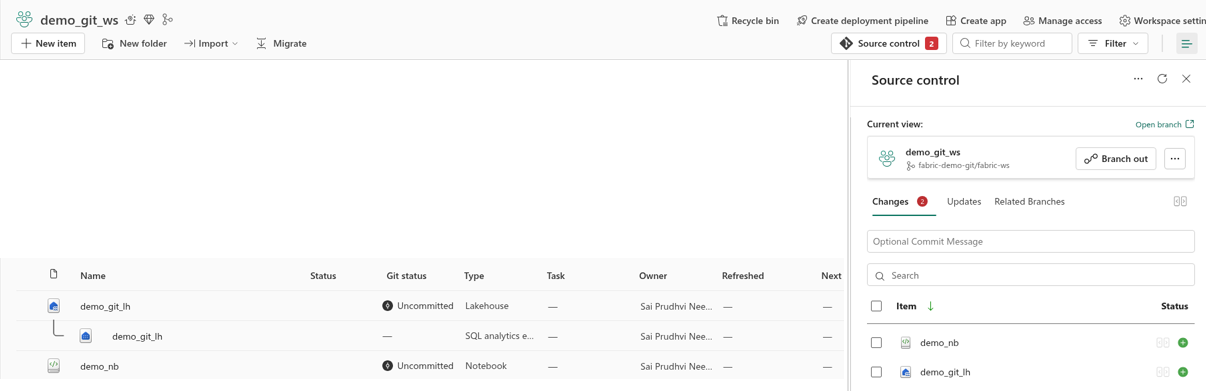
Abbildung 4. Git sieht Änderungen pro Item: zwei neue Items, zwei Zeilen, sonst nichts. Der SQL analytics endpoint hat keine eigene Zeile. Diese Liste pro Item ist der Blast Radius, den Git meldet, nicht das, was ein Deployment anfasst. Leere Arbeitsfläche abgeschnitten; es wurde nichts committet.
3. Trenne Inhalte, die zusammen wandern müssen, von solchen, die es nicht sollen
Riesige Monorepo-Ordner mit Notebooks, die nichts miteinander zu tun haben, laden zu lauten Publishes ein. Gruppiere nach release train: gemeinsame Utilities, fachliche Transformationen, semantische Modelle und Runbooks brauchen vielleicht unterschiedliche Promotion-Regeln. Items, die Connections, IDs auf Workspace-Ebene oder Annahmen zur Kapazität enthalten, sollten parametrisiert oder von blinder Promotion ausgeschlossen werden. Frag pro Item-Typ: Wenn das unverändert neu veröffentlicht wird, was bricht dann? Ein überschriebenes Notebook ist vielleicht harmlos. Ein semantisches Modell mit überschriebenen Parametern vielleicht nicht.
4. Parametrisiere Connections und Environment-Bindungen
Variable Libraries, Deployment-Regeln und parametrisierte Connections gibt es, damit Prod nicht die Lakehouse-IDs aus Dev erbt. Nutze sie. Ein Item zu befördern, das noch auf einen SQL endpoint in Dev zeigt, ist ein klassischer Fehler: Das Deployment war erfolgreich, und die Produktion liest die falsche Stage. Identischer Notebook-Text heißt nicht, dass das gebundene Lakehouse sicher ist. Bindungen gehören zur Deploy-Fläche. Abbildung 5 zeigt den Remap-Pfad im Vergleich zum blinden Pfad.
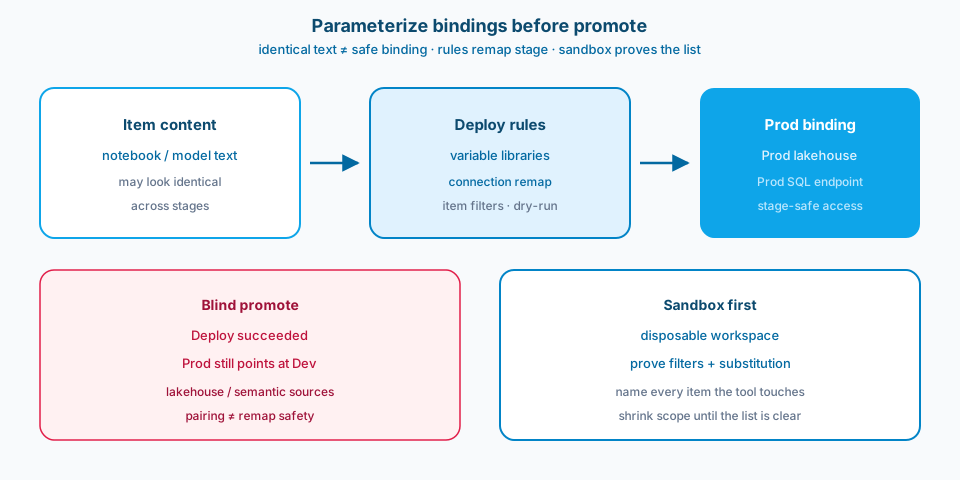
Abbildung 5. Identischer Text ist keine sichere Bindung in Prod. Regeln mappen die Connections um. Der Beweis in der Sandbox benennt jedes Item, das das Tool anfasst, bevor du in eine gemeinsame Stage beförderst.
5. Teste die Pipeline selbst in einer Wegwerf-Sandbox
Richte CI auf einen Workspace, der sich neu aufbauen lässt. Beweise Item-Filter, Variablenersetzung und die Auflösung der Connections, bevor du es produktionsreif nennst. Der erste Fehler sollte nicht in einem gemeinsamen Test-Workspace passieren, der für Demos genutzt wird. Der Beweis in der Sandbox zeigt auch, wie unveränderte Items in den Logs aussehen, wenn das Tool sie trotzdem anfasst. Schreib das ins Runbook.
Was du nicht blind befördern solltest
- Connection-Objekte und Gateway-Bindungen, in denen die Umgebung steckt.
- Semantische Modelle, ohne die Deployment-Regeln für das Remapping der Datenquellen zu prüfen.
- Lakehouse- oder Warehouse-Items, wenn das Ziel bereits abweichende Daten enthält, die du nicht über Deployment-Tools abgleichen wolltest.
- Workspace-Identitäten und Zugriffszuweisungen, die stagespezifisch sind.
- Ad-hoc-Notebooks mit persönlichen Standardwerten, die noch aus einem Spike fest eincodiert sind.
- Alles, was dein Dry Run nicht in einer Änderungsliste benennen kann, die deine Leute verstehen.
Wenn das Tool dir die Item-Liste nicht sauber zeigen kann, halte an und verkleinere den Umfang, bis es das kann.
Abbildung 6 zeigt die Learn-Darstellung gepaarter Items über die Pipeline-Stages hinweg. Die Paarung ist notwendig. Ohne Remap-Regeln reicht sie nicht aus.
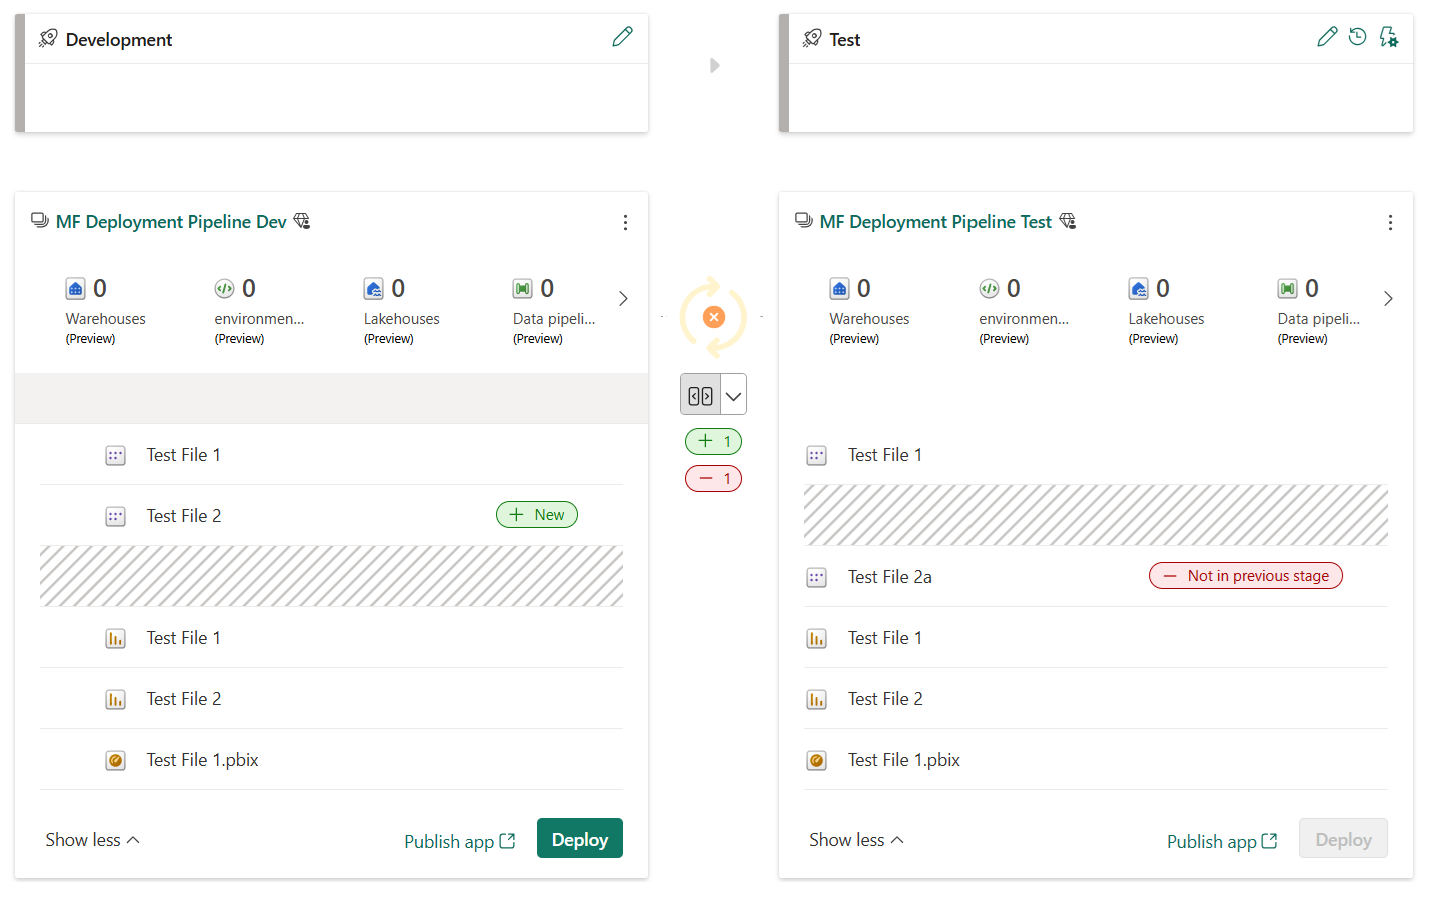
Abbildung 6. Gepaarte Items über die Pipeline-Stages hinweg. Die Identität der Paarung gehört zum Vertrag; Remap-Regeln entscheiden trotzdem, was sich pro Stage unterscheidet. Quelle: Microsoft Learn: deployment pipelines.
Häufige Fehler
Eine Umbenennung wird behandelt wie ein neuer Workspace. Die Konfiguration hängt noch am alten String. Deployments legen Ziele neu an oder verfehlen sie.
Lokale Deploy-Skripte weichen von den fabric-cicd-Pfaden auf dem Server ab. Der Laptop deployt eine Teilmenge. Der Server deployt den Graph.
Die Pipeline startet bei Rauschen im Ordner. Änderungen an der Dokumentation oder an gemeinsamen Utilities veröffentlichen fachliche Jobs neu, die nichts mit dem tatsächlich geänderten Item zu tun haben.
Kein Beweis in der Sandbox. Der erste echte Fehler passiert in einer gemeinsamen Stage, während die Fachanwender zuschauen.
Blinde Promotion von semantischen Modellen. Parameter und Datenquellen zeigen nach einem erfolgreichen Lauf in Prod immer noch auf Dev.
Annehmen, dass Paarung gleich Sicherheit ist. Auch gepaarte Items brauchen Regeln dafür, was sich pro Stage unterscheidet.
So übernehmen oder anpassen
So übernehmen
- Die Quelle der Wahrheit (Git oder Pipeline-UI) und welcher Deployer maßgeblich ist.
- Was einen Lauf auslöst, einschließlich Pfadfiltern und der Frage, ob reine Dokumentationsänderungen ignoriert werden.
- Eine Zuordnung der IDs von Workspace, Lakehouse und Connections über die Stages.
- Item-Typen, die bei der Promotion ausgeschlossen oder gesondert parametrisiert werden.
- Prüfschritte in der Sandbox vor den gemeinsamen Stages Test oder Prod.
- Das erwartete Verhalten, wenn das Tool unveränderte Items neu veröffentlicht, mit Freigabe durch den Verantwortlichen.
Vor dem Einsatz anpassen
Ein kleinerer Blast Radius bedeutet meist mehr Arbeit beim Paketieren: engere Ordner, klarere Zuständigkeiten, mehr Parametrisierung, manchmal mehr Pipelines. Dieser Aufwand kauft dir vorhersehbare Promotions. Aggressives Filtern kann abhängige Items zurücklassen und halb aktualisierte Workspaces erzeugen. Deployer, die auf Konsistenz ausgelegt sind, haben ihren Grund. Wäge die Ästhetik minimaler Diffs gegen "die Stage muss als Ganzes Sinn ergeben" ab und schreib diese Abwägung auf. Disziplin in der Sandbox verzögert den ersten grünen CI-Build. Es ist trotzdem billiger, als erklären zu müssen, warum an einem Freitagnachmittag die Notebooks in Prod überschrieben wurden.
Wichtigste Quellen: Intro to deployment pipelines sowie die Dokumentation zu Fabric CI/CD und fabric-cicd auf Microsoft Learn zur Paarung von Items und zu Deployment-Regeln.
CI/CD für Analytics-Plattformen ist eine Operation am Workspace. Plane die Größe des Schnitts.
Verwandte Notizen
- Fabric Lineage: Wie geht es weiter, wenn die Pipeline-Lineage nicht mehr nachvollziehbar ist? (die Lineage sehen, bevor du änderst, was ein Deployment anfasst)