

Das Wichtigste in Kürze
- Dokumentiere Build, Refresh oder Framing des Modells und den Speichermodus als drei Hebel mit Verantwortlichen.
- Orchestriere die Transformationen im Lake und stoß den Refresh nur an, wenn sich etwas geändert hat, von dem das Modell abhängt.
- Nimm für große Fakten lieber Direct Lake, wenn das Delta-Layout passt. Meide den bequemen Umweg über den SQL endpoint.
- Nimm den MLV-Refresh in den DAG auf. Teilweise Aktualität ist schlimmer als ehrlich veraltete Daten.
- Nutze für unbeaufsichtigte Refreshes von Direct Lake und Import eine feste Identität.
- Halte für Import und Lake-Builds eine Richtlinie für inkrementelle Läufe oder für das Überspringen ohne Änderungen fest.
Frische Gold-Tabellen bringen nichts, wenn das semantic model noch auf gestern zeigt oder der Refresh eine Stunde für einen Fakt verbrennt, den du inkrementell hättest laden können. Refresh ist ein Architekturproblem: Orchestrierung, Identität und Speichermodus. Wer ihn als Häkchen im Portal behandelt, erfindet einen zweiten Prozess, den niemand erklären kann.
Kuratierte Tabellen bauen, das semantic model aktualisieren und festlegen, wie das Modell Daten liest, sind drei verschiedene Hebel. Einen davon zu reparieren repariert nicht die anderen. Wer sie vermischt, bekommt langsame Fakten, überraschende Fallbacks und nächtliche Jobs, die erfolgreich laufen, während die Berichte veraltet bleiben.
Benanntes Modell: drei Hebel
- Kuratierte Tabellen bauen: Notebooks, Pipelines, Spark-Jobs und Materialized Lake Views schreiben oder pflegen Delta.
- Modell aktualisieren oder framen: per Zeitplan, auf Abruf oder als Trigger nach der Pipeline. Import lädt weiterhin neu, Direct Lake macht oft nur ein Framing.
- Wie das Modell liest: Import, DirectQuery, Direct Lake oder Views auf dem SQL endpoint. Das entscheidet, wie teuer Hebel (2) wird.
- Vertrag: Ein grünes Notebook ist kein frisches semantic model. Dokumentiere alle drei Hebel, sonst debuggst du unter Druck die falsche Schicht.
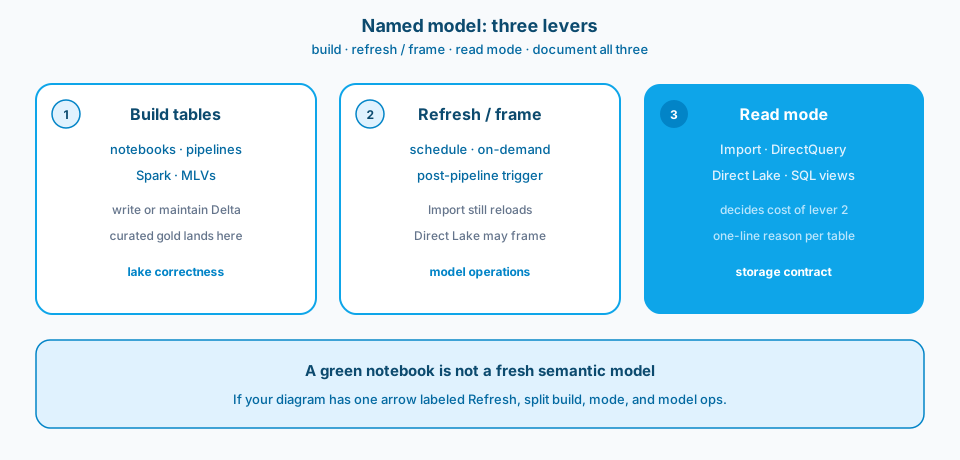
Abbildung 1. Build, Refresh oder Framing und Lesemodus sind drei Hebel. Einen davon zu reparieren repariert nicht die anderen. Wenn dein Diagramm einen einzigen Pfeil mit der Beschriftung Refresh hat, teile die Verantwortung auf.
Kontext und Rahmenbedingung
Ein häufiger Fehler in Lakehouse-Stacks auf Fabric: Bronze und Silver sehen gesund aus, während die Berichte noch die Geschichte von gestern Nacht erzählen. Die Transformationen sind in Ordnung. Der Vertrag für den semantischen Refresh ist es nicht.
Direct Lake verändert das Gespräch über Aktualität. Wenn das Modell Delta in OneLake ohne klassische Import-Kopie liest, bedeutet Refresh nicht mehr "jede Zeile neu in VertiPaq laden". Es bedeutet: Der Lake ist korrekt, das Framing ist aktuell und die Identität der Verbindung kann die Dateien sehen. Import und hybride Formen brauchen weiterhin einen geplanten oder ausgelösten Refresh des Modells. Wer die Prüfungen von Framing, MLVs und Verbindungsrichtlinie auslässt, wiegt sich in falscher Sicherheit.
Abbildung 2 ist die Darstellung auf Learn für Direct Lake: Das semantic model verbindet sich mit Delta in OneLake, statt von jedem schweren Fakt eine vollständige Import-Kopie mitzuschleppen.
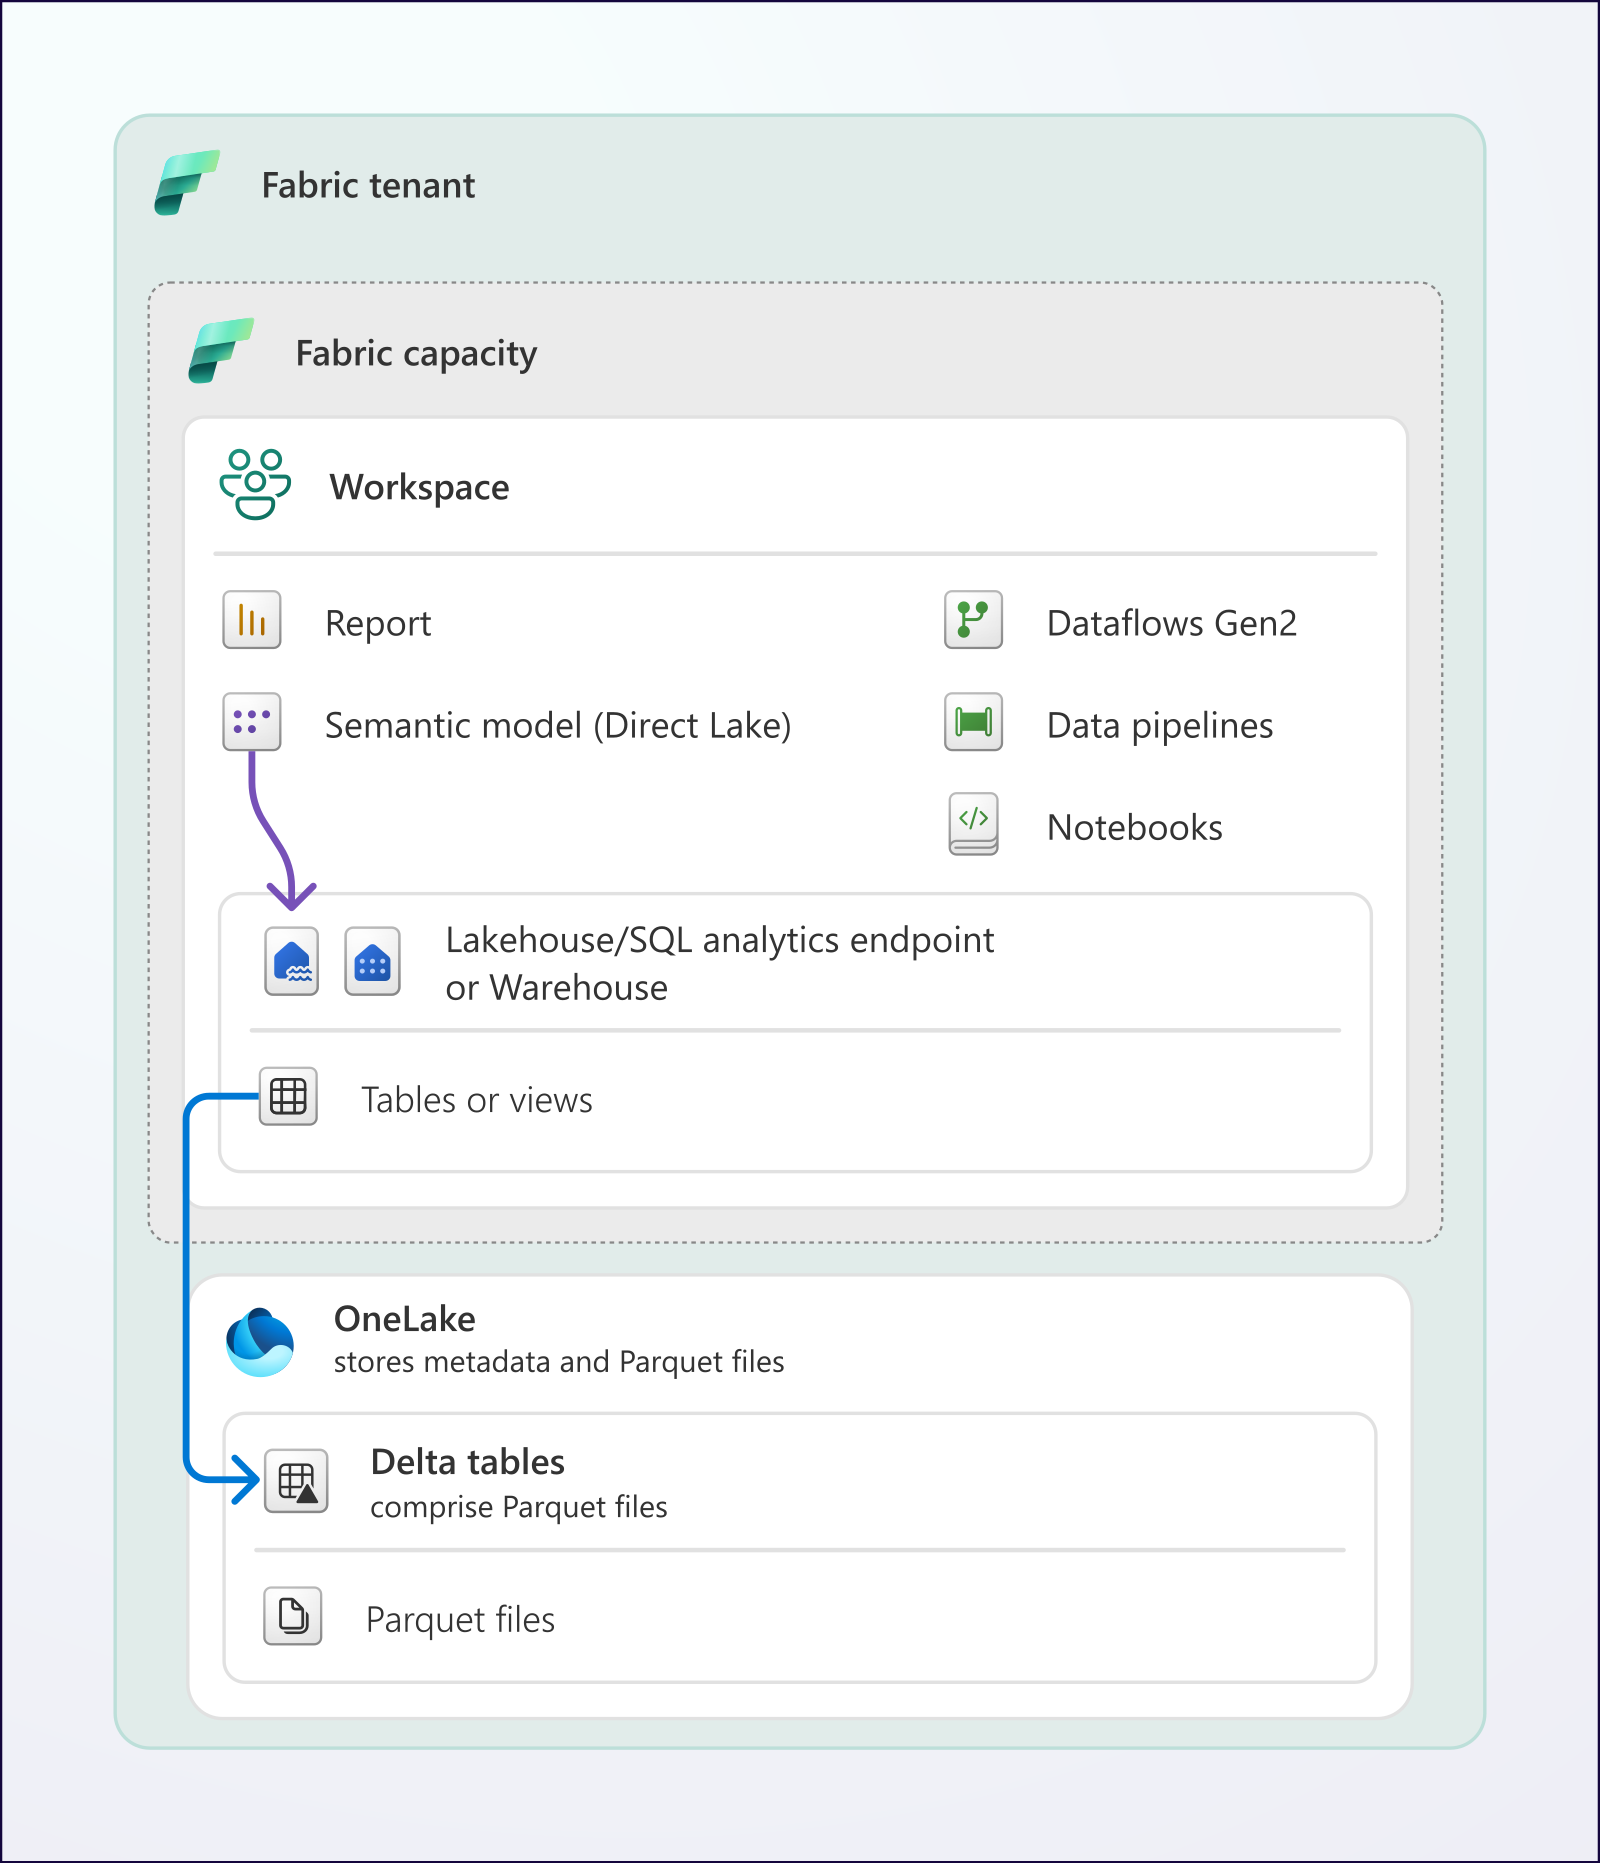
Abbildung 2. Direct Lake verbindet das semantic model mit Delta in OneLake. Aktualität wird zu einer Frage von korrektem Lake, Framing und Identität, nicht von einem Neuladen jeder Zeile in VertiPaq. Quelle: Microsoft Learn: Direct Lake overview.
Design
1. Erst den Build orchestrieren, dann den Refresh
Pipelines sollten die Transformationen im Lakehouse abschließen, die Ergebnisse prüfen, wenn dir Parität wichtig ist, und den Refresh des Modells nur anstoßen, wenn sich etwas geändert hat, von dem das Modell abhängt. Ein blinder nächtlicher Voll-Refresh ist ein Standardwert, kein Design. Für Import-Tabellen zählt dieser Trigger weiterhin. Für schwere Fakten in Direct Lake landest du korrektes Delta und stößt bei Bedarf das Framing an, statt die Historie neu zu laden. Wenn sich Gold nicht bewegt hat, verbrenn keine Kapazität, um so zu tun, als ob. Abbildung 3 zeigt diese Reihenfolge der Verantwortung.
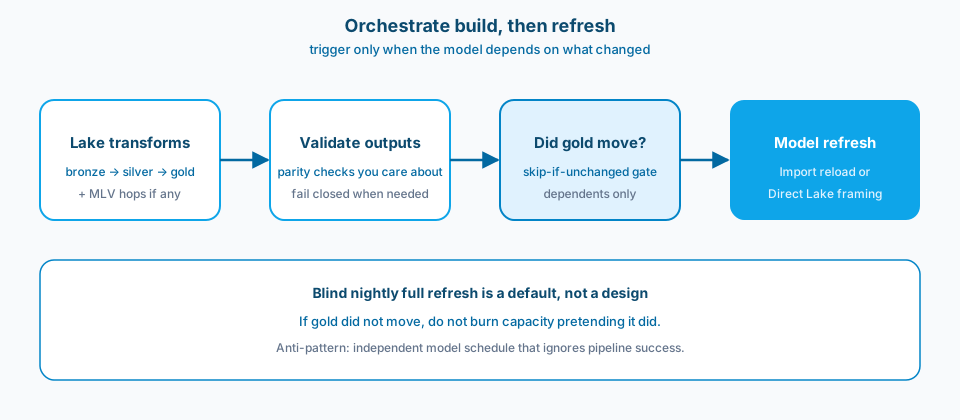
Abbildung 3. Schließ die Transformationen ab, prüfe, wenn es darauf ankommt, und aktualisiere nur, wenn sich Abhängigkeiten geändert haben. Unabhängige Zeitpläne für das Modell, die den Erfolg der Pipeline ignorieren, erzeugen veraltete oder unvollständige Semantik.
In meiner Demo hält sich demo_refresh_pipeline genau an diese Reihenfolge. Notebook1 baut Gold, validate_gold ist ein Lookup, das die erste Zeile von gold.value_by_segment liest, und if_gold_changed führt die native Aktivität Semantic model refresh auf demo_value_model nur aus, wenn dieser Ausdruck wahr ist:
@greater(int(activity('validate_gold').output.firstRow.total), 0)
Der False-Zweig hat keine Aktivitäten. In einem Lauf auf Abruf waren alle vier Aktivitäten erfolgreich: Notebook1 in 53 Sekunden, validate_gold in 11, if_gold_changed in 24 und der Refresh in 22 (Abbildung 4). Das Gate ist absichtlich einfach: Es prüft, dass Gold eine positive Summe hat, nicht, dass sich Gold geändert hat. Ein echtes Gate zum Überspringen ohne Änderungen vergleicht mit dem, was das Modell zuletzt gesehen hat.
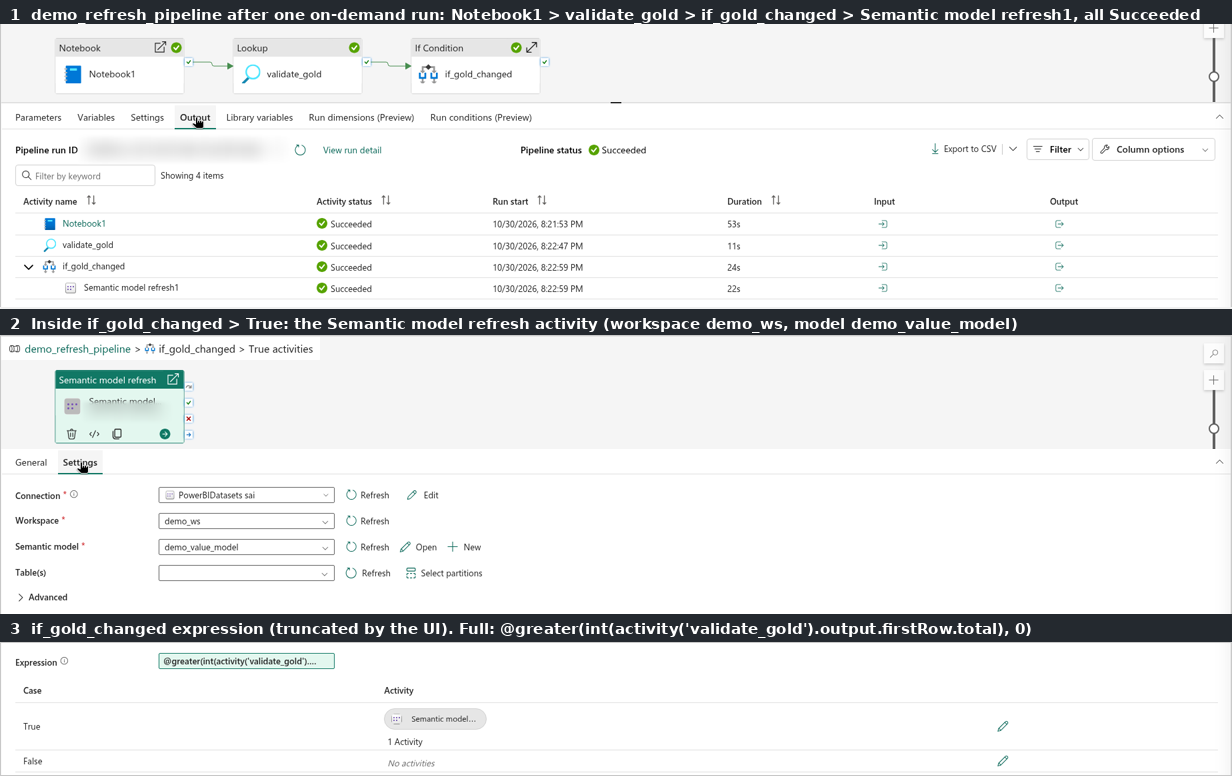
Abbildung 4. Build, Prüfung, dann Refresh, aus einem Demo-Lauf. Drei Streifen aus verschiedenen Ansichten derselben Pipeline: die Ausgabe des Laufs, die Refresh-Aktivität im True-Zweig und das If-Gate. Die Oberfläche schneidet den Ausdruck ab, der vollständige Text steht oben. IDs von Lauf und Modell sind unkenntlich gemacht.
2. Nimm für große Fakten lieber Direct Lake, wenn das Layout passt
Wenn ein schwerer Fakt über eine View auf dem SQL endpoint gelesen wird, weil es im Labor funktioniert hat, frag, ob Direct Lake auf der Delta-Tabelle der vorgesehene Weg ist. Der falsche Modus zeigt sich als langsame Abfragen, seltsames Refresh-Verhalten und Kapazitätsverbrauch, der wie ein DAX-Problem aussieht. Direct Lake will sauberes Delta, sinnvolle Datentypen und ein Modell, das für diesen Modus gebaut ist. Views in SQL vor Direct Lake bringen oft genau die Latenz zurück, vor der du von Import weggegangen bist. Import-Dimensionen mit Fakten in Direct Lake zu mischen kann gewollt sein. Ohne schriftliche Begründung wird es zu Stammeswissen.
3. Behandle Materialized Lake Views als eigene Aktualitätsklasse
MLVs sind keine gewöhnlichen Gold-Tabellen mit hübscherem Namen. Sie haben ihre eigene Geschichte bei Refresh und Abhängigkeiten. Wenn ein semantic model auf eine MLV zeigt oder auf Gold, das von einer MLV abhängt, muss dein Pipeline-DAG diesen Refresh-Pfad enthalten. Wer hofft, dass die View "nur SQL" ist, bekommt korrekte Notebooks und falsche Berichte. Schreib auf, wer die MLV aktualisiert, was fail open und was fail closed ist und ob das Modell einen teilweise aktualisierten Graphen sehen kann. Teilweise Aktualität ist schlimmer als ehrlich veraltete Daten.
Der MLV-Refresh ist ein eigener Lauf mit eigenem Status. In meiner Demo hat ein manueller Lauf Silver in 16 Sekunden und Gold in 5 aktualisiert, 36 Sekunden von Anfang bis Ende (Abbildung 5). Auf diesen Status sollte deine Pipeline warten, bevor sie das Modell anfasst.
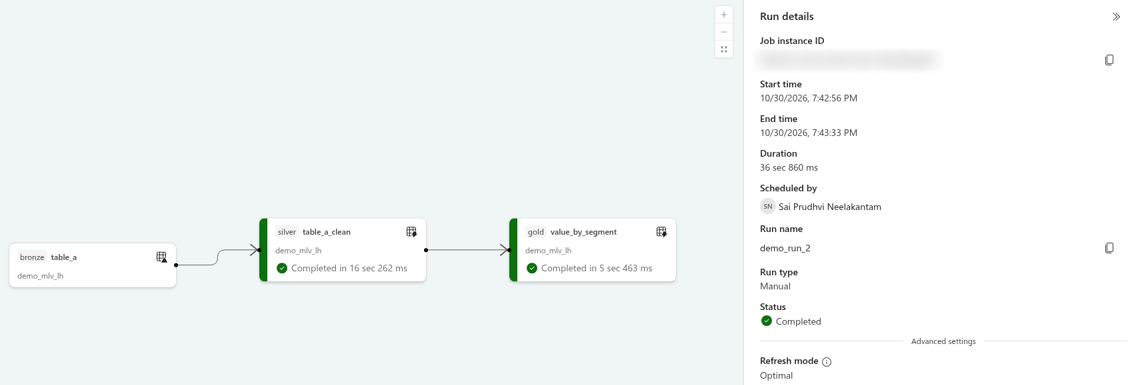
Abbildung 5. Ein MLV-Refresh-Lauf in einem Demo-Lakehouse: bronze.table_a speist silver.table_a_clean, das gold.value_by_segment speist. Fabric zeichnet die Dauer jeder View und den Status des Laufs auf. Diese Kette ist der Refresh-Pfad, den deine Pipeline abschließen muss, bevor das Modell Gold liest.
4. Die Identität für den Refresh muss zur Verbindung passen
Interaktives SSO, das im Browser funktioniert, ist nicht dasselbe wie ein Service Principal oder eine Managed Identity, die nachts aktualisiert. Entwirf die Verbindung so, wie sich die Produktion authentifizieren wird. Die Microsoft-Dokumentation empfiehlt für Cloud-Verbindungen von Direct Lake dringend eine feste Identität. Persönliche Konten scheitern im Urlaub, an Conditional Access oder an MFA. Ordne Workspace-Rollen, Lakehouse-Berechtigungen und die Verbindung des Modells derselben Identität zu. "Es funktioniert, wenn ich auf Refresh klicke" ist kein Nachweis für den Betrieb.
In meiner Demo ist die Cloud-Verbindung des Modells in Direct Lake dem Standard zugeordnet, Single Sign-On (Entra ID), mit "Keep your Direct Lake data up to date" auf On. Wer stattdessen eine Cloud-Verbindung anlegt, bekommt unter den Authentifizierungsmethoden Service Principal und Workspace identity angeboten. Beide geben dem Refresh eine feste Identität statt der Person, die gerade angemeldet ist. Ich habe in der Demo keine gebunden, deshalb läuft er weiterhin als SSO (Abbildung 6).
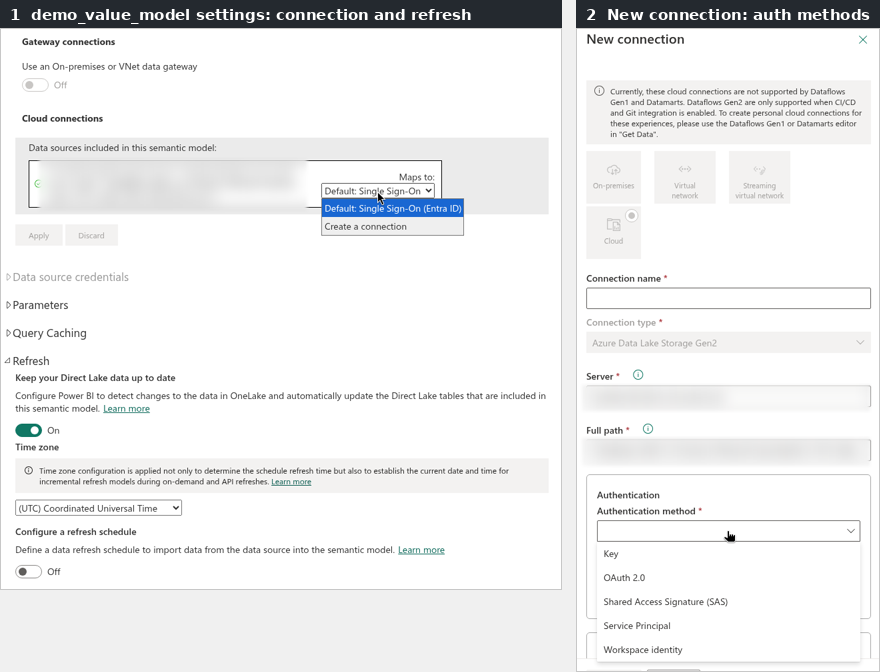
Abbildung 6. Die Identitätsoptionen für die Cloud-Verbindung eines Modells in Direct Lake. Links das Demo-Modell im aktuellen Zustand: Standard-SSO, automatische Updates für Direct Lake auf On. Rechts die Authentifizierungsmethoden, die eine neue Verbindung anbietet, darunter Service Principal und Workspace identity. In der Demo wurde keine feste Identität gebunden. Pfade der Datenquellen und Hostnamen sind unkenntlich gemacht.
Abbildung 7 zeigt die Aufteilung der Verantwortung.
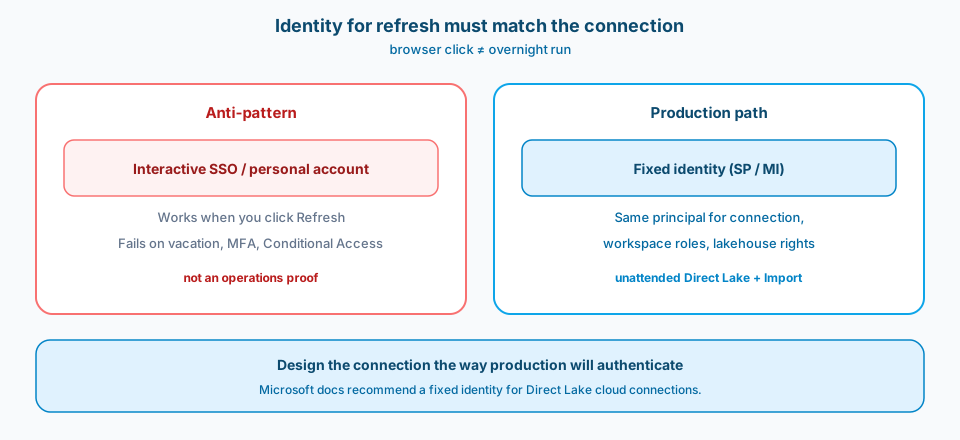
Abbildung 7. Erfolg per Klick im Browser ist kein Nachweis für die Nacht. Nutze für unbeaufsichtigte Läufe von Direct Lake und Import eine feste Identität mit denselben Rechten auf Workspace und Lakehouse.
5. Wisse, wann der klassische Refresh noch zählt
Direct Lake schafft den Bedarf an einer Refresh-Architektur nicht ab. Import-Tabellen brauchen sie weiterhin. Zusammengesetzte Modelle brauchen weiterhin eine klare Geschichte pro Tabelle. Framing und Metadatenoperationen gehören weiterhin ins Runbook. Berechnete Tabellen und hybride Muster können Ladearbeit zurückbringen, selbst wenn der große Fakt in Direct Lake liegt. Bleib bei Import inkrementell diszipliniert: Ein riesiger Fakt, der bei jedem Lauf vollständig materialisiert wird, übernimmt irgendwann deinen Kapazitätskalender.
Abbildung 8 ist die Darstellung auf Learn für das Lakehouse als analytische Oberfläche. Das Modell muss trotzdem ehrlich sein, wie es diese Oberfläche liest.
Abbildung 8. Das Lakehouse ist die analytische Oberfläche. Bau den Lake und sorg dann dafür, dass das Modell ehrlich ist, wie es ihn liest. Quelle: Microsoft Learn: lakehouse overview.
Häufige Fehler
Pipeline grün, Modell veraltet. Die Transformationen sind fertig, aber niemand hat den Schritt für Modell oder Framing angestoßen.
Unabhängige Zeitpläne. Der Refresh des Modells ignoriert den Erfolg der Pipeline. Du aktualisierst also unvollständiges Gold oder lässt den Lauf aus, wenn Daten spät ankommen.
Der bequeme Umweg über den SQL endpoint. Schwere Fakten bleiben auf Views, weil das Prototyping einfach war. Die Produktion zahlt mit Abfragezeit und verwirrten Erwartungen an Direct Lake.
MLV im DAG ignoriert. Die Definition existiert, die Verantwortung für den Refresh nicht. Gold und Semantik flussabwärts driften in ruhigen Nächten ab.
Interaktive Identität für unbeaufsichtigte Arbeit. Funktioniert in der Sitzung der Autorin oder des Autors. Scheitert nachts über einen anderen Authentifizierungsweg.
Gemischte Modi ohne Legende. Niemand kann sagen, warum die Dimension Import und der Fakt Direct Lake ist, also rät die nächste Änderung.
So übernehmen oder anpassen
So übernehmen
- Was Tabellen baut und was Modelle aktualisiert oder framt, mit Verantwortlichen.
- Speichermodus pro Tabelle oder Modell mit einer Begründung in einer Zeile.
- Die Identität für unbeaufsichtigte Refreshes von Direct Lake und Import.
- Richtlinie für inkrementelle Läufe oder das Überspringen ohne Änderungen für Import und Lake-Builds.
- Wo in der Pipeline der Refresh von MLVs und davon abhängigem Gold sitzt.
- Alarmierung, wenn die Pipeline erfolgreich ist, die Prüfungen der semantischen Aktualität aber fehlschlagen.
Vor dem Einsatz anpassen
Engere Orchestrierung heißt mehr Arbeit beim Schreiben von Pipelines und mehr Alarme. Du verhandelst mit den Verantwortlichen der Kapazität darüber, CU für einen vollständigen Import-Refresh zu verbrennen statt für das Framing in Direct Lake. Direct Lake verringert den Schmerz des klassischen Refresh bei großen Fakten, legt aber die Messlatte bei Delta-Hygiene, Berechtigungen und Modelldesign höher. MLVs bringen Eleganz und Abhängigkeitsschulden: Jeder materialisierte Schritt braucht eine verantwortliche Person im DAG, sonst wird Aktualität zur Folklore.
Probier es selbst aus
Die MLV-Demo zur Dateiaufnahme in meinem öffentlichen Repo tech-demos baut in einem Lakehouse eine Kette aus Materialized Lake Views von Dateien über Bronze und Silver bis Gold. So kannst du selbst einen Refresh ausführen und die Lineage und den Status pro View beobachten.
Wichtigste Quellen: Direct Lake overview, Lakehouse overview und Microsoft Learn zum Refresh von semantic models und zu Verbindungen von Direct Lake.
Bau den Lake. Sorg dafür, dass das Modell ehrlich ist, wie es diesen Lake liest. Beweise, dass die nächtliche Identität beides kann, ohne dass du zusiehst. Wenn dein Diagramm einen einzigen Pfeil mit der Beschriftung Refresh hat, verteile Build, Modus und Modelloperationen auf Verantwortliche.
Verwandte Notizen
- Direct Lake on OneLake: Lohnt sich der Aufwand? (Direct Lake on OneLake, wenn die Plattform Rückschritte macht)
- Fabric Monitor: Refresh-Fehler systematisch überwachen (Refresh-Fehler mit einem einzigen Runbook überwachen)
- Große Fakten: Warum driftet ein grüner Refresh trotzdem? (inkrementelle Verträge hinter einem grünen Refresh)