

Puntos clave
- Documenta el build, el refresh o framing del modelo y el modo de almacenamiento como tres palancas con responsables.
- Orquesta las transformaciones del lake y lanza el refresh solo cuando haya cambiado algo de lo que depende el modelo.
- Prefiere Direct Lake para hechos grandes cuando el layout de Delta encaja; evita el atajo cómodo del SQL endpoint.
- Mete el refresh de las MLV en el DAG; una frescura parcial es peor que unos datos antiguos pero honestos.
- Usa una identidad fija para los refresh desatendidos de Direct Lake e Import.
- Mantén una política incremental o de saltar si no hay cambios para Import y para los builds del lake.
Unas tablas gold recién actualizadas no sirven de nada si el semantic model sigue apuntando a ayer, o si el refresh quema una hora en un hecho que podrías haber cargado de forma incremental. El refresh es un problema de arquitectura: orquestación, identidad y modo de almacenamiento. Trátalo como una casilla del portal y acabarás inventando un segundo proceso que nadie sabe explicar.
Construir tablas curadas, refrescar el semantic model y elegir cómo lee los datos el modelo son tres palancas distintas. Arreglar una no arregla las demás. Mezclarlas produce hechos lentos, fallbacks inesperados y jobs nocturnos que terminan bien mientras los informes siguen desactualizados.
Modelo con nombre: tres palancas
- Construir tablas curadas: notebooks, pipelines, jobs de Spark y materialized lake views escriben o mantienen Delta.
- Refrescar o hacer framing del modelo: programado, bajo demanda o lanzado al terminar el pipeline. Import sigue recargando; Direct Lake a menudo solo hace framing.
- Cómo lee el modelo: Import, DirectQuery, Direct Lake o vistas sobre el SQL endpoint. Esto decide lo cara que sale la palanca (2).
- Contrato: un notebook en verde no es un semantic model actualizado. Documenta las tres palancas o acabarás depurando la capa equivocada bajo presión.
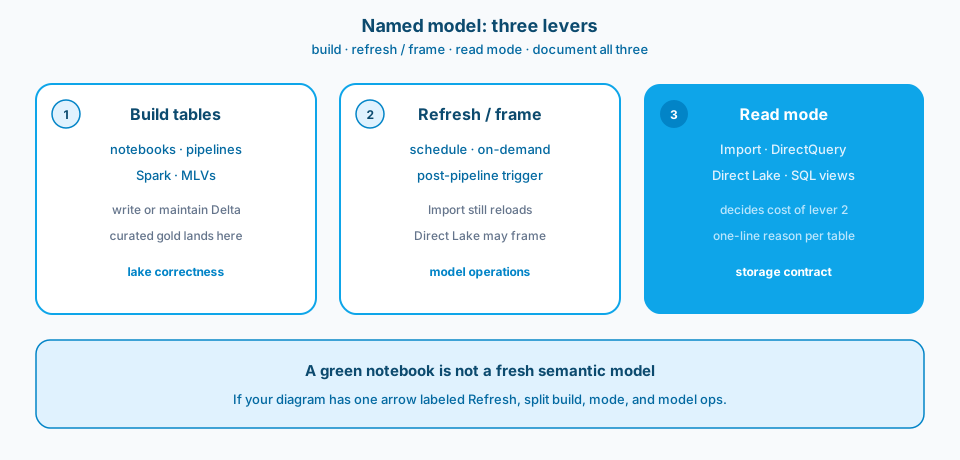
Figura 1. El build, el refresh o framing y el modo de lectura son tres palancas. Arreglar una no arregla las demás. Si tu diagrama tiene una sola flecha con la etiqueta Refresh, reparte la responsabilidad.
Contexto y restricción
Un fallo habitual en los stacks de lakehouse sobre Fabric: bronze y silver parecen sanos mientras los informes siguen contando la historia de anoche. Las transformaciones están bien. El contrato del refresh semántico no.
Direct Lake cambia la conversación sobre la frescura. Cuando el modelo lee Delta en OneLake sin una copia clásica en Import, refrescar deja de significar "volver a cargar cada fila en VertiPaq". Significa que el lake es correcto, que el framing está al día y que la identidad de la conexión puede ver los archivos. Import y las formas híbridas siguen necesitando un refresh del modelo programado o lanzado por un evento. Saltarse las comprobaciones de framing, MLV y política de conexión da una falsa sensación de seguridad.
La figura 2 es el planteamiento de Learn para Direct Lake: el semantic model se conecta a Delta en OneLake en lugar de llevar una copia completa en Import de cada hecho pesado.
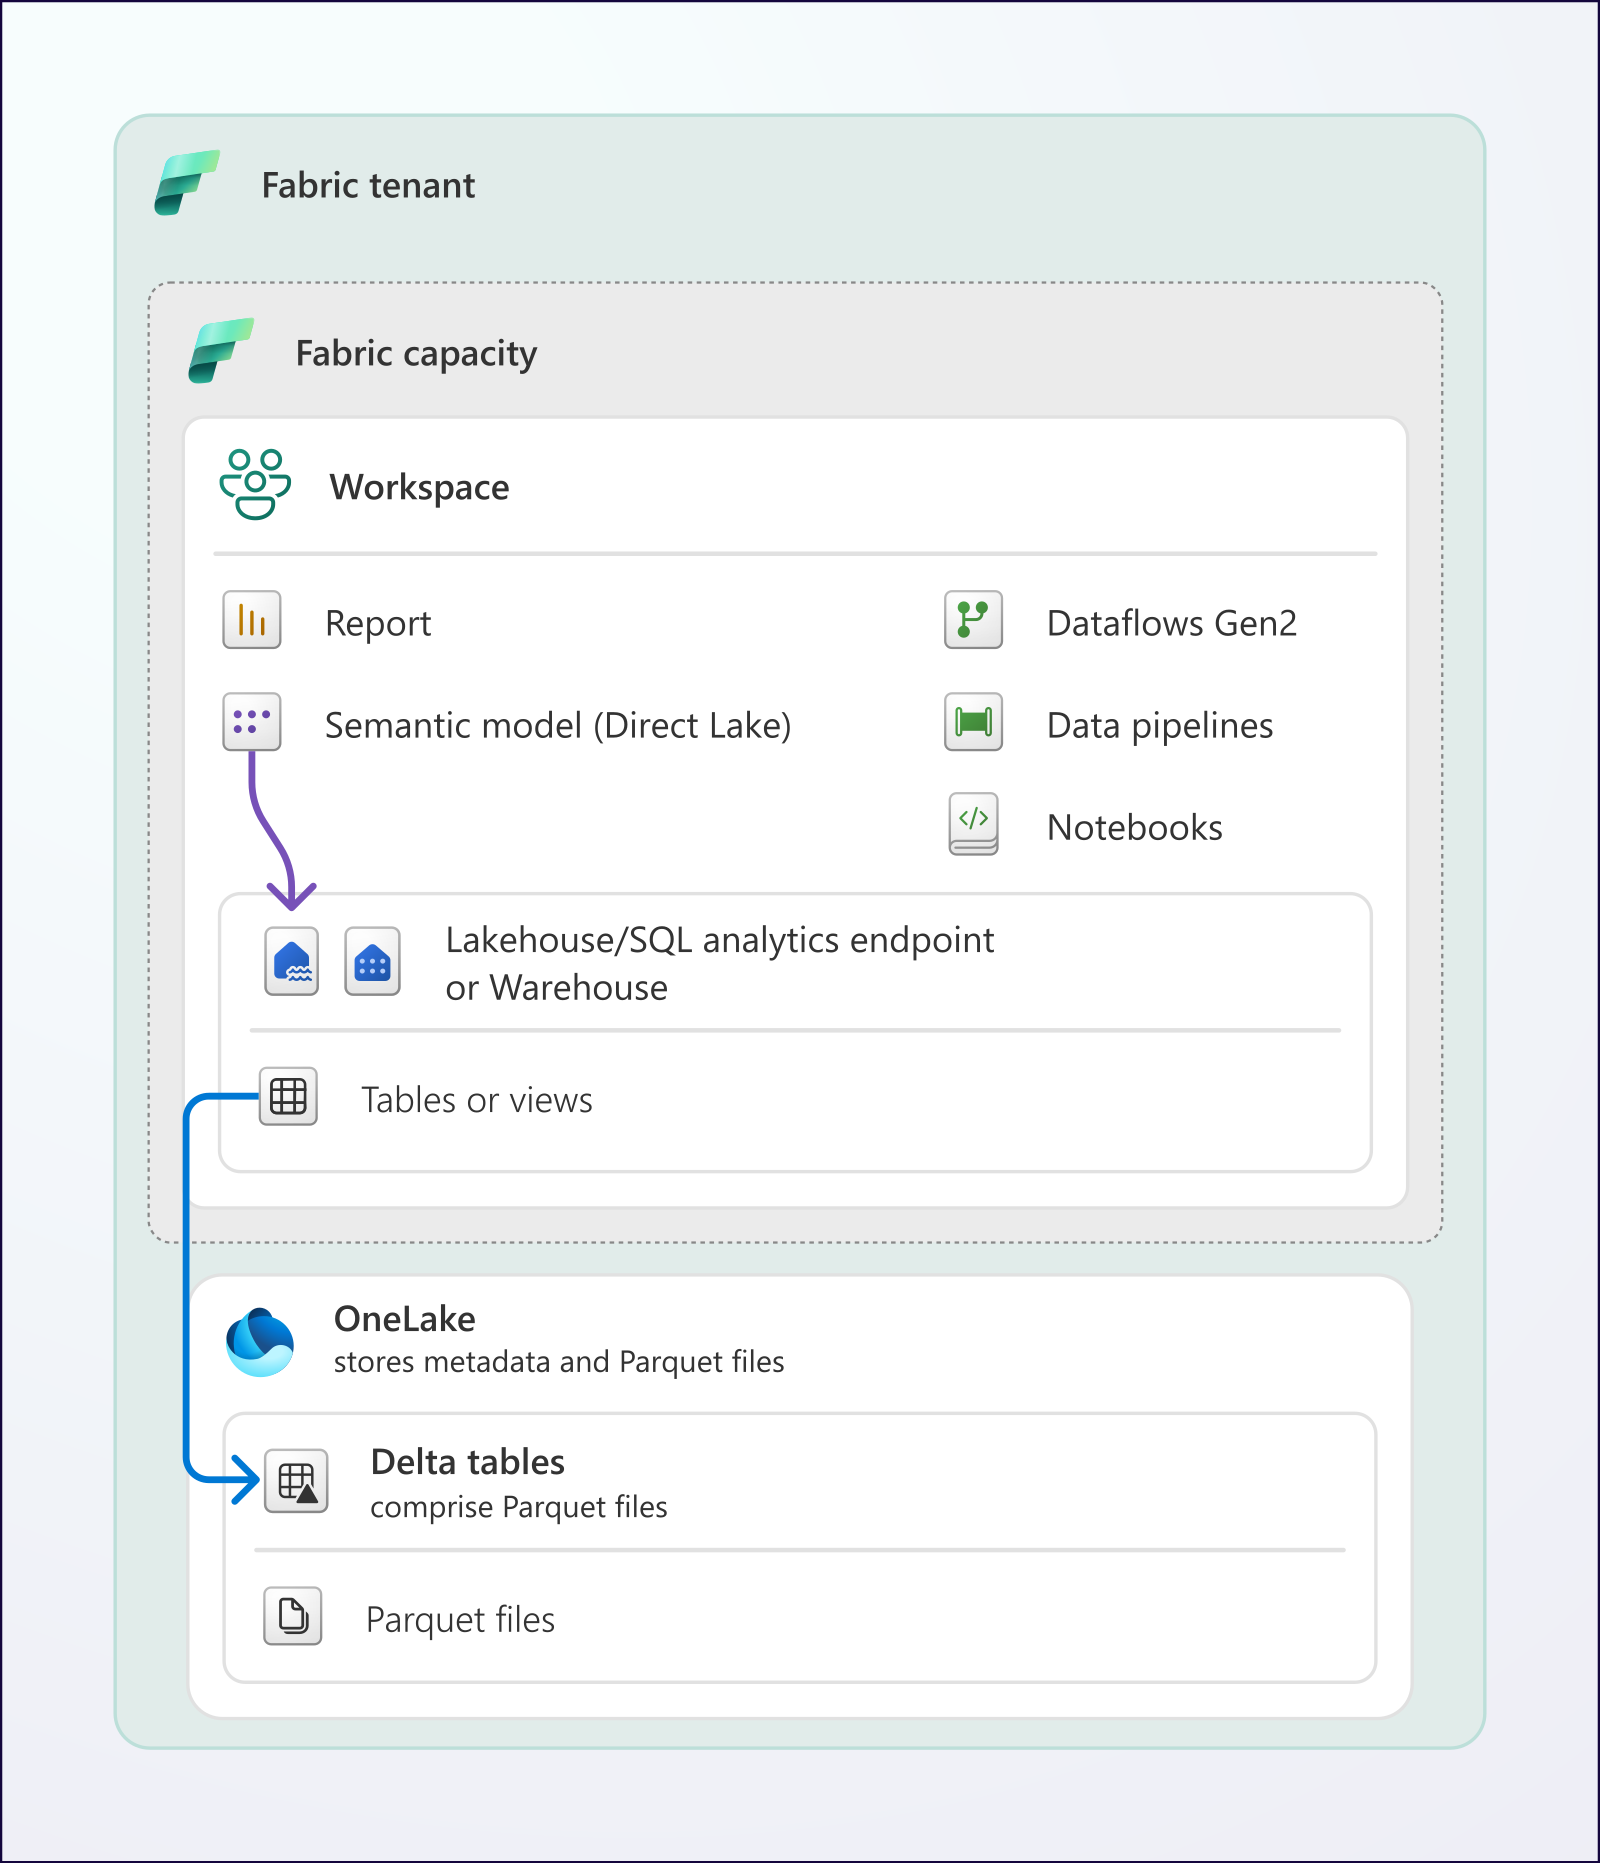
Figura 2. Direct Lake conecta el semantic model a Delta en OneLake. La frescura pasa a depender de que el lake sea correcto, del framing y de la identidad, no de recargar cada fila en VertiPaq. Fuente: Microsoft Learn: Direct Lake overview.
Diseño
1. Orquesta el build y luego el refresh
Los pipelines deberían terminar las transformaciones del lakehouse, validar los resultados cuando te importa la paridad y lanzar el refresh del modelo solo cuando haya cambiado algo de lo que depende. Un refresh completo cada noche a ciegas es un valor por defecto, no un diseño. Para las tablas en Import, ese disparador sigue importando. Para los hechos pesados en Direct Lake, deja un Delta correcto y, si hace falta, da un empujón al framing en lugar de recargar el histórico. Si gold no se ha movido, no quemes capacidad fingiendo que sí. La figura 3 es ese orden de responsabilidades.
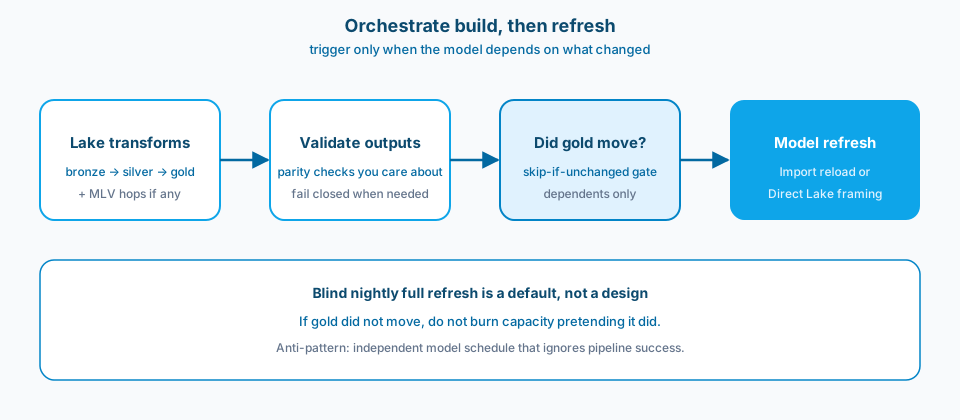
Figura 3. Termina las transformaciones, valida cuando importa y refresca solo si han cambiado las dependencias. Las programaciones independientes del modelo que ignoran si el pipeline terminó bien acaban generando una semántica desactualizada o incompleta.
En mi demo, demo_refresh_pipeline sigue exactamente ese orden. Notebook1 construye gold, validate_gold es un Lookup que lee la primera fila de gold.value_by_segment, e if_gold_changed ejecuta la actividad nativa Semantic model refresh sobre demo_value_model solo cuando esta expresión es verdadera:
@greater(int(activity('validate_gold').output.firstRow.total), 0)
La rama False no tiene actividades. En una ejecución bajo demanda, las cuatro actividades terminaron bien: Notebook1 en 53 segundos, validate_gold en 11, if_gold_changed en 24 y el refresh en 22 (figura 4). El control es simple a propósito: comprueba que gold tiene un total positivo, no que haya cambiado. Un control real de saltar si no hay cambios compara con lo que vio el modelo la última vez.
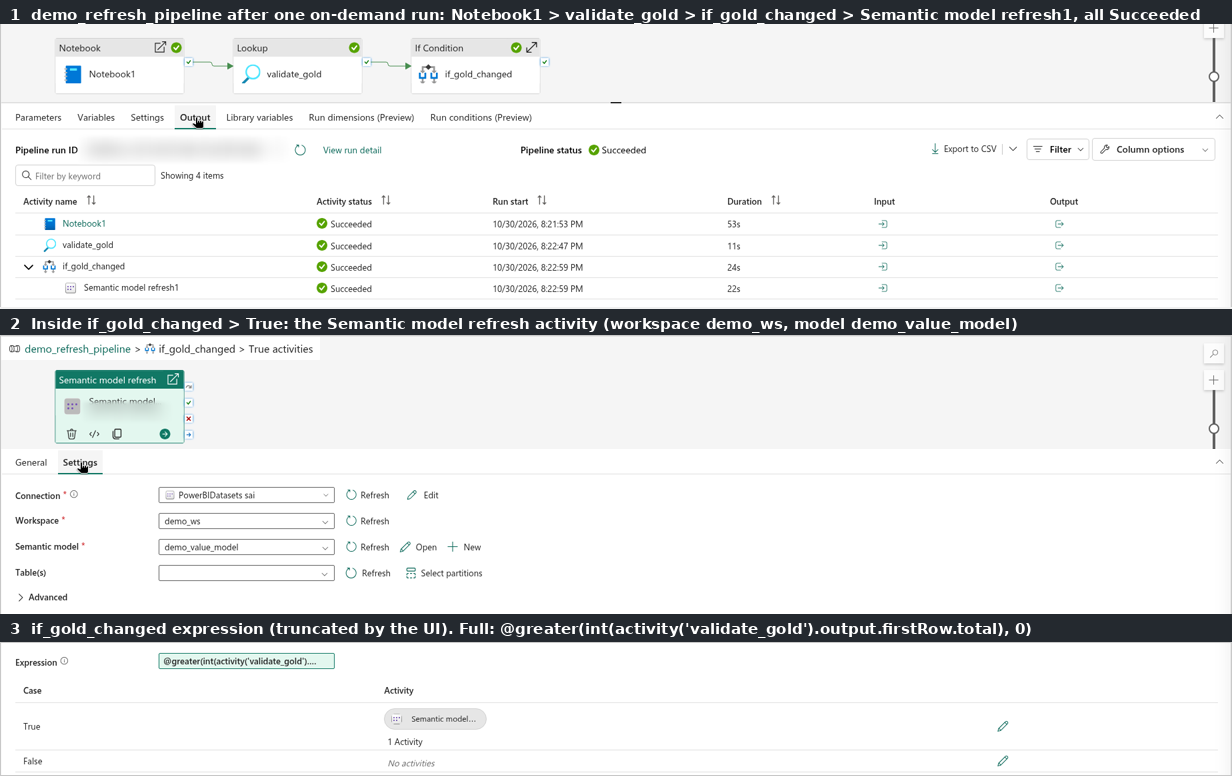
Figura 4. Build, validación y luego refresh, en una ejecución de demo. Tres franjas de pantallas distintas del mismo pipeline: la salida de la ejecución, la actividad de refresh dentro de la rama True y el control If. La interfaz corta la expresión; el texto completo está arriba. Los ID de la ejecución y del modelo están difuminados.
2. Prefiere Direct Lake para hechos grandes cuando el layout encaja
Si un hecho pesado se lee a través de una vista del SQL endpoint porque funcionó en el laboratorio, pregúntate si Direct Lake sobre la tabla Delta es el camino previsto. El modo equivocado se nota en consultas lentas, un comportamiento raro del refresh y un consumo de capacidad que parece un problema de DAX. Direct Lake quiere un Delta limpio, tipos razonables y un modelo pensado para ese modo. Las vistas SQL delante de Direct Lake suelen reintroducir la latencia de la que querías escapar al dejar Import. Mezclar dimensiones en Import con hechos en Direct Lake puede ser intencionado; sin una razón por escrito se convierte en conocimiento tribal.
3. Trata las Materialized Lake Views como una clase de frescura propia
Las MLV no son tablas gold normales con un nombre más bonito. Tienen su propia historia de refresh y de dependencias. Si un semantic model apunta a una MLV, o a gold que depende de una, el DAG de tu pipeline tiene que incluir ese camino de refresh. Confiar en que la vista "es solo SQL" da notebooks correctos e informes equivocados. Escribe quién refresca la MLV, qué hace fail open y qué hace fail closed, y si el modelo puede ver un grafo actualizado a medias. Una frescura parcial es peor que unos datos antiguos pero honestos.
El refresh de las MLV es una ejecución propia con su propio estado. En mi demo, una ejecución manual refrescó silver en 16 segundos y gold en 5, 36 segundos de principio a fin (figura 5). Ese estado es lo que tu pipeline debería esperar antes de tocar el modelo.
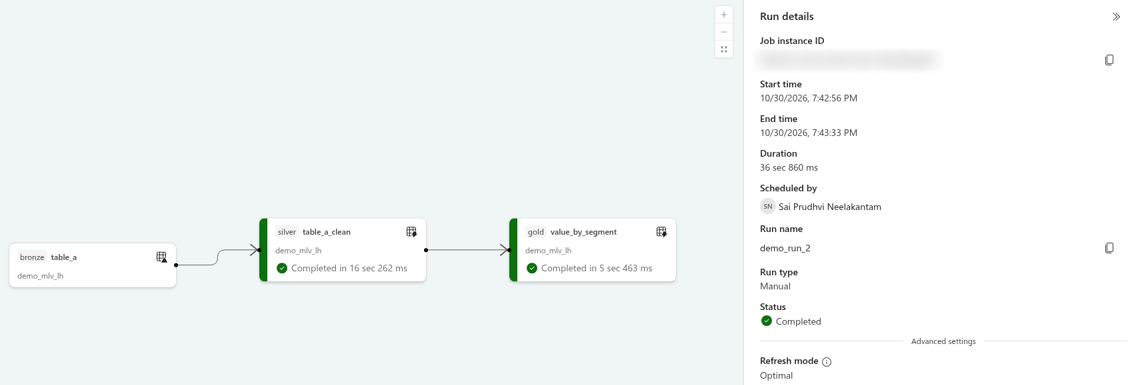
Figura 5. Una ejecución de refresh de MLV en un lakehouse de demo: bronze.table_a alimenta silver.table_a_clean, que alimenta gold.value_by_segment. Fabric registra la duración de cada vista y el estado de la ejecución. Esa cadena es el camino de refresh que tu pipeline tiene que terminar antes de que el modelo lea gold.
4. La identidad del refresh tiene que coincidir con la conexión
Un SSO interactivo que funciona en el navegador no es lo mismo que un service principal o una managed identity refrescando de madrugada. Diseña la conexión tal como se autenticará producción. La documentación de Microsoft recomienda encarecidamente una identidad fija para las conexiones en la nube de Direct Lake. Las cuentas personales fallan en vacaciones, con Conditional Access o con MFA. Asigna los roles del workspace, los permisos del lakehouse y la conexión del modelo a esa misma identidad. "Funciona cuando hago clic en Refresh" no es una prueba operativa.
En mi demo, la conexión en la nube del modelo en Direct Lake está asignada al valor por defecto, Single Sign-On (Entra ID), con "Keep your Direct Lake data up to date" en On. Si en su lugar creas una conexión en la nube, entre los métodos de autenticación aparecen Service Principal y Workspace identity. Cualquiera de los dos da al refresh una identidad fija en lugar de la de quien tenga la sesión iniciada. En la demo no vinculé ninguna, así que sigue ejecutándose con SSO (figura 6).
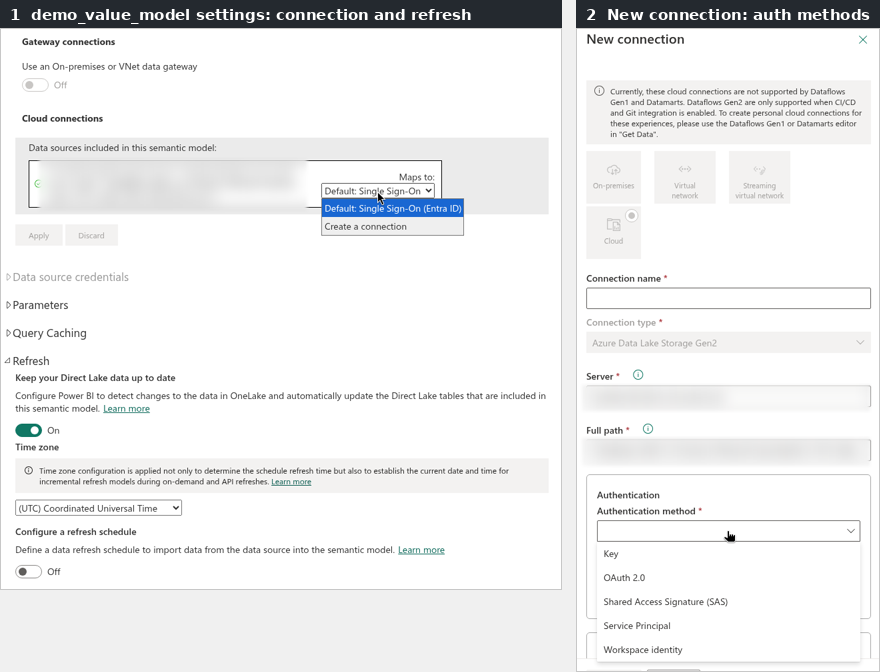
Figura 6. Las opciones de identidad para la conexión en la nube de un modelo en Direct Lake. A la izquierda, el modelo de demo tal como está: SSO por defecto y actualizaciones automáticas de Direct Lake en On. A la derecha, los métodos de autenticación que ofrece una conexión nueva, incluidos Service Principal y Workspace identity. En la demo no se vinculó ninguna identidad fija; las rutas de los orígenes de datos y los nombres de host están difuminados.
La figura 7 es el reparto de responsabilidades.
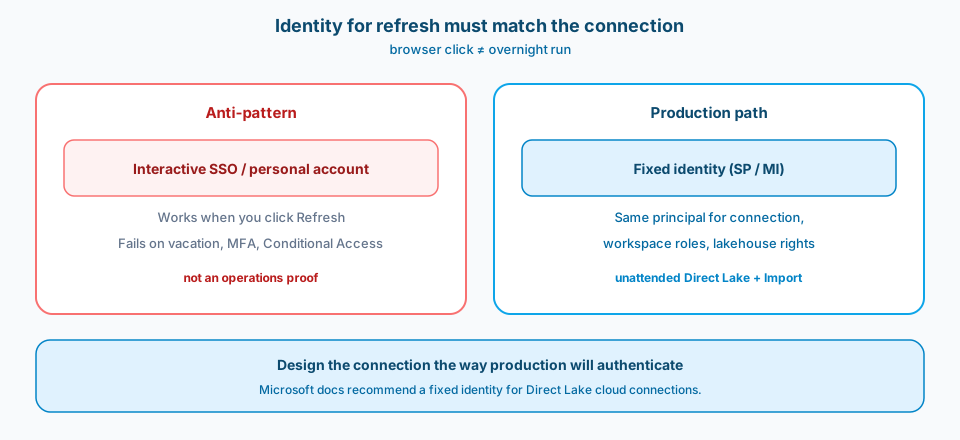
Figura 7. Que funcione con un clic en el navegador no prueba que funcione de madrugada. Usa una identidad fija para Direct Lake e Import desatendidos, con los mismos permisos sobre el workspace y el lakehouse.
5. Sabe cuándo sigue importando el refresh clásico
Direct Lake no elimina la necesidad de una arquitectura de refresh. Las tablas en Import la siguen necesitando. Los modelos compuestos siguen necesitando una historia clara por tabla. El framing y las operaciones de metadatos siguen perteneciendo al runbook. Las tablas calculadas y los patrones híbridos pueden reintroducir trabajo de carga aunque el hecho grande esté en Direct Lake. Mantén la disciplina incremental en Import: materializar entero un hecho enorme en cada ejecución acabará adueñándose de tu calendario de capacidad.
La figura 8 es el planteamiento de Learn para el lakehouse como superficie analítica. El modelo sigue teniendo que ser honesto sobre cómo lee esa superficie.
Figura 8. El lakehouse es la superficie analítica. Construye el lake y luego haz que el modelo sea honesto sobre cómo lo lee. Fuente: Microsoft Learn: lakehouse overview.
Errores comunes
Pipeline en verde, modelo desactualizado. Las transformaciones terminaron; nadie lanzó el paso del modelo o del framing.
Programaciones independientes. El refresh del modelo ignora si el pipeline terminó bien, así que refrescas un gold incompleto o te lo saltas cuando los datos llegan tarde.
El atajo cómodo del SQL endpoint. Los hechos pesados se quedan en vistas porque prototipar era fácil. Producción lo paga en tiempo de consulta y en expectativas confusas sobre Direct Lake.
MLV ignorada en el DAG. La definición existe; la responsabilidad del refresh, no. El gold y la semántica que dependen de ella se desvían en las noches tranquilas.
Identidad interactiva para trabajo desatendido. Funciona en la sesión de quien lo creó. Falla de madrugada por otro camino de autenticación.
Modos mezclados sin leyenda. Nadie sabe decir por qué la dimensión está en Import y el hecho en Direct Lake, así que el siguiente cambio adivina.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Qué construye las tablas y qué refresca o hace framing de los modelos, con responsables.
- El modo de almacenamiento por tabla o por modelo, con una razón en una línea.
- La identidad usada para los refresh desatendidos de Direct Lake e Import.
- Una política incremental o de saltar si no hay cambios para Import y para los builds del lake.
- Dónde va en el pipeline el refresh de las MLV y del gold que depende de ellas.
- Alertas cuando el pipeline termina bien pero fallan las comprobaciones de frescura semántica.
Adáptalo antes de usarlo
Una orquestación más estricta significa escribir más pipelines y tener más alertas. Negociarás con los responsables de la capacidad si se queman CU en un refresh completo de Import o en el framing de Direct Lake. Direct Lake reduce el dolor del refresh clásico en los hechos grandes, pero sube el listón de la higiene de Delta, los permisos y el diseño del modelo. Las MLV aportan elegancia y deuda de dependencias: cada salto materializado necesita un responsable en el DAG, o la frescura se convierte en folclore.
Pruébalo tú
La demo de ingesta de archivos con MLV de mi repositorio público tech-demos construye en un único lakehouse una cadena de materialized lake views de archivos a bronze, silver y gold, para que puedas lanzar un refresh y ver por ti mismo el linaje y el estado de cada vista.
Referencias principales: Direct Lake overview, Lakehouse overview, y Microsoft Learn sobre el refresh de semantic models y las conexiones de Direct Lake.
Construye el lake. Haz que el modelo sea honesto sobre cómo lee ese lake. Demuestra que la identidad nocturna puede hacer ambas cosas sin que tú estés mirando. Si tu diagrama tiene una sola flecha con la etiqueta Refresh, reparte el build, el modo y las operaciones del modelo entre responsables.
Relacionado
- Direct Lake on OneLake: ¿merece la pena el esfuerzo? (Direct Lake on OneLake cuando la plataforma retrocede)
- Fabric Monitor: ¿cómo vigilas los fallos de refresco de forma sistemática? (vigilar los fallos de refresco con un único runbook)
- Hechos grandes: ¿por qué un refresco en verde sigue derivando? (los contratos incrementales detrás de un refresco en verde)