

Puntos clave
- El trabajo de rendimiento en MLV empieza con líneas base de tiempo real y atribución por vista.
- Los avisos de NEE se clasifican como accionables, por investigar o aceptados, cada uno con responsable.
- Una reescritura exige un impacto medido en la latencia, no solo menos avisos.
- Los nodos lentos se pueden aislar con notebooks de diagnóstico por vista.
- Los avisos aceptados se documentan para la guardia y se revisan tras cambios de runtime.
- Las comprobaciones de capacidad y concurrencia acompañan al análisis de los fallbacks de SQL.
Las ejecuciones de Materialized Lake Views escupen avalanchas de avisos que mencionan fallbacks de Native Execution Engine. Los equipos reescriben Spark SQL presas del pánico para perseguir cada línea. Mientras tanto, el tiempo real del DAG sigue escondido en un nodo lento que nadie ha medido.
Mide primero. Los avisos que pegas incluyen detalles internos de los metadatos de Delta y de MLV que no puedes ni necesitas eliminar. Atribuir el tiempo real gana a las reescrituras por miedo. Corrige los pocos fallbacks que mueven la latencia. Ignora el resto de forma deliberada. Documenta los avisos aceptados para que la guardia no se vuelva loca. Combínalo con notebooks por vista para poder aislar los nodos lentos.
Modelo con nombre: línea base → clasificar → corregir lo que mueve la aguja
- Línea base: registra la duración total del DAG de MLV y los tiempos por vista antes de que nadie reescriba SQL.
- Clasificar: separa las líneas de NEE en accionables, por investigar o aceptadas, con un responsable y un motivo para revisarlas.
- Corregir lo que mueve la aguja: demuestra la latencia antes y después en las etapas calientes. Deja los fallbacks baratos documentados y en paz.
- Regla: los fallbacks accionables son un problema de presupuesto de latencia, no un concurso de pureza de cero avisos.
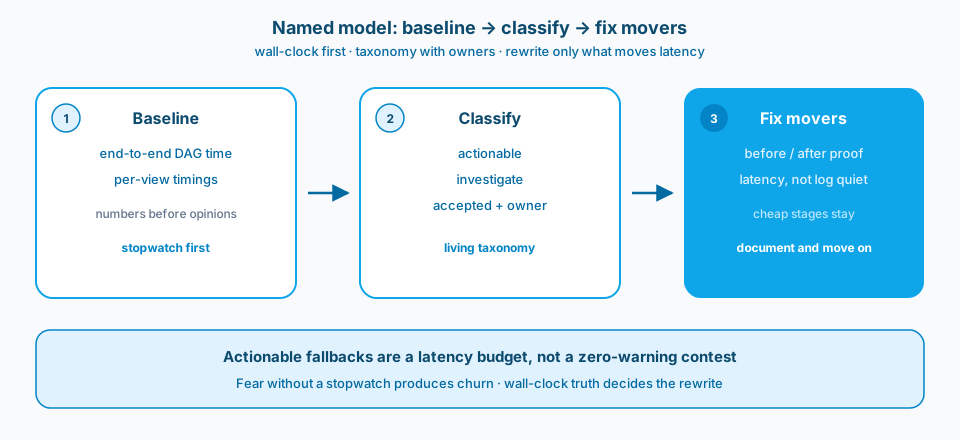
Figura 1. Modelo con nombre para el trabajo con NEE en Materialized Lake Views. Primero los números, después la clasificación y reescrituras solo donde se mueve el tiempo real.
Contexto y restricción
Los muros de avisos parecen urgentes y casi nunca contienen mucho que sea accionable. El trabajo útil empieza cuando mides las etapas, aíslas las vistas y mantienes una lista de avisos aceptados. La latencia baja cuando corriges los pocos fallbacks que importan, no cuando persigues todos los que no.
Algunos mensajes de NEE son ruido del entorno en torno a los metadatos y los detalles internos de la plataforma. Otros señalan operadores que de verdad abandonan la ruta nativa y cuestan minutos. Tu trabajo es atribuir: qué avisos se correlacionan con el tiempo real, cuáles están aceptados y cuáles merecen una reescritura. El miedo sin cronómetro solo genera ruido.
La figura 2 es la superficie de jobs de Spark en Fabric que hace visible el tiempo de cada etapa. Atribuye primero ahí. El texto de los avisos en la ruta crítica, después.
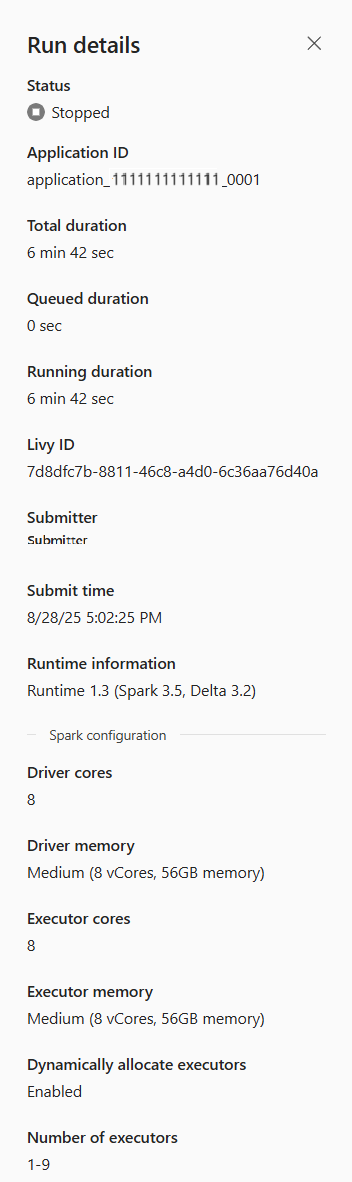
Figura 2. Atribuye el tiempo de MLV con los detalles del job y el DAG real. No trates cada aviso de NEE como una orden de reescritura. Fuente: Microsoft Learn: introducción a la supervisión de Spark.
1. Captura el tiempo real antes de reescribir SQL
Registra la duración total del DAG de MLV y los tiempos por vista. Sin una línea base, cada cambio parece una victoria en la reunión y un empate en producción. Primero los números, después las opiniones. La figura 1 muestra ese orden en tres pasos.
2. Clasifica los avisos en accionables y aceptados
Crea una clasificación corta: ruido conocido, por investigar y por corregir sí o sí. Actualízala cuando cambie la plataforma. Una lista viva es mejor que redescubrir el mismo texto alarmante cada trimestre. La figura 3 muestra las categorías que la guardia puede leer a las 2 de la madrugada.
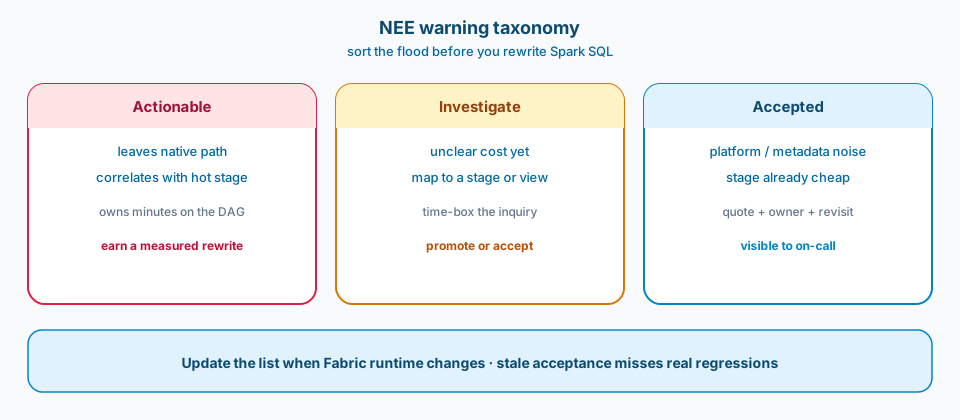
Figura 3. Ordena la avalancha antes de reescribir. Lo accionable cuesta minutos y tiene responsable. Lo que hay que investigar recibe un tiempo acotado. Lo aceptado sigue visible, con un responsable y un motivo para revisarlo.
3. Corrige solo los fallbacks que mueven la latencia
Demuestra con tiempos de antes y después que la reescritura ayuda. Si un fallback se mantiene y la etapa ya es barata, documéntalo y sigue adelante. Un SQL heroico que ahorra una fracción trivial de un DAG largo es teatro.
4. Aísla los nodos lentos con notebooks por vista
Cuando un DAG es opaco, ejecuta las vistas sospechosas por separado. Aislarlas convierte "la MLV es lenta" en "este patrón de join es lento". Los clústeres compartidos y la culpa compartida no ayudan a nadie. La figura 4 muestra el reparto de responsabilidades que acaba con el folclore.
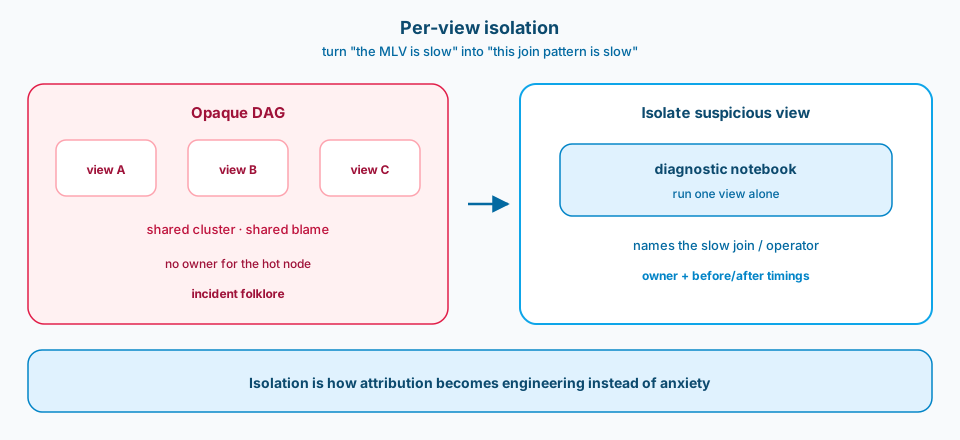
Figura 4. Los DAG opacos generan culpa compartida. Un notebook de diagnóstico que ejecuta una sola vista identifica el operador lento y le da un responsable.
5. Mantén los avisos aceptados visibles para la guardia
Publica la lista de aceptados junto al runbook. La guardia no debería saltar a las 2 de la madrugada por ruido documentado. El silencio sin documentación es la forma en que el ruido se convierte más tarde en una señal ignorada.
6. Revisa tras las actualizaciones de la plataforma
Los motores nativos evolucionan. Un aviso que era ruido puede volverse accionable, o al revés. Programa revisiones tras los cambios del runtime de Fabric. Las listas de aceptados desactualizadas son la forma de pasar por alto regresiones reales.
Cómo atribuir sin ahogarte en la Spark UI
Empieza por la duración total de la ejecución de la MLV y las tres etapas que más tiempo consumen. Asocia esas etapas a las vistas u operadores de los que eres responsable. Solo entonces abre el texto de los avisos de esas etapas calientes. Leer todos los avisos de una ejecución en frío enseña ansiedad. Leer los avisos de la ruta crítica enseña ingeniería. Guarda los volcados completos de avisos como artefactos y analízalos de forma selectiva.
Qué incluir en un ADR de avisos aceptados
Cita el patrón del aviso, por qué aparece, por qué se acepta, quién se encarga de revisarlo y qué métrica obligaría a reabrirlo. Incluye una línea de log de ejemplo. Una aceptación vaga ("cosas de la plataforma") deja tirada a la siguiente incorporación. Una aceptación concreta sobrevive a las actualizaciones y a las auditorías.
Junto con la verdad sobre capacidad y concurrencia
A veces el tiempo real de una MLV es cola y limitación, no NEE. Mide las métricas de concurrencia y capacidad junto al trabajo con los fallbacks. Si no, pasarás una semana "arreglando" Spark mientras la plataforma simplemente sobresuscribió el mismo slot. La atribución incluye el entorno, no solo la forma del SQL.
Comunicar resultados sin teatro de avisos
Cuando cuentes a los stakeholders que una MLV es más rápida, enseña el tiempo real y los uno o dos fallbacks que corregiste. No celebres un log más silencioso si la duración no se movió. Los logs silenciosos con la misma latencia enseñan a la dirección a financiar cosmética. Los logs ruidosos con una lista clara de aceptados le enseñan a financiar la medición. Mejor gráficos de duración por vista que capturas de texto de aviso en amarillo.
Errores comunes
Cero avisos como KPI. Los equipos reescriben por cosmética. El log calla y el DAG sigue igual.
Sin línea base. No se pueden juzgar los cambios. Cada PR se anuncia como una victoria.
Folclore solo a nivel de DAG. "Siempre ha sido lento." Nadie nombra una vista ni una etapa.
Aceptación sin documentar. Cada guardia vuelve a aprender el pánico ante las mismas líneas de metadatos.
No revisar nunca. Las antiguas clasificaciones como ruido sobreviven a la verdad tras una actualización del runtime.
Culpa compartida. Sin aislamiento por vista no hay responsables. La figura 4 hace visible ese fallo.
Úsalo tal cual o adáptalo
Úsalo tal cual
- El trabajo de rendimiento en MLV empieza con líneas base de tiempo real y atribución por vista.
- Los avisos de NEE se clasifican como accionables, por investigar o aceptados, cada uno con responsable.
- Una reescritura exige un impacto medido en la latencia, no solo menos avisos.
- Los nodos lentos se pueden aislar con notebooks de diagnóstico por vista.
- Los avisos aceptados se documentan para la guardia y se revisan tras cambios de runtime.
- Las comprobaciones de capacidad y concurrencia acompañan al análisis de los fallbacks de SQL.
Adáptalo antes de usarlo
Las listas de avisos aceptados parecen una rendición. Las cruzadas por cero avisos parecen productivas y desperdician semanas. Los notebooks por vista añaden rutas operativas. Los DAG opacos alargan los incidentes. Las revisiones programadas cargan el calendario, y saltárselas es un riesgo silencioso de regresión. Demostrar las mejoras de latencia ralentiza los PR y evita artículos sobre falsas victorias.
Referencias principales: introducción a la supervisión de Spark y introducción a Materialized Lake Views en Microsoft Learn. Combínalas con tu lista de avisos aceptados para que los ingenieros sepan qué realidad están optimizando.
Mide el DAG. Clasifica el ruido. Corrige lo que mueve la latencia. Documenta lo que aceptas. Aísla las vistas lentas. Revisa tras las actualizaciones. La mayoría de las líneas de NEE no son tu emergencia. El tiempo real sí.