
Das Wichtigste in Kürze
- Die Triage von Timeouts beginnt mit einer Abhängigkeitskarte und dem Finden der Stämme.
- Lösche Waisen, bevor du neue Optimierungsprojekte startest.
- Günstige Rewrites kommen vor Materialisierung und Plattformwechseln.
- Materialisiere standardmäßig nur die gemeinsam genutzten schweren Konsolidierungen.
- Miss vorher und nachher mit einem einzigen, aufbewahrten Abfrage-Harness.
- Inventare müssen für CI/CD Views und verwaltete Tabellen unterscheiden.
Wenn mehrere Warehouse Views in Timeouts laufen, heißt das meist: ein paar gemeinsame Stämme und viele Abhängige. Teams, die jedes Blatt umschreiben oder direkt auf eine neue Plattform springen, übersehen oft den günstigen Gewinn: die Konsolidierungen materialisieren, an denen alles andere hängt.
Nutze ein Playbook in Stufen. Lösche Waisen. Wende günstige Rewrites bei Prädikaten und Joins an. Materialisiere dann die zwei oder drei schweren Konsolidierungen. Miss vorher und nachher mit demselben Harness. Dokumentiere, was eine View und was eine verwaltete Tabelle ist, damit CI/CD ehrlich bleibt.
Benanntes Modell: Stämme vor Blättern
- Karte: Verfolge Timeouts nach oben, bis du Konsolidierungen findest, die viele Fehler gemeinsam haben.
- Aufräumen: Waisen löschen; Prädikate nach unten schieben; tote Joins und gestapelte
SELECT *entfernen. - Materialisieren: Plane die zwei oder drei Stämme ein, die jeder Gold-Pfad liest; lass die Abhängigen als schlanke Views.
- Nachweisen: gleiches Harness vorher und nachher; das Inventar kennzeichnet View oder verwaltete Tabelle.
- Vertrag: Aktualität und Parität gehören zur Materialisierung, nicht in einen späteren Wunsch.
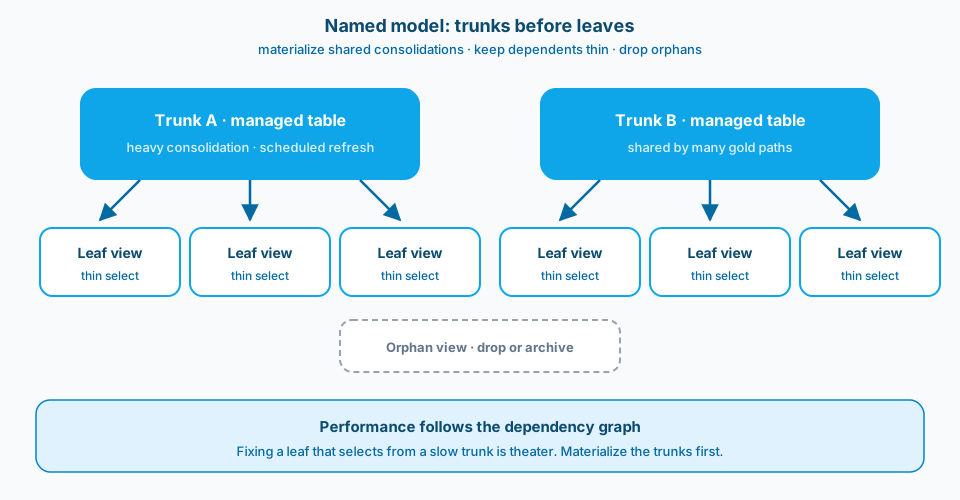
Abbildung 1. Stämme vor Blättern. Materialisiere die gemeinsamen Konsolidierungen. Halte die Abhängigen schlank. Lösche Waisen, die immer noch zum Kopieren verleiten.
Kontext und Rahmenbedingung
Ein häufiger Fehler: Jeder Timeout erzeugt ein neues Ticket "optimiere diese View". Die Blätter werden hübscher. Der Stamm scannt bei jedem Aufruf weiter dieselben riesigen Konsolidierungen. Sobald die Stämme materialisiert sind, werden Abhängige, die hoffnungslos aussahen, wieder langweilig.
Verwaiste Views verschwenden Aufmerksamkeit. Günstige Rewrites (nach unten geschobene Filter, entfernte tote Joins) sollten vor neuer Infrastruktur kommen. Materialisierte Konsolidierungen machen Gold nahezu sofort verfügbar, ohne jeden Nutzer umzuschreiben. Messungen ohne stabiles Harness erfinden Folklore. Dokumentation, die bei View oder Tabelle lügt, erzeugt Überraschungen beim Deployment.
Abbildung 2 zeigt die Warehouse-Oberfläche in Fabric. Wenn Abhängige in Timeouts laufen, beginne mit dem Graphen, nicht mit einem Ticket zum Umschreiben eines Blatts.
Abbildung 2. Wenn Abhängige in Timeouts laufen, materialisiere zuerst die Stamm-Konsolidierungen, statt jede Blatt-View umzuschreiben. Quelle: Microsoft Learn: data warehousing in Fabric.
Abbildung 3 zeigt die Oberfläche des SQL analytics endpoint. Miss vorher und nachher mit demselben Harness und halte das Inventar ehrlich darüber, was eine View und was eine verwaltete Tabelle ist.
Abbildung 3. Miss vorher und nachher mit demselben Harness. Dokumentiere View oder verwaltete Tabelle, damit CI/CD ehrlich bleibt. Quelle: Microsoft Learn: data warehousing in Fabric.
Design
1. Timeouts den Stämmen zuordnen
Profiliere, welche Objekte Zeit verbrennen. Verfolge die Abhängigen nach oben, bis du die Konsolidierungen findest, die viele Fehler gemeinsam haben. Ein Blatt zu reparieren, das aus einem langsamen Stamm liest, ist Theater. Veröffentliche einen kurzen Graphen im Repo, damit die nächste Störung nicht bei null beginnt.
2. Waisen löschen, bevor es clever wird
Wenn nichts eine View nutzt, lösche oder archiviere sie. Waisen tauchen weiter in der Suche auf, verleiten weiter zum Kopieren und verwirren weiter die Kapazitätsreviews. Sie zu entfernen ist Performance-Arbeit mit der Entf-Taste.
3. Zuerst günstige Rewrites versuchen
Schiebe Prädikate näher an die Basistabellen. Entferne ungenutzte Joins und Spalten. Ersetze SELECT *, das drei Ebenen tief gestapelt ist. Diese Änderungen lassen sich zurücknehmen und zeigen dir das echte Kostenmodell. Mach sie mit Paritätsprüfungen, damit "schneller" nicht "anders" heißt.
4. Die gemeinsamen Konsolidierungen materialisieren
Wenn zwei oder drei Objekte die CPU dominieren und jeder Gold-Pfad sie liest, materialisiere sie nach einem Zeitplan, der zu den Anforderungen an die Aktualität passt. Die Abhängigen bleiben Views. Die Nutzer behalten ihre Verträge. Du zahlst Speicher und Refresh, um eine vorhersehbare Leselatenz zu bekommen. Für Pfade mit Direct Lake ist eine Tabelle auf Basis einer nicht materialisierten SQL-View ein bekanntes Fallback-Risiko; den Stamm zu materialisieren ist der Weg, die Leselatenz ehrlich zu halten.
Abbildung 4 zeigt die Reihenfolge, die verhindert, dass Speicher und Refresh ausufern, bevor du sie dir verdient hast.
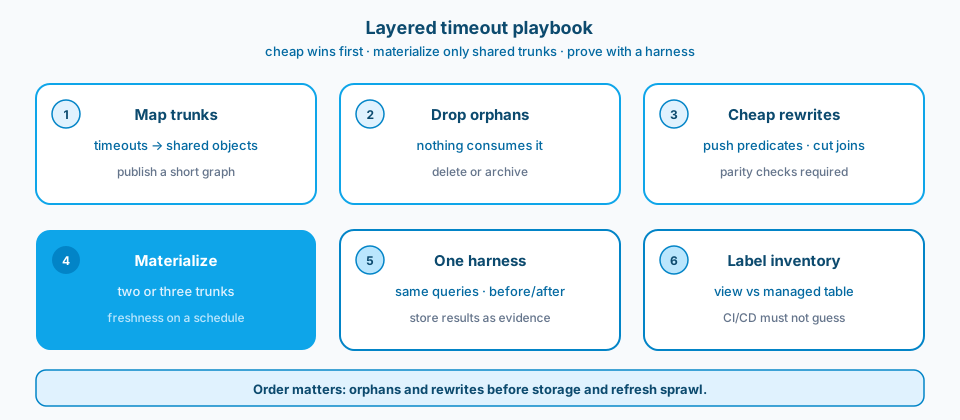
Abbildung 4. Playbook für Timeouts in Stufen. Waisen und günstige Rewrites kommen vor der Materialisierung. Harness und Inventar kommen mit der Änderung, nicht danach.
5. Mit einem einzigen Harness messen
Gleiche Abfragen, gleiche Parameter, gleiche Annahmen zur Parallelität vorher und nachher. Erfasse die Laufzeit und die Kapazitätssignale, nach denen du tatsächlich arbeitest. Anekdoten vom Laptop sind kein Release-Nachweis. Speichere die Ergebnisse neben der Änderung.
6. Views und verwaltete Tabellen in CI/CD kennzeichnen
Deployment-Dokumentation und Inventardateien sollten sagen, welche Objekte materialisiert sind. Einen Stamm versehentlich als View wiederherzustellen ist ein Ausfall, der sich als erfolgreiches Deployment verkleidet. Sei bei Namen oder Metadaten ausdrücklich, damit weder Menschen noch Pipelines raten müssen.
Abbildung 5 zeigt den Vertrag, der verhindert, dass "fühlte sich schneller an" und heimliche Materialisierungen zu Folklore werden.
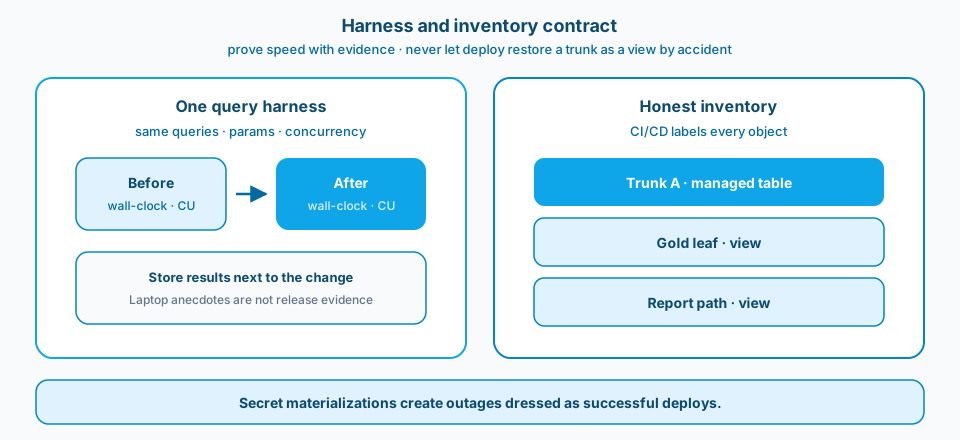
Abbildung 5. Ein Harness für vorher und nachher. Ein ehrliches Inventar für CI/CD. Heimliche Materialisierungen sind der Grund, warum der Support Live-Compute erwartet und stattdessen Verzögerung bekommt.
Aktualität ist Teil des Materialisierungsvertrags
Ein materialisierter Stamm ist nur ein Gewinn, wenn die Nutzer wissen, wie veraltet er sein kann. Veröffentliche den Zeitplan, das Watermark und das Verhalten, wenn ein Refresh ausfällt. Wenn ein Abhängiger eine engere Aktualität braucht, als der Stamm bietet, ist das eine Produktentscheidung: Verzögerung akzeptieren, für einen schmaleren Live-Pfad zahlen oder die Konsolidierung aufteilen. Versteck die Verzögerung nicht hinter einem View-Namen, der Live-Compute im Warehouse suggeriert.
Die zwei oder drei Stämme auswählen
Ordne die Kandidaten nach der Zahl gemeinsamer Abhängiger mal durchschnittlichen Kosten. Widersteh der Versuchung, ein politisch wichtiges Blatt zu materialisieren, das sonst niemand nutzt. Widersteh auch der Versuchung, eine hässliche Konsolidierung auszulassen, weil das SQL peinlich ist; Peinlichkeit ist kein Kostenmodell. Profiliere nach der Materialisierung erneut. Manchmal wird ein Objekt aus der zweiten Reihe zum neuen Stamm. Wiederhole das einmal. Hör auf, bevor du ohne Grund das ganze Warehouse als Tabellen neu erfindest.
Kommunikation mit den Verantwortlichen der Berichte
Sag den Nutzern, wann ein Stamm materialisiert wird und welche Aktualität sie erwarten können. Sonst kommen Tickets "das Warehouse ist falsch", die eigentlich "der Refresh ist noch nicht durch" bedeuten. Eine kurze Notiz in der Beschreibung des Semantic Model oder eine Ankündigung im Workspace schlägt eine Überraschung. Wenn ein VIP-Bericht Live-Compute gegen den Stamm braucht, benenne das als Ausnahme mit Kosten und Risiko, nicht als stilles Zurück zur View.
Parität gilt auch, wenn du für Tempo materialisierst
Ein schnellerer Stamm, der die Granularität ändert, ist kein Gewinn. Behalte dieselbe Denkweise beim Abgleich wie bei der Migration auf MLVs: Zeilenzahlen, Keys und ein paar kritische Aggregate, bevor du die Abhängigen auf die Tabelle zeigen lässt. Performance-Projekte, die die Parität überspringen, erzeugen stille semantische Releases. Mach den Paritätsjob zum Teil des Materialisierungs-PRs, nicht zu einem späteren Wunsch.
Häufige Fehler
Optimierung bei den Blättern zuerst. Hübsches SQL auf einem Hochofen.
Plattformwechsel als erster Schritt. Neue Engine, derselbe Fehler im Graphen.
Alles materialisieren. Speicher und Refresh ufern aus; niemand kennt die Geschichte zur Aktualität.
Kein Harness. Jede Änderung "fühlte sich schneller an".
Heimliche Materialisierungen. Das Inventar sagt weiter "View"; der Support erwartet Live-Compute.
Aufräumen der Waisen auslassen. Kapazität und Aufmerksamkeit laufen beide aus.
So übernehmen oder anpassen
So übernehmen
- Die Triage von Timeouts beginnt mit einer Abhängigkeitskarte und dem Finden der Stämme.
- Waisen werden entfernt, bevor neue Optimierungsprojekte starten.
- Günstige Rewrites kommen vor Materialisierung und Plattformwechseln.
- Standardmäßig werden nur gemeinsam genutzte schwere Konsolidierungen materialisiert.
- Ergebnisse vorher und nachher nutzen ein gemeinsames Abfrage-Harness, das als Nachweis aufbewahrt wird.
- Inventare unterscheiden für CI/CD Views von verwalteten oder materialisierten Tabellen.
Vor dem Einsatz anpassen
Materialisierung bringt Refresh-Jobs und Speicher mit sich. Timeouts bringen Frust bei den Nutzern und Schatten-Extrakte. Günstige Rewrites kosten Analysezeit; oft machen sie größere Änderungen überflüssig. Strenge Disziplin beim Inventar nervt Leute, die gern still umbenennen. Stille Umbenennungen brechen Abhängige. Das Harness zu pflegen ist echte Arbeit; Folklore zu pflegen ist endlose Arbeit.
Wichtigste Quellen: Fabric data warehousing, Direct Lake overview (SQL-Views und Fallback) sowie die Hinweise zu Warehouse-Performance und Query Insights auf Microsoft Learn. Kombiniere die Empfehlungen der Plattform mit deiner Abhängigkeitskarte, damit die Optimierung den Kanten folgt und nicht Meinungen.
Finde die Stämme. Wirf totes Gewicht ab. Schreib günstig um. Materialisiere die gemeinsamen Konsolidierungen. Miss. Lass die Blätter schlank. Timeouts werden zu einem Zeitplanproblem, das du benennen kannst, statt zu einer wöchentlichen Panik über "das Warehouse".
Verwandte Notizen
- NEE Fallback: Warum weichen Ergebnisse mit und ohne Native Execution Engine ab? (die Laufzeit einer MLV messen, bevor du wegen Engine-Warnungen umschreibst)