
Puntos clave
- El triaje de timeouts empieza con un mapa de dependencias y la identificación de los troncos.
- Elimina las huérfanas antes de lanzar nuevos proyectos de optimización.
- Las reescrituras baratas van antes de la materialización y de los cambios de plataforma.
- Por defecto, materializa solo las consolidaciones pesadas compartidas.
- Mide antes y después con un único arnés de consultas que conservas.
- Los inventarios deben distinguir vistas de tablas gestionadas para CI/CD.
Cuando varias vistas de warehouse dan timeout, lo normal es que haya un par de troncos compartidos y muchas dependientes. Los equipos que reescriben cada hoja, o saltan directamente a una plataforma nueva, suelen perderse la victoria barata: materializar las consolidaciones de las que cuelga todo lo demás.
Usa un playbook por capas. Elimina las huérfanas. Aplica reescrituras baratas de predicados y joins. Después materializa las dos o tres consolidaciones pesadas. Mide con el mismo arnés antes y después. Documenta qué es una vista y qué es una tabla gestionada para que CI/CD siga siendo honesto.
Modelo con nombre: troncos antes que hojas
- Mapa: sigue los timeouts hacia arriba hasta encontrar las consolidaciones que comparten muchos fallos.
- Limpieza: elimina huérfanas; empuja los predicados hacia abajo; quita joins muertos y
SELECT *apilados. - Materialización: programa los dos o tres troncos que lee cada ruta de gold; deja las dependientes como vistas ligeras.
- Prueba: el mismo arnés antes y después; el inventario indica si es vista o tabla gestionada.
- Contrato: la frescura y la paridad forman parte de la materialización, no de un deseo para más adelante.
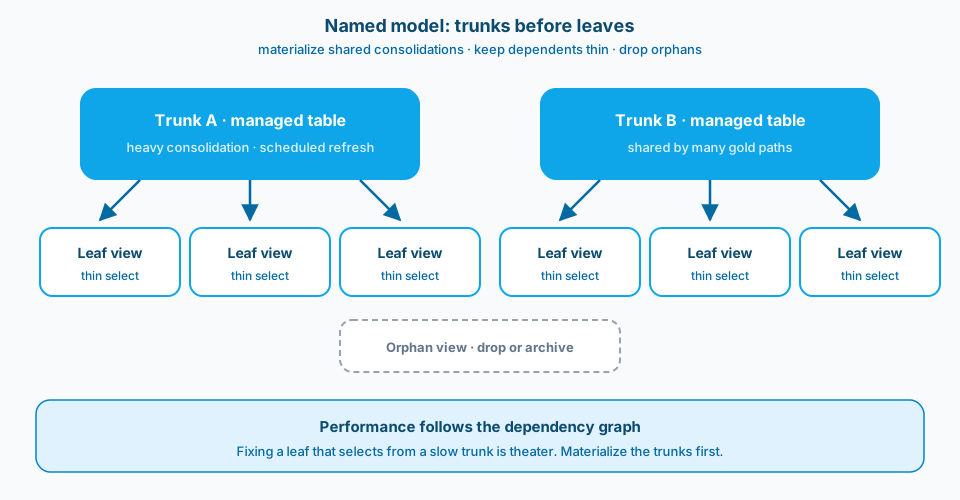
Figura 1. Troncos antes que hojas. Materializa las consolidaciones compartidas. Mantén ligeras las dependientes. Elimina las huérfanas que todavía invitan a copiar y pegar.
Contexto y restricción
Un fallo habitual: cada timeout genera un nuevo ticket de "optimiza esta vista". Las hojas quedan más bonitas. El tronco sigue escaneando las mismas consolidaciones gigantes en cada llamada. En cuanto los troncos están materializados, dependientes que parecían imposibles vuelven a ser aburridas.
Las vistas huérfanas desperdician atención. Las reescrituras baratas (filtros empujados hacia abajo, joins muertos eliminados) deberían ir antes que la infraestructura nueva. Las consolidaciones materializadas hacen que gold sea casi instantáneo sin reescribir cada consumidor. Medir sin un arnés estable inventa folclore. La documentación que miente sobre si algo es vista o tabla provoca sorpresas en los despliegues.
La figura 2 es la pantalla del warehouse en Fabric. Cuando las dependientes dan timeout, empieza por el grafo, no por un ticket para reescribir una hoja.
Figura 2. Cuando las dependientes dan timeout, materializa primero las consolidaciones troncales en lugar de reescribir cada vista hoja. Fuente: Microsoft Learn: data warehousing in Fabric.
La figura 3 es la pantalla del SQL analytics endpoint. Mide con el mismo arnés antes y después, y mantén el inventario honesto sobre qué es una vista y qué es una tabla gestionada.
Figura 3. Mide con el mismo arnés antes y después. Documenta si es vista o tabla gestionada para que CI/CD siga siendo honesto. Fuente: Microsoft Learn: data warehousing in Fabric.
Diseño
1. Relaciona los timeouts con los troncos
Perfila qué objetos queman tiempo. Sigue las dependientes hacia arriba hasta encontrar las consolidaciones que comparten muchos fallos. Arreglar una hoja que lee de un tronco lento es teatro. Publica un grafo corto en el repo para que el siguiente incidente no empiece de cero.
2. Elimina las huérfanas antes de ponerte ingenioso
Si nada consume una vista, bórrala o archívala. Las huérfanas siguen apareciendo en las búsquedas, siguen invitando a copiar y pegar y siguen confundiendo las revisiones de capacidad. Quitarlas es trabajo de rendimiento con la tecla de borrar.
3. Prueba primero las reescrituras baratas
Acerca los predicados a las tablas base. Quita joins y columnas que no se usan. Sustituye los SELECT * apilados tres niveles. Son cambios reversibles que enseñan el modelo de costes real. Hazlos con comprobaciones de paridad para que "más rápido" no signifique "distinto".
4. Materializa las consolidaciones compartidas
Cuando dos o tres objetos dominan la CPU y todas las rutas de gold los leen, materialízalos con una programación que encaje con las necesidades de frescura. Las dependientes siguen siendo vistas. Los consumidores conservan sus contratos. Pagas almacenamiento y refresco a cambio de una latencia de lectura predecible. En rutas con Direct Lake, una tabla basada en una vista SQL no materializada es un riesgo de fallback conocido; materializar el tronco es la forma de mantener honesta la latencia de lectura.
La figura 4 es el orden que evita que el almacenamiento y los refrescos se disparen antes de que te los hayas ganado.
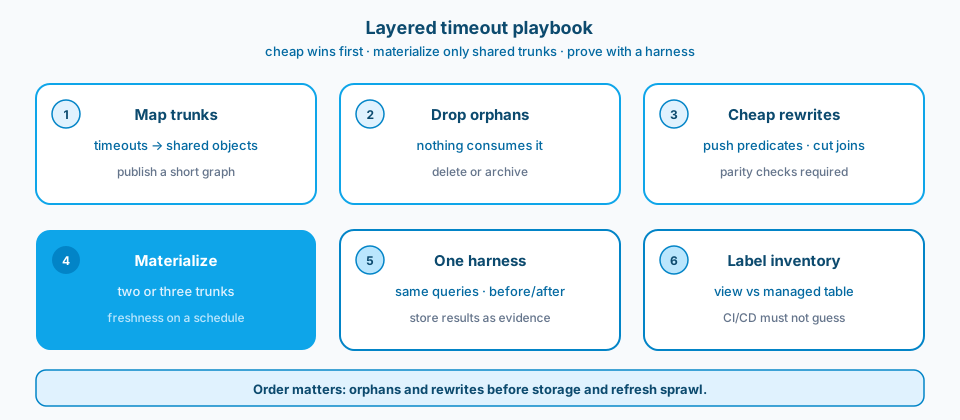
Figura 4. Playbook por capas para timeouts. Las huérfanas y las reescrituras baratas van antes de la materialización. El arnés y el inventario llegan con el cambio, no después.
5. Mide con un único arnés
Las mismas consultas, los mismos parámetros y los mismos supuestos de concurrencia antes y después. Captura el tiempo real y las señales de capacidad con las que de verdad operas. Las anécdotas desde un portátil no son evidencia de release. Guarda los resultados junto al cambio.
6. Etiqueta vistas y tablas gestionadas en CI/CD
La documentación de despliegue y los archivos de inventario deberían decir qué objetos están materializados. Restaurar por accidente un tronco como vista es una caída disfrazada de despliegue correcto. Sé explícito en los nombres o los metadatos para que ni las personas ni los pipelines tengan que adivinar.
La figura 5 es el contrato que evita que "parecía más rápido" y las materializaciones secretas se conviertan en folclore.
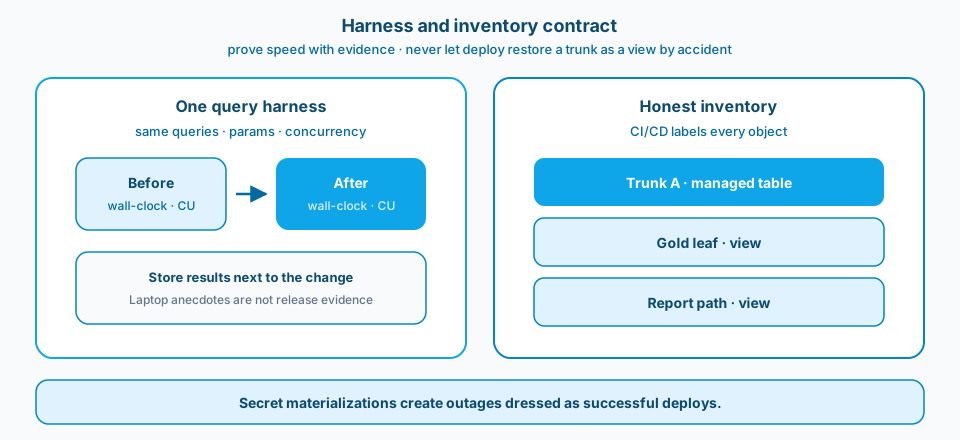
Figura 5. Un arnés para antes y después. Un inventario honesto para CI/CD. Las materializaciones secretas son la razón de que soporte espere cómputo en vivo y reciba retraso.
La frescura forma parte del contrato de materialización
Un tronco materializado solo es una victoria si los consumidores saben lo desactualizado que puede estar. Publica la programación, la marca de agua y el comportamiento cuando un refresco se salta. Si una dependiente necesita más frescura de la que ofrece el tronco, es una decisión de producto: aceptar el retraso, pagar por una ruta en vivo más estrecha o dividir la consolidación. No escondas el retraso tras un nombre de vista que da a entender cómputo en vivo en el warehouse.
Elegir los dos o tres troncos
Ordena los candidatos por número de dependientes compartidas multiplicado por el coste medio. Resiste la tentación de materializar una hoja políticamente importante que nadie más usa. Resiste también la de saltarte una consolidación fea porque el SQL da vergüenza; la vergüenza no es un modelo de costes. Después de materializar, vuelve a perfilar. A veces un objeto de segundo nivel se convierte en el nuevo tronco. Repite una vez. Para antes de reinventar todo el warehouse como tablas sin motivo.
Comunicación con los responsables de los informes
Avisa a los consumidores cuando un tronco pase a estar materializado y de qué frescura pueden esperar. Si no, abrirán tickets de "el warehouse está mal" que en realidad significan "el refresco todavía no ha llegado". Una nota breve en la descripción del semantic model o un aviso en el workspace es mejor que una sorpresa. Si un informe VIP necesita cómputo en vivo contra el tronco, señálalo como una excepción con su coste y su riesgo, no como una vuelta silenciosa a la vista.
La paridad sigue aplicando cuando materializas para ganar velocidad
Un tronco más rápido que cambia la granularidad no es una victoria. Mantén la misma mentalidad de conciliación que usas en la migración a MLV: recuentos de filas, claves y unos pocos agregados críticos antes de apuntar las dependientes a la tabla. Los proyectos de rendimiento que se saltan la paridad crean releases semánticos silenciosos. Haz que el job de paridad forme parte del PR de materialización, no de un deseo para más adelante.
Errores comunes
Optimizar primero las hojas. SQL bonito encima de un horno.
Cambiar de plataforma como primer paso. Motor nuevo, mismo error en el grafo.
Materializarlo todo. El almacenamiento y los refrescos se disparan; nadie conoce la historia de la frescura.
Sin arnés. Cada cambio "parecía más rápido".
Materializaciones secretas. El inventario sigue diciendo "vista"; soporte espera cómputo en vivo.
Saltarse la limpieza de huérfanas. Se escapan tanto la capacidad como la atención.
Úsalo tal cual o adáptalo
Úsalo tal cual
- El triaje de timeouts empieza con un mapa de dependencias y la identificación de los troncos.
- Las huérfanas se eliminan antes de lanzar nuevos proyectos de optimización.
- Las reescrituras baratas van antes de la materialización y de los cambios de plataforma.
- Por defecto solo se materializan las consolidaciones pesadas compartidas.
- Los resultados de antes y después usan un arnés de consultas compartido que se conserva como evidencia.
- Los inventarios distinguen vistas de tablas gestionadas o materializadas para CI/CD.
Adáptalo antes de usarlo
La materialización añade jobs de refresco y almacenamiento. Los timeouts añaden dolor para los usuarios y extracciones en la sombra. Las reescrituras baratas cuestan tiempo de análisis; a menudo eliminan la necesidad de cambios más amplios. La disciplina estricta en el inventario molesta a quien prefiere renombrar sin avisar. Los renombrados silenciosos rompen las dependientes. Mantener el arnés es trabajo real; mantener el folclore es trabajo sin fin.
Referencias principales: Fabric data warehousing, Direct Lake overview (vistas SQL y fallback) y la guía de rendimiento del warehouse y query insights en Microsoft Learn. Combina los consejos de la plataforma con tu mapa de dependencias para que la optimización siga las aristas y no las opiniones.
Encuentra los troncos. Suelta el peso muerto. Reescribe barato. Materializa las consolidaciones compartidas. Mide. Deja ligeras las hojas. Los timeouts pasan a ser un problema de programación que puedes nombrar, no un pánico semanal por "el warehouse".
Relacionado
- NEE fallback: ¿por qué varían los resultados con y sin Native Execution Engine? (medir el tiempo de ejecución de una MLV antes de reescribir por avisos del motor)