
Das Wichtigste in Kürze
- Umstellungen auf MLVs brauchen einen Abgleich in Stufen: Zeilen, dann Keys, dann Spaltenaggregate.
- Vergleichsmethoden berücksichtigen den Datentyp, mit Toleranzen, die pro Spalte festgeschrieben sind.
- Eine Checklistenzeile pro Spalte (verantwortliche Person, Methode, Freigabe) ist für Gold Pflicht.
- Validierungsjobs liefern maschinenlesbare Ergebnisse plus eine begrenzte Stichprobe der Abweichungen.
- Bewahre diese Artefakte als Release-Nachweis neben der MLV-Definition auf.
- Lass das Harness bei wesentlichen Änderungen an einer MLV erneut laufen, nicht nur bei der ersten Umstellung.
Eine Migrations-Checkliste, die nur Zeilenzahlen vergleicht, gibt falsche Summen, falsche Daten und falsche Status frei. Zeilenzahlen fangen katastrophale Verluste ab. Sie übersehen den stillen CAST, der Dezimalzahlen in Floats verwandelt, die Null, die zum leeren String wurde, und die Spalte, die still auf einen Standardwert gefallen ist.
Bring MLV-Umstellungen auf Tabellen pro Spalte und typbewusste Aggregate. Übernimm den Abgleich in Stufen, dem klassische Datenmigrationen schon vertrauen: Zeilen, dann Keys, dann Spaltenaggregate. Automatisiere ihn. Behandle die Artefakte als Release-Nachweis, nicht als Screenshot, der irgendwo im Chat untergeht.
Benanntes Modell: Zeilen → Keys → Spaltenaggregate
- Zeilen: Anzahlen und Aktualitätsfenster beantworten, ob Volumen verschwunden ist. Nur ein Smoke-Test.
- Keys: Vorhandensein, Duplikate und Waisen beantworten, ob dieselben Entitäten angekommen sind. Bei harten Fehlern hier stoppen.
- Spaltenaggregate: typbewusste Summen, Null-Raten und Verteilungen beantworten, ob die Werte noch dasselbe bedeuten.
- Checkliste: Jede Spalte bekommt verantwortliche Person, Vergleichsmethode, Toleranz, letztes Ergebnis und Freigabe.
- Vertrag: Semantische Drift versteckt sich in Spalten. Eine Validierung, die keine Spalte benennen kann, kann keine Umstellung schützen.
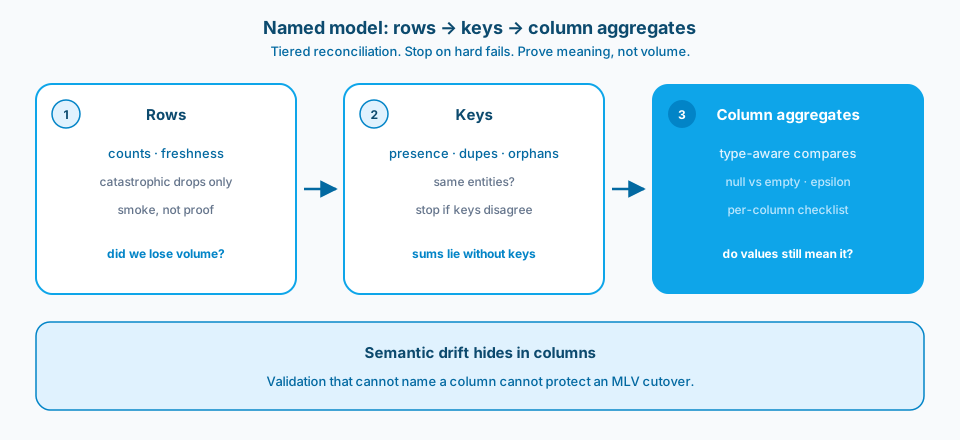
Abbildung 1. Zeilen fangen Katastrophen ab. Keys fangen fehlende Entitäten ab. Spaltenaggregate fangen den stillen CAST ab, der Summen bricht. Führe sie der Reihe nach aus und stoppe bei harten Fehlern.
Kontext und Rahmenbedingung
Ein häufiger Fehler: Eine Umstellung stimmt bei den Zeilen und scheitert an einem Measure, das eine Dezimalspalte summiert, die die MLV zu ungenauen Floats erweitert hat. Nachgelagerte Nutzer interessiert nicht, dass Spark früher fertig war. Sie interessiert, dass zwei Summen weit genug auseinanderliegen, um einen Streit auszulösen.
Den Abgleich in Stufen gibt es, weil jede Stufe eine andere Frage beantwortet. Zeilen fragen: "Haben wir Volumen verloren?" Keys fragen: "Haben wir dieselben Entitäten?" Spaltenaggregate fragen: "Bedeuten die Werte noch dasselbe?" Typbewusste Vergleiche fangen Abweichungen zwischen Float und Decimal oder zwischen Null und leer ab, die ein Gleichheitsvergleich auf Strings überdeckt. Eine Checklistenzeile pro Spalte macht Verantwortung und Freigabe erst möglich. Screenshot-QA ist kein Nachweis.
Abbildung 2 zeigt die Oberfläche in Learn für Datenqualitätsberichte von MLVs. Prüfungen der Plattform helfen. Sie ersetzen keinen schriftlichen Spaltenvertrag mit verantwortlichen Personen und Toleranzen.
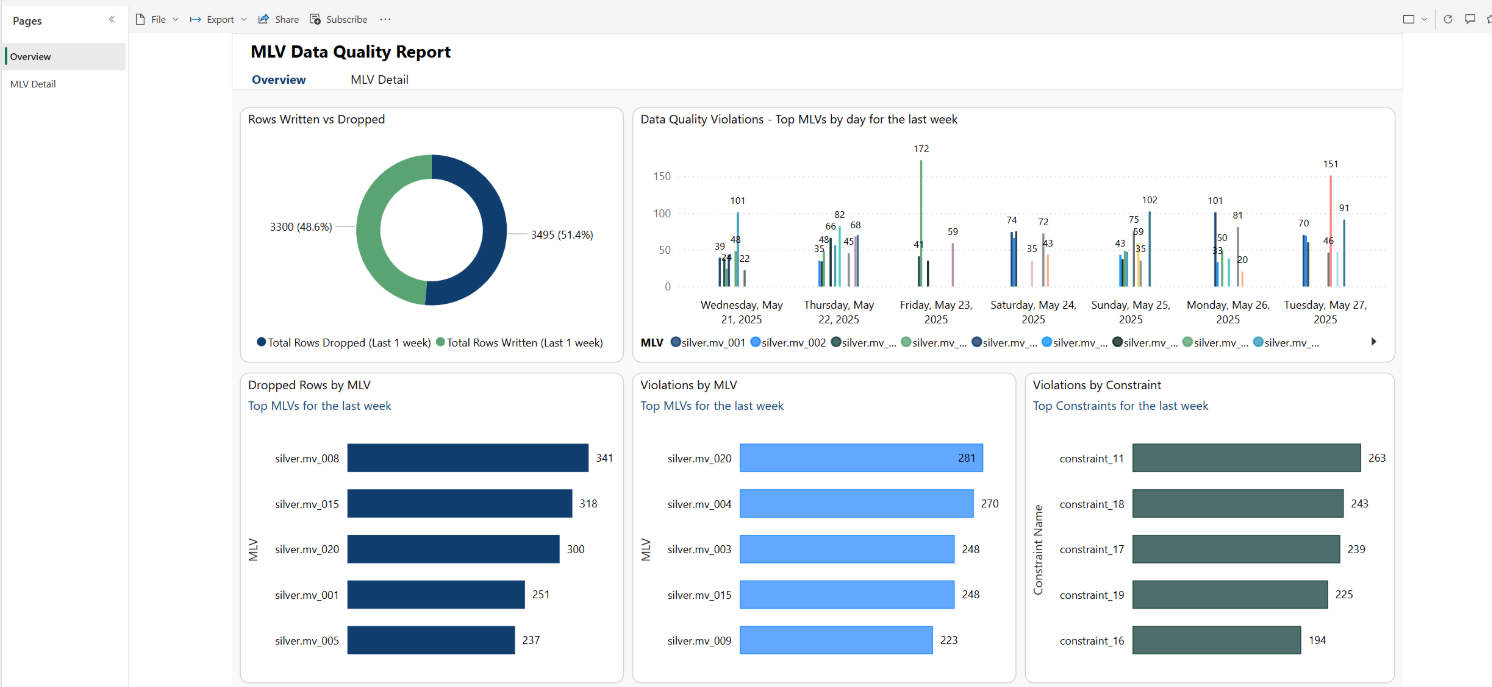
Abbildung 2. Zeilenzahlen fangen Katastrophen ab. Spaltenaggregate und Qualitätsberichte fangen den stillen CAST ab, der Summen bricht. Quelle: Microsoft Learn: MLV data quality reports.
Abbildung 3 zeigt die Detailansicht. Behandle die Ergebnisse des Abgleichs pro Spalte als Release-Nachweis für MLV-Umstellungen, nicht als optionale Notizen im Notebook.
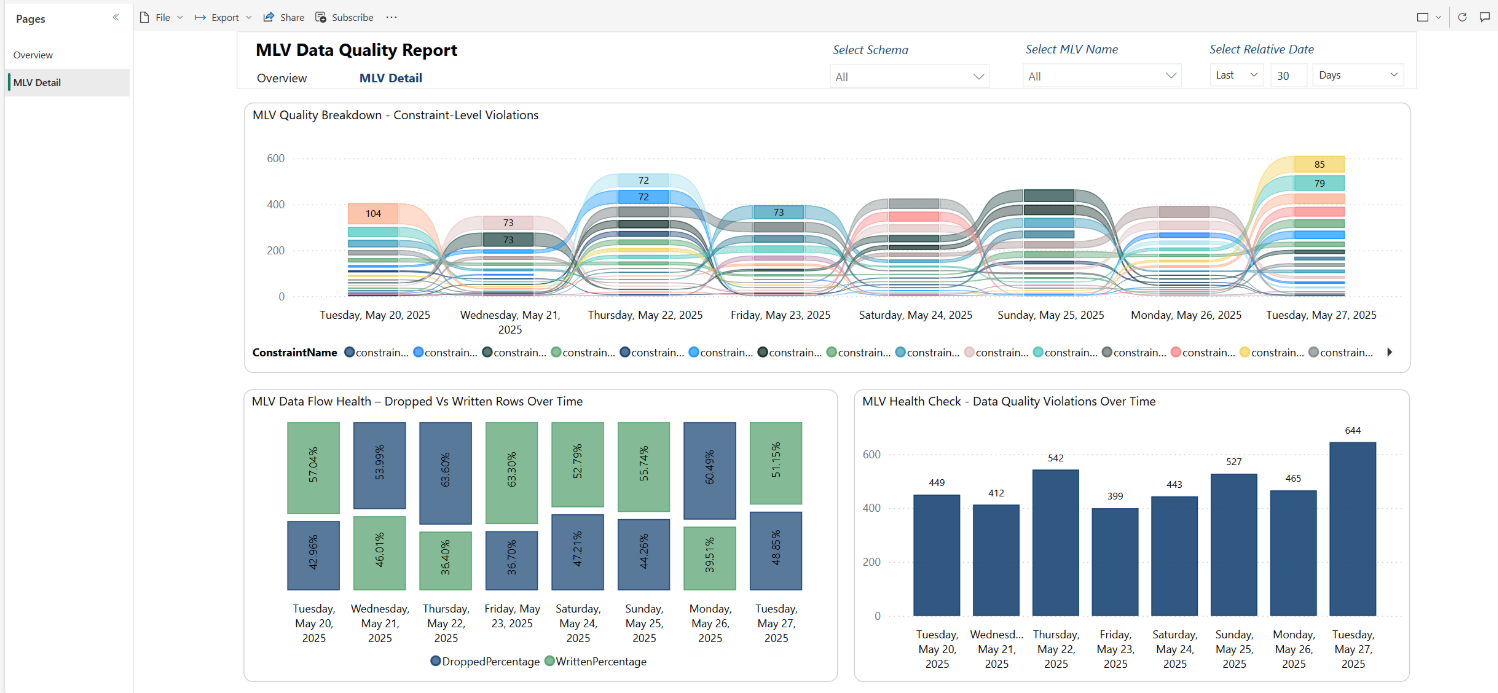
Abbildung 3. Behandle die Artefakte des Abgleichs pro Spalte als Release-Nachweis für MLV-Umstellungen, nicht als optionale Notizen im Notebook. Quelle: Microsoft Learn: MLV data quality reports.
1. Stufen der Reihe nach ausführen und bei harten Fehlern stoppen
Beginne mit Zeilenzahlen und Aktualitätsfenstern. Vergleiche dann die fachlichen Keys (Vorhandensein, Duplikate, Waisen). Erst danach kommen Spaltenaggregate und Verteilungsprüfungen. Wenn die Keys nicht übereinstimmen, lügen die Spaltensummen über den Grund. Früh zu stoppen spart Zeit für die Analyse und verhindert falsche Beruhigung durch "die Summen sehen ähnlich aus".
2. Typbewusste Vergleiche zur Pflicht machen
Decimals, Floats, Timestamps und Strings brauchen unterschiedliche Toleranzen und eine unterschiedliche Null-Semantik. Leerer String oder Null ist eine Produktentscheidung, keine Kuriosität von Spark. Leg die erwarteten Typen aus dem Vertrag fest und lass die Prüfung fehlschlagen, wenn die MLV einen anderen Typ veröffentlicht, "weil die Sortierung noch stimmte". Vergleiche von Floats brauchen ein ausdrückliches Epsilon oder eine Quantisierung auf Dezimalstellen, die du im Review verteidigen kannst.
3. Eine Checklistenzeile pro Spalte
Jede Spalte bekommt verantwortliche Person, Vergleichsmethode, Toleranz, letztes Ergebnis und Freigabe. Breite Tabellen sind dann keine Gefühlsübung mehr. Reviewer können fragen, wer das Restrisiko bei einem unscharfen Float akzeptiert hat, statt zu hoffen, dass sich jemand erinnert. Fehlende Checklistenzeilen sind unfertige Arbeit, kein optionaler Feinschliff. Abbildung 4 macht diese Zeile sichtbar.
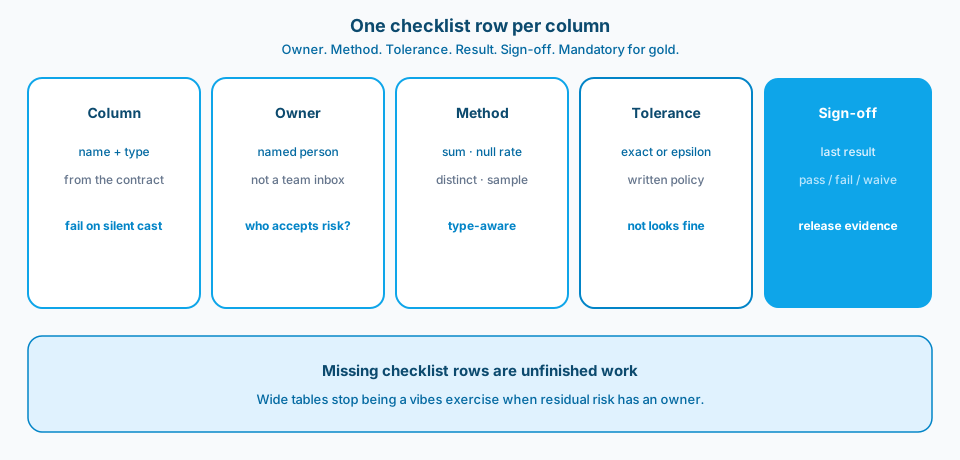
Abbildung 4. Eine Checklistenzeile pro Spalte. Verantwortliche Person, Methode, Toleranz und Freigabe machen aus dem Restrisiko etwas, das ein Reviewer benennen kann.
4. In Analyseskripten automatisieren, nicht in Foliensätzen
Notebooks oder Jobs sollten maschinenlesbare Ergebnisse liefern: bestanden oder nicht, Differenzen, Beispiel-Keys, die fehlschlagen. Menschen interpretieren Ausnahmen. Menschen sollten nicht jeden Freitag Zahlen aus zwei Abfragefenstern in Excel abtippen. Automatisierung heißt auch, dass du nach einer "winzigen" Änderung an der MLV ohne Heldentaten erneut prüfen kannst.
5. Stichproben der Abweichungen neben den Aggregaten aufbewahren
Aggregate sagen dir, dass etwas falsch ist. Stichproben sagen dir, was. Speichere pro fehlgeschlagener Spalte eine begrenzte Menge abweichender Keys für die Triage. Ohne Stichproben wird jeder Fehler zum Forschungsprojekt. Mit Stichproben siehst du den Fehler im CAST oder im Join in wenigen Minuten.
6. Validierungsartefakte als Release-Nachweis speichern
Hänge die Ergebnisse an den Release-Eintrag, so wie du die IDs der Pipeline-Läufe anhängst. Auditoren und dein zukünftiges Ich werden fragen, was am Tag der Umstellung verglichen wurde. Screenshots aus dem Chat altern schlecht. Versionierte Ergebnisdateien neben dem MLV-Notebook altern ehrlich. Abbildung 5 zeigt diesen Weg.
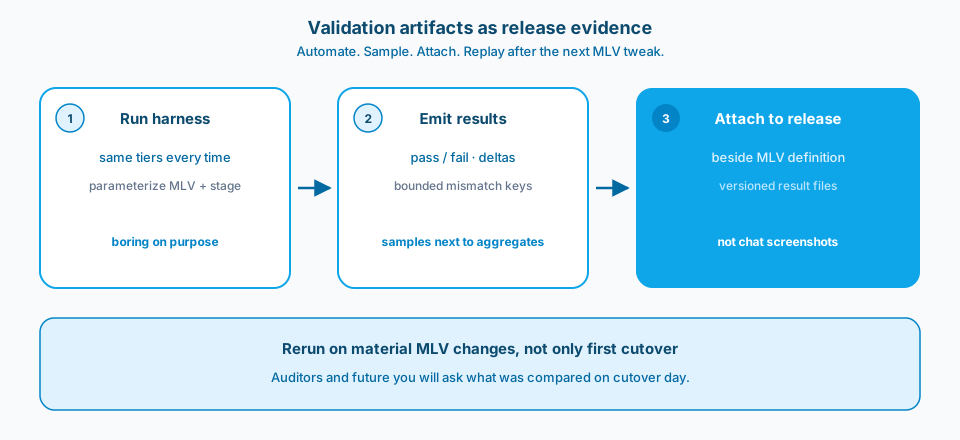
Abbildung 5. Lass das Harness laufen, gib bestanden oder nicht mit begrenzten Stichproben aus und lege die Dateien neben die MLV-Definition. Lass es erneut laufen, wenn sich die MLV ändert.
Ein Harness bauen, das die Leute wirklich ausführen
Halte das Harness langweilig: gleiche Eingabe-Snapshots, gleiche Reihenfolge der Stufen, gleiches Ausgabeschema bei jedem Lauf. Parametrisiere den Namen der MLV und die Stage. Veröffentliche eine einseitige Anleitung im Repo, damit die Bereitschaft dein Notebook vom Mai nicht rückwärts entschlüsseln muss. Wenn das Harness eine Stunde zum Starten braucht, wird es unter Termindruck übersprungen. Optimiere für Wiederholungen. Cache die Baseline-Extrakte, wenn die Warehouse-Seite teuer ist, und halte fest, welchen Baseline-Snapshot du verwendet hast, damit es im Streit um die Daten geht und nicht darum, welcher Dienstag gemeint war.
Was "nah genug" schriftlich heißen muss
Wenn zwei Dezimalsummen um eine Rundungsregel abweichen, die du akzeptierst, schreib die Regel neben die Spalte. "Sieht gut aus" ist keine Toleranz. Vergleiche lieber quantisierte Werte (zum Beispiel Decimals auf zwei Stellen), statt zu hoffen, dass sich Float-Gleichheit benimmt. Wenn eine Spalte absichtlich nicht deterministisch ist (Zeitstempel der Verarbeitung), nimm sie aus der Parität heraus oder vergleiche nur auf fachlich wirksamen Zeitpunkten. Ausnahmen sind erlaubt. Stille Ausnahmen nicht.
Häufige Fehler
Grün nur nach Zeilen. Das Volumen stimmt, die Summen nicht.
Alles in Strings umwandeln und vergleichen. Typen und Nullwerte verschwinden in zufälligen Textübereinstimmungen.
Ein riesiger Score für "Datenqualität". Niemand weiß, welche Spalte fehlgeschlagen ist oder wem die Korrektur gehört.
Manuelle Screenshot-QA. Nicht wiederholbar, nicht prüfbar, nach dem Meeting weg.
Aggregate ohne Stichproben. Endlose Debatten darüber, ob das Harness falsch ist.
Nur einmal bei der Umstellung validieren. Die Drift kommt mit der nächsten Änderung an der MLV zurück; das Harness muss wiederverwendbar sein.
So übernehmen oder anpassen
So übernehmen
- Umstellungen auf MLVs erfordern einen Abgleich in Stufen: Zeilen, Keys, Spaltenaggregate.
- Vergleichsmethoden berücksichtigen den Datentyp und haben dokumentierte Toleranzen.
- Eine Checkliste pro Spalte mit verantwortlicher Person und Freigabe ist für Gold Pflicht (und für Silver empfohlen).
- Validierungsjobs liefern maschinenlesbare Ergebnisse plus eine begrenzte Stichprobe der Abweichungen.
- Artefakte werden als Release-Nachweis neben der MLV-Definition aufbewahrt.
- Das Harness läuft bei wesentlichen Änderungen an einer MLV erneut, nicht nur bei der ersten Umstellung.
Vor dem Einsatz anpassen
Validierung auf Spaltenebene kostet Rechenleistung und Zeit für das Schreiben. Falsche Umstellungen kosten Vertrauen. Enge Toleranzen erzeugen Rauschen bei legitimen Float-Spalten; dokumentiere Epsilons pro Spalte statt einer globalen Lockerheit. Politik um die Verantwortung pro Spalte kann die Freigabe aufhalten. Dieser Stillstand ist billiger als nicht freigegebene Drift in Produktion. Automatisierte Stichproben brauchen Sorgfalt bei PII; hashe oder beschränke Spalten, die das Lakehouse verlassen.
Wichtigste Quellen: MLV data quality reports auf Microsoft Learn, dazu klassische Testmuster für den Abgleich bei Migrationen. Kombiniere die Werkzeuge der Plattform mit einem schriftlichen Spaltenvertrag, damit "grün" etwas Bestimmtes bedeutet.
Validiere Spalte für Spalte, mit Typen, verantwortlichen Personen und Artefakten, die du erneut abspielen kannst. MLV-Umstellungen sind keine Glaubensfrage mehr, sobald die Checkliste benennen kann, was gedriftet ist.