

Das Wichtigste in Kürze
- Behandle die Migration als schriftlich festgehaltene semantische Gleichwertigkeit, nicht als Dateiumzug nach Delta.
- Lege die Regeln für NULL, leere Werte und Null pro Spaltenklasse vor dem Cutover fest.
- Automatisiere Vergleiche auf den wichtigsten Tabellen mit benannten Toleranzen; Zeilenzahlen allein lügen.
- Fixiere Spark-Rebase, Zeitzone und Typ-Policy in Jobs, die Historie schreiben.
- Typisiere so früh wie praktikabel in Silver; Gold sollte nicht der erste Ort sein, an dem ein Dezimalwert entsteht.
- Nimm ein Paket aus Measures und Beziehungen in die Definition of Done auf, mit Freigabe durch Reviewer.
Tabellen in ein Lakehouse zu kopieren ist der einfache Teil. Schwierig wird es bei der Frage, ob 0 im Altsystem wirklich null bedeutete oder ein NULL war, und ob eine Abweichung von 0.01 Rundung ist oder ein Bug.
Ich behandle eine Migration als semantischen Vertrag, nicht als Dateiumzug. Niemand feiert, dass Delta existiert. Wichtig ist, dass eine bekannte Kennzahl nach vereinbarten Regeln weiterhin übereinstimmt.
Benanntes Modell: Parität als Vertrag
- Alte Semantik: was NULL, 0, leere Werte, Blanks, numerische Werte, Datumswerte, Flags, Measures und Beziehungen in Import oder DirectQuery bedeuten.
- Schriftlicher Vertrag: Regeln pro Spaltenklasse, benannte Toleranzen, fixierte Spark-Rebase- und Zeitzoneneinstellungen, frühe Typisierung in Silver und ein eingefrorenes Measure-Paket.
- Lakehouse-Semantik: Ergebnisse in Delta und Direct Lake, die ihre Gleichwertigkeit nach diesen Regeln beweisen müssen, nicht nach dem Gefühl, dass "die Zahlen ungefähr passen".
- Vertrag: Dass die Bytes angekommen sind, ist keine Abnahme. Die Bedeutung übersteht den Engine-Wechsel erst, wenn automatisierte Vergleiche und die Freigabe der Berichte das bestätigen.
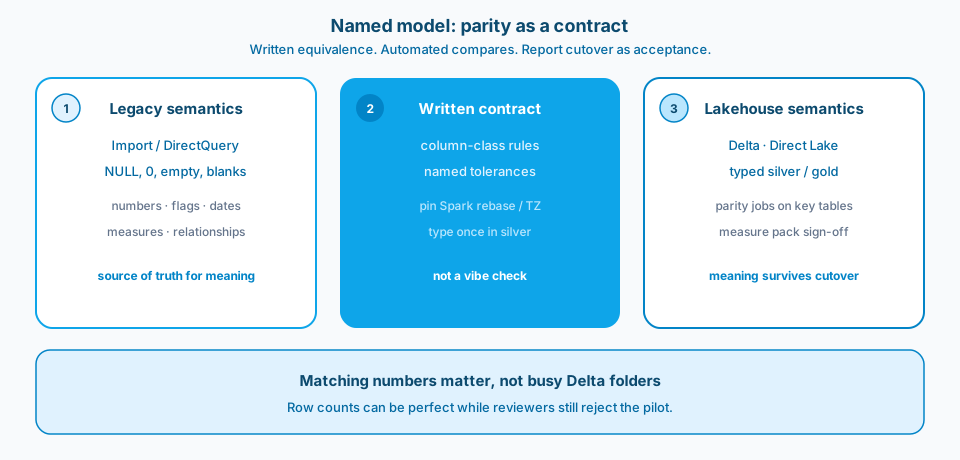
Abbildung 1. Parität als Vertrag. Alte und neue Bedeutung im Lakehouse bleiben nach schriftlichen Regeln gleichwertig. Volle Delta-Ordner sind kein Grund zum Feiern.
Kontext und Rahmenbedingung
Ein Cutover von Import und DirectQuery auf Fabric-Lakehouses kann perfekte Zeilenzahlen zeigen und im Review trotzdem abgelehnt werden. Die Bytes sind angekommen. Die Bedeutung nicht. Genau diese Lücke ist die eigentliche Migrationsarbeit.
Der Wechsel von klassischem Power BI Import oder DirectQuery zu einem Modell auf Lakehouse-Basis ändert die Engine, die NULL-Behandlung, die Typkonvertierung und oft auch die Granularität der Zwischentabellen. Wenn du nur prüfst, ob die Tabellen existieren und die Schemas vertraut aussehen, entdeckst du die Abweichungen in den Measures erst im Review-Meeting. Behandle NULL gegen 0, numerische Präzision, Datumswerte, Flags und Measures als vollwertige Vertragsklauseln, wenn die Berichte die Abnahmefläche sind.
Abbildung 2 zeigt die Learn-Seite zu Schemas und Shortcuts. Der Speicherort ändert, wo Daten erscheinen. Er beweist nicht, was die Werte bedeuten.
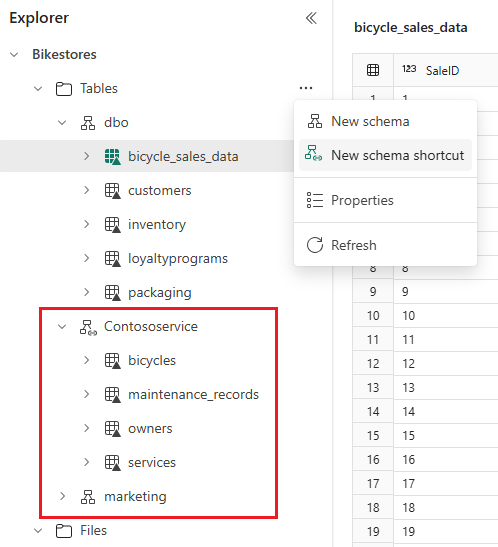
Abbildung 2. Shortcuts und Schemas ändern, wo Daten erscheinen, nicht was sie bedeuten. Quelle: Microsoft Learn: lakehouse schemas.
Design
Paritätsfehler, die in einer Demo gut aussehen
NULL gegen 0. Alte Muster, die leere Strings zu NULL machen, werden zu Integers, die 0 behalten. Counts, Durchschnitte und Joins verschieben sich. Ein Filter, der früher Unbekanntes ausgeschlossen hat, zählt Nullen jetzt als echte Werte mit. Es passiert auch umgekehrt: Ein als 0 gespeicherter fehlender Wert wird in Silver zu NULL, und die Zahl der "aktiven" Datensätze sinkt.
Float-Drift. Werte, die sich über viele Zeilen um 0.01 unterscheiden, wachsen zu Summenlücken, über die du wochenlang diskutierst. Import hat das manchmal durch Rundung beim Laden oder im Modell versteckt. Spark und Delta behalten das Float-Rauschen, solange du nicht früh Dezimaltypen und Rundung festlegst.
Datetime-Rebase-Modi. Die Spark-Einstellungen für Legacy- gegenüber korrektem Rebase ändern die Historie stillschweigend, wenn du sie nicht fixierst. Ein Zeitstempel, der in einem Beispielmonat gut aussah, bricht an historischen Sommerzeitgrenzen. Notebooks mit den Standardeinstellungen des Clusters sind keine reproduzierbaren Migrationswerkzeuge.
Einmal und früh typisieren. Wenn du erst in Gold castest, während Bronze aus Strings besteht, lernt jeder Consumer dieselben Bugs neu. DirectQuery hat die Typisierung oft der Engine überlassen; eine verzögerte Typisierung im Lakehouse erzeugt dieselbe Mehrdeutigkeit, nur mit mehr Zwischenschritten.
Measure-Drift. Selbst wenn die Spalten der Fakten übereinstimmen, kann DAX, das von der Kardinalität in Import, vom Umgang mit Blanks oder vom Verhalten der Beziehungen ausging, mit Direct Lake oder einem neu modellierten Sternschema abweichen. Parität bedeutet ETL plus den Vertrag des semantischen Modells.
Abbildung 3 ist die Zuordnung nach Spaltenklassen, die verhindert, dass jede Tabelle ihren eigenen Dialekt erfindet.
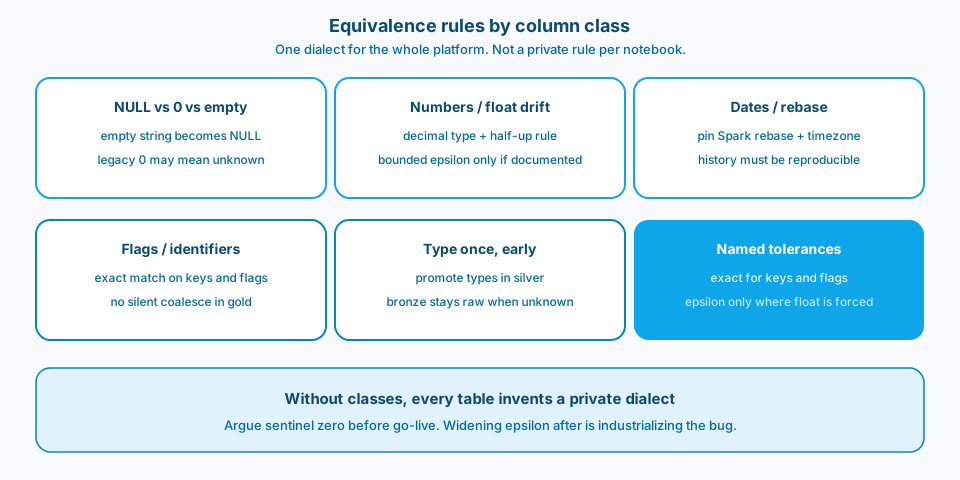
Abbildung 3. Gleichwertigkeitsregeln pro Spaltenklasse. Kläre Platzhalter-Nullen und die Float-Policy vor dem Go-live. Danach das Epsilon zu vergrößern heißt, den Bug zu industrialisieren.
1. Definiere Gleichwertigkeitsregeln pro Spaltenklasse
Schreib Regeln für numerische Werte, Mengen, Flags, leere Strings, Datumswerte und Identifier. Beispiele für Klassen: "Ein leerer String in der Quelle wird in Silver zu NULL", "eine alte 0 in einer nullbaren numerischen Spalte bedeutet unbekannt, nicht null", "ein Dezimalwert wird vor Gold kaufmännisch auf 4 Nachkommastellen gerundet". Ohne Klassen erfindet jede Tabelle ihren eigenen Dialekt.
2. Automatisiere Zeilen- und Aggregatvergleiche für die wichtigsten Tabellen
Vergleiche Schlüssel, NULL-Raten, Distinct Counts und numerische Summen zwischen den alten Extrakten und den Ergebnissen im Lakehouse. Zeilenzahlen allein lügen. Halte die Toleranzen explizit: exakt für Schlüssel und Flags, ein begrenztes Epsilon nur dort, wo Float unvermeidbar und dokumentiert ist.
3. Fixiere die Spark-Session-Einstellungen in Notebooks, bei denen die Historie zählt
Rebase-Modi, Zeitzonen und Parser-Optionen gehören in die Notebook- oder Job-Definition, nicht in die Hände von dem, der zuletzt den Cluster angefasst hat. Die Migrationshistorie muss reproduzierbar sein. Stille Änderungen an den Standardwerten sind Fehler.
4. Typisiere so früh wie praktikabel in der Lineage
Mach Dezimalwerte, Datumswerte und Booleans in Silver zu echten Typen, sobald die Regel bekannt ist. Gold sollte nicht der erste Ort sein, an dem ein Dezimalwert existiert, wenn fünf Notebooks die String-Spalte schon unterschiedlich summiert haben. Frühe Typisierung macht auch Consumer über Direct Lake und den SQL endpoint weniger überraschend.
5. Nimm Measures und Beziehungen ins Paritätspaket auf
Friere für den Cutover der Berichte eine kleine Sammlung von Vergleichen auf Seiten- und Measure-Ebene gegen einen bekannten alten Workspace ein. Dokumentiere Unterschiede bei den Beziehungen (einfach gegen beidseitig, fehlende Elemente, Verhalten der Blank-Zeile). Wenn Import eine berechnete Spalte verwendet hat, die im Lakehouse weiter nach vorne wandert, benenne diese Umstellung, damit sie nach dem Go-live niemand in DAX "zurückrepariert".
Abbildung 4 zeigt, warum eine grüne Pipeline noch kein Cutover ist. ETL-Vergleiche und das Measure-Paket sind beide Pflicht.
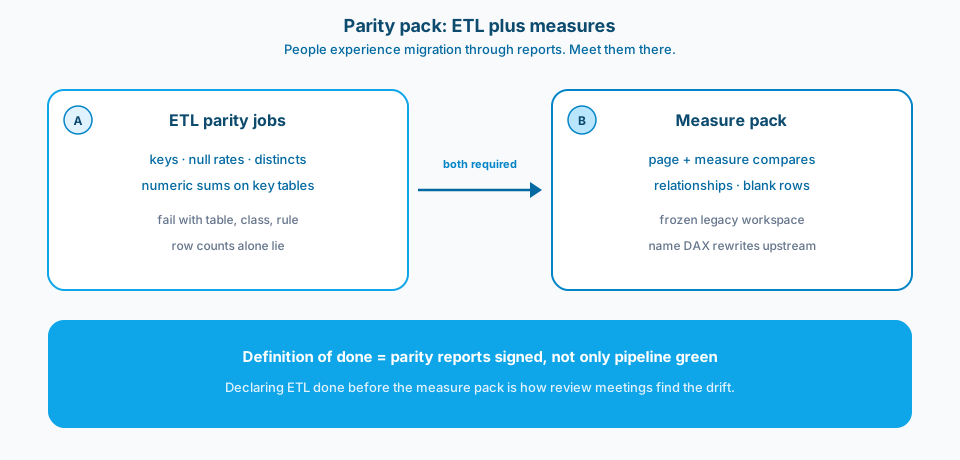
Abbildung 4. Die Definition of Done umfasst ETL-Paritätsjobs und ein von Reviewern abgezeichnetes Measure-Paket. Wer ETL zuerst für fertig erklärt, findet die Abweichung im Review-Meeting.
Abbildung 5 zeigt die Learn-Darstellung zum Verschieben von Inhalten zwischen Stages. Eine Stage-Promotion beweist keine semantische Parität.
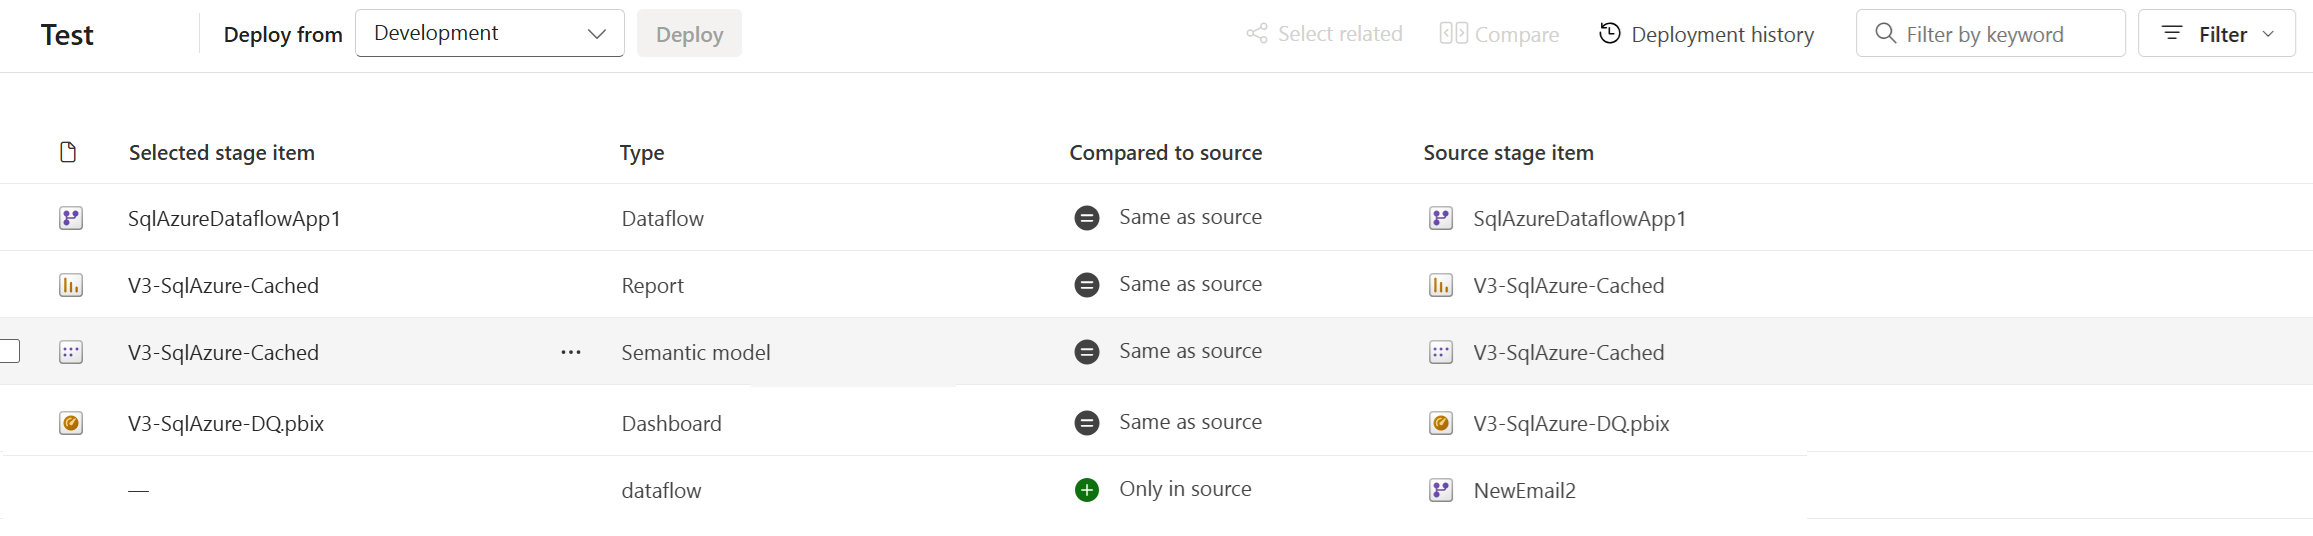
Abbildung 5. Inhalte zwischen Stages zu verschieben beweist keine semantische Parität. Quelle: Microsoft Learn: deployment pipelines.
Häufige Fehler
Die Zeilenzahlen stimmen, während numerische Spalten abweichen. Die Demo besteht. Die Freigabe scheitert.
Die Toleranz in der Validierung anpassen statt den Schreibpfad zu reparieren. Das Epsilon so lange zu vergrößern, bis alles grün ist, industrialisiert den Bug.
Eine riesige Notebook-Zelle, die verbirgt, welche Tabelle die Parität nicht bestanden hat. Fehler müssen Tabelle, Spaltenklasse und Regel nennen. Sonst wird Debugging zur Archäologie.
ETL für fertig erklären, bevor die Measure-Pakete verglichen sind. Die Leute erleben die Migration über die Berichte. Hol sie dort ab.
Annehmen, dass sich Blanks in DirectQuery wie NULL im Lakehouse verhalten. Die Engines sind sich uneinig, bis du den Vertrag durchsetzt.
Shortcuts und Schema-Umzüge gelten als bedeutungserhaltend. Der Speicherort hat sich geändert. Die Semantik muss trotzdem bewiesen werden.
So übernehmen oder anpassen
So übernehmen
- Schriftliche Regeln für NULL, leere Werte und Null pro Spaltenklasse.
- Paritätsjobs für die wichtigsten Tabellen mit benannten Toleranzen.
- Explizite Spark-Rebase-, Zeitzonen- und Typ-Policy in Jobs, die Historie schreiben.
- Wo in der Medallion-Architektur Typen erzwungen werden (Bronze bleibt roh, Silver ist typisiert).
- Ein Vergleichspaket für Measures und Beziehungen für den Cutover der Berichte.
- Eine Definition of Done, die die Freigabe der Paritätsberichte durch Reviewer einschließt, nicht nur eine grüne Pipeline.
Vor dem Einsatz anpassen
Echte Paritätsarbeit verlangsamt den ersten Cutover. Du wirst darüber streiten, ob eine alte 0 eine echte Null oder ein Platzhalter für einen fehlenden Wert war. Dieser Streit ist vor dem Go-live billiger als danach. Strenge frühe Typisierung kann schmutzige Bronze-Daten brechen, die früher "einfach" in Import geladen wurden; dieser Schmerz bringt Datenqualitätsprobleme meist ans Licht, solange du noch zurückrollen kannst. Automatisierte Vergleiche brauchen stabile alte Extrakte und Schlüssel. Ohne reproduzierbare Snapshots werden Paritätsjobs unzuverlässig, und die Leute vertrauen ihnen nicht mehr.
Wichtigste Quellen: Lakehouse schemas, Lakehouse overview und die Hinweise auf Microsoft Learn zu Direct Lake und semantic models für den Cutover von Power BI.
Lade die Dateien. Beweise NULL, Null, numerische Werte, Datumswerte und Measures nach Regeln, die du in einem Review zeigen kannst. Eine Lakehouse-Migration ist erfolgreich, wenn die Bedeutung den Engine-Wechsel übersteht, nicht wenn die Delta-Ordner voll aussehen.
Verwandte Notizen
- MLV-Datenqualität: Warum gibt es keine nativen Eindeutigkeitsprüfungen pro Spalte? (Paritätsprüfungen pro Spalte, nicht nur pro Tabelle)
- Typisierung in Bronze: Ist es eine gute Idee, alles als Strings zu laden? (jede Spalte einmal typisieren, damit die Parität weniger Überraschungen bringt)