

Puntos clave
- Trata la migración como una equivalencia semántica por escrito, no como mover archivos a Delta.
- Escribe las reglas de NULL, vacío y cero por clase de columna antes del cutover.
- Automatiza comparaciones en las tablas clave con tolerancias con nombre; el número de filas por sí solo engaña.
- Fija el rebase de Spark, la zona horaria y la política de tipos en los jobs que escriben histórico.
- Tipa lo antes que sea práctico en silver; gold no debería inventar el primer decimal.
- Incluye un paquete de medidas y relaciones en la definición de terminado, con la aprobación de los revisores.
Copiar tablas a un lakehouse es la parte fácil. Lo difícil es saber si 0 significaba cero o era un nulo en el sistema antiguo, y si una diferencia de 0.01 es redondeo o un bug.
Trato la migración como un contrato semántico, no como mover archivos. Nadie celebra que exista Delta. A la gente le importa que una cifra conocida siga cuadrando según unas reglas acordadas.
Modelo con nombre: la paridad como contrato
- Semántica antigua: qué significan en Import o DirectQuery NULL, 0, los vacíos, los blanks, los valores numéricos, las fechas, los flags, las medidas y las relaciones.
- Contrato por escrito: reglas por clase de columna, tolerancias con nombre, rebase de Spark y zona horaria fijados, tipado temprano en silver y un paquete de medidas congelado.
- Semántica del lakehouse: resultados en Delta y Direct Lake que tienen que demostrar la equivalencia según esas reglas, no según la impresión de que "los números se parecen".
- Contrato: que lleguen los bytes no es la aceptación. El significado sobrevive al cambio de motor solo cuando las comparaciones automáticas y la aprobación de los informes lo confirman.
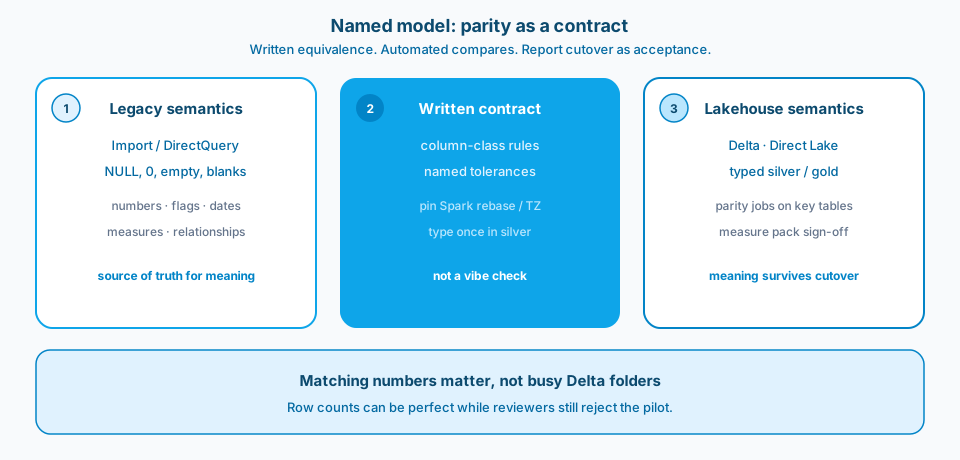
Figura 1. La paridad como contrato. El significado antiguo y el del lakehouse siguen siendo equivalentes según reglas escritas. Unas carpetas de Delta llenas no son motivo de celebración.
Contexto y restricción
Un cutover de Import y DirectQuery a lakehouses de Fabric puede mostrar un número de filas perfecto y aun así ser rechazado en la revisión. Los bytes llegaron. El significado no. Esa brecha es el verdadero trabajo de la migración.
Pasar del Import o DirectQuery clásico de Power BI a un modelo sobre un lakehouse cambia el motor, el tratamiento de los nulos, la conversión de tipos y a menudo la granularidad de las tablas intermedias. Si solo validas que las tablas existen y que los esquemas te suenan, descubrirás la deriva de las medidas en una reunión de revisión. Trata NULL frente a 0, la precisión numérica, las fechas, los flags y las medidas como cláusulas de pleno derecho del contrato cuando los informes son la superficie de aceptación.
La figura 2 es la página de Learn sobre esquemas y shortcuts. La ubicación cambia dónde aparecen los datos. No demuestra qué significan los valores.
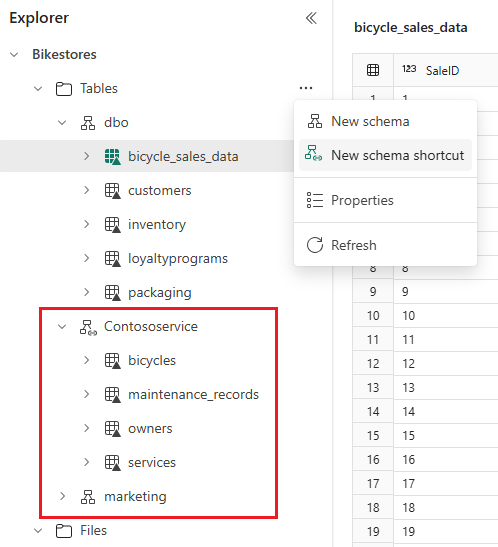
Figura 2. Los shortcuts y los esquemas cambian dónde aparecen los datos, no lo que significan. Fuente: Microsoft Learn: lakehouse schemas.
Diseño
Errores de paridad que en una demo parecen correctos
NULL frente a 0. Los patrones antiguos que convertían cadenas vacías en nulos pasan a ser enteros que conservan el 0. Los recuentos, los promedios y los joins se desplazan. Un filtro que antes excluía los desconocidos ahora incluye ceros como valores reales. También ocurre al revés: un valor ausente guardado como 0 se convierte en NULL en silver y los recuentos de "activos" bajan.
Deriva de float. Valores que difieren en 0.01 a lo largo de muchas filas se convierten en diferencias en las sumas que discutirás durante semanas. Import a veces lo ocultaba con el redondeo en la carga o en el modelo. Spark y Delta conservan el ruido del float a menos que decidas pronto los tipos decimales y el redondeo.
Modos de rebase de fechas. Los ajustes de Spark para el rebase legacy frente al correcto cambian el histórico en silencio si no los fijas. Una marca de tiempo que parecía correcta en un mes de muestra se rompe en los cambios de horario de verano históricos. Los notebooks con los valores por defecto del clúster no son herramientas de migración reproducibles.
Tipa una vez y pronto. Si haces los casts en gold mientras bronze sigue siendo todo cadenas, cada consumidor vuelve a aprender los mismos bugs. DirectQuery solía delegar el tipado al motor; retrasar el tipado en el lakehouse recrea esa ambigüedad con más saltos.
Deriva de las medidas. Aunque las columnas de los hechos coincidan, el DAX que daba por hecha la cardinalidad de Import, el tratamiento de los blanks o el comportamiento de las relaciones puede no coincidir con Direct Lake o con una estrella remodelada. La paridad es ETL más el contrato del modelo semántico.
La figura 3 es el mapa por clases de columna que evita que cada tabla invente su propio dialecto.
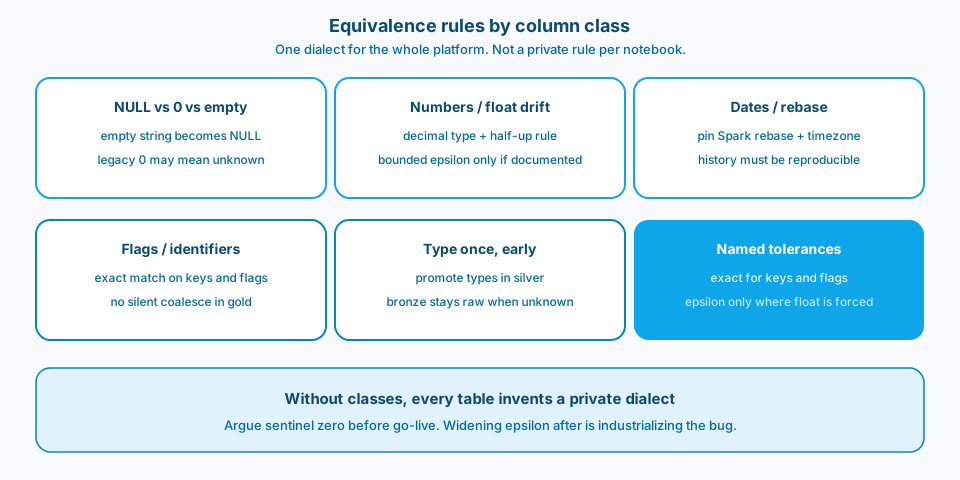
Figura 3. Reglas de equivalencia por clase de columna. Discute los ceros centinela y la política de float antes de la puesta en producción. Ampliar el epsilon después es industrializar el bug.
1. Define reglas de equivalencia por clase de columna
Escribe reglas para valores numéricos, cantidades, flags, cadenas vacías, fechas e identificadores. Ejemplos de clases: "una cadena vacía en el origen pasa a NULL en silver", "un 0 antiguo en una columna numérica que admite nulos significa desconocido, no cero", "un valor decimal se redondea a 4 decimales, con la mitad hacia arriba, antes de gold". Sin clases, cada tabla inventa su propio dialecto.
2. Automatiza comparaciones de filas y agregados para las tablas clave
Compara claves, tasas de nulos, recuentos de distintos y sumas numéricas entre los extractos antiguos y los resultados del lakehouse. El número de filas por sí solo engaña. Haz explícitas las tolerancias: exactas para claves y flags, y un epsilon acotado solo donde el float sea inevitable y esté documentado.
3. Fija los ajustes de la sesión de Spark en los notebooks sensibles al histórico
Los modos de rebase, las zonas horarias y las opciones del parser van en la definición del notebook o del job, no en manos de quien tocó el clúster por última vez. El histórico de la migración tiene que ser reproducible. Los cambios silenciosos de los valores por defecto son defectos.
4. Tipa lo antes que sea práctico en el linaje
Convierte decimales, fechas y booleanos en silver en cuanto conozcas la regla. Gold no debería ser el primer sitio donde existe un decimal si cinco notebooks ya sumaron la columna de texto de formas distintas. El tipado temprano también hace que los consumidores de Direct Lake y del SQL endpoint den menos sorpresas.
5. Incluye las medidas y las relaciones en el paquete de paridad
Para el cutover de informes, congela un pequeño conjunto de comparaciones a nivel de página y de medida contra un workspace antiguo conocido. Documenta las diferencias en las relaciones (simple frente a bidireccional, miembros ausentes, comportamiento de la fila en blanco). Si Import usaba una columna calculada que en el lakehouse se mueve aguas arriba, ponle nombre a ese cambio para que nadie lo "arregle" de vuelta en DAX después de la puesta en producción.
La figura 4 explica por qué un pipeline en verde no es un cutover. Hacen falta tanto las comparaciones de ETL como el paquete de medidas.
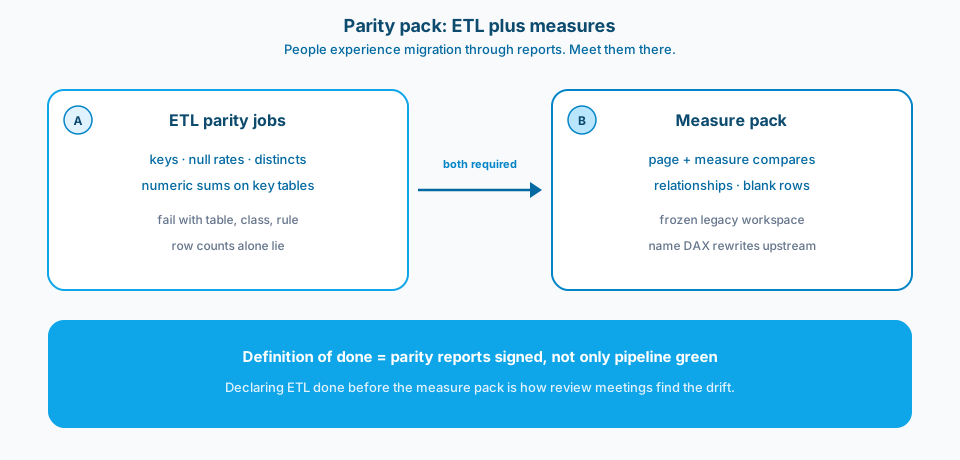
Figura 4. La definición de terminado incluye jobs de paridad de ETL y un paquete de medidas firmado por los revisores. Declarar terminado el ETL primero es como las reuniones de revisión acaban encontrando la deriva.
La figura 5 es el planteamiento de Learn para mover contenido entre stages. Promover entre stages no demuestra la paridad semántica.
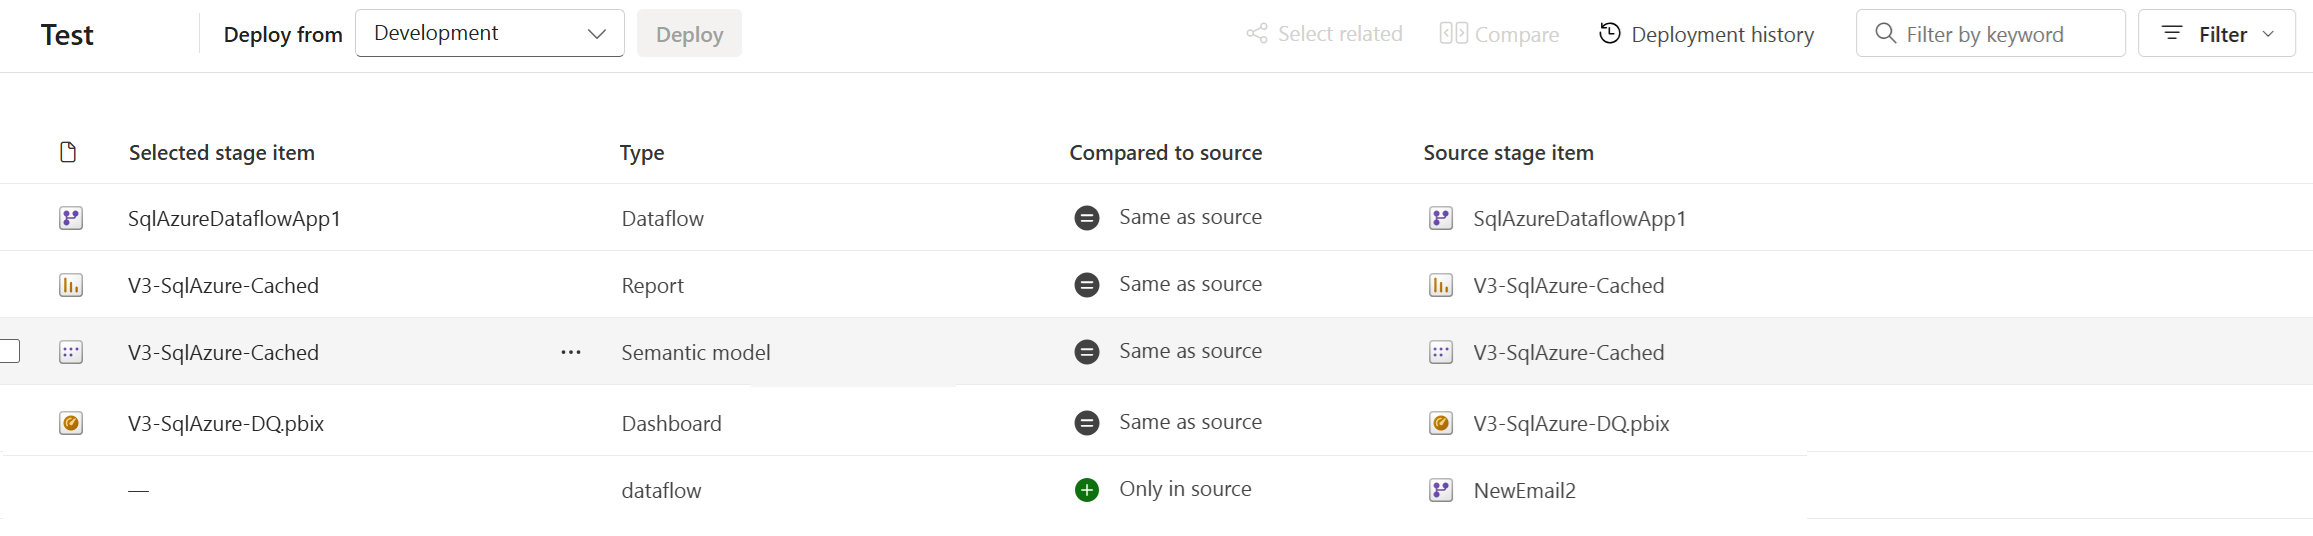
Figura 5. Mover contenido entre stages no demuestra la paridad semántica. Fuente: Microsoft Learn: deployment pipelines.
Errores comunes
El número de filas coincide mientras las columnas numéricas derivan. La demo pasa. La aprobación te suspende.
Ajustar la tolerancia en la validación en lugar de arreglar la escritura. Ampliar el epsilon hasta que todo salga en verde es cómo industrializas el bug.
Una celda de notebook gigante que oculta qué tabla no superó la paridad. Los fallos tienen que nombrar la tabla, la clase de columna y la regla. Si no, depurar se convierte en arqueología.
Declarar terminado el ETL antes de comparar los paquetes de medidas. La gente vive la migración a través de los informes. Ve a buscarla allí.
Suponer que los blanks de DirectQuery se comportan igual que los NULL del lakehouse. Los motores no coinciden hasta que impones el contrato.
Tratar los shortcuts y los movimientos de esquema como si conservaran el significado. La ubicación cambió. La semántica sigue necesitando una prueba.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Reglas por escrito de NULL, vacío y cero por clase de columna.
- Jobs de paridad para las tablas clave con tolerancias con nombre.
- Política explícita de rebase de Spark, zona horaria y tipos en los jobs que escriben histórico.
- Dónde se imponen los tipos en el medallion (bronze se queda en bruto frente a silver tipado).
- Un paquete de comparación de medidas y relaciones para el cutover de informes.
- Una definición de terminado que incluye la aprobación de los informes de paridad por los revisores, no solo un pipeline en verde.
Adáptalo antes de usarlo
Un trabajo de paridad real ralentiza el primer cutover. Discutirás si un 0 antiguo era un cero real o un centinela de valor ausente. Esa discusión sale más barata antes de la puesta en producción que después. Un tipado estricto y temprano puede romper datos sucios de bronze que antes "simplemente cargaban" en Import; ese dolor suele sacar a la luz problemas de calidad de datos mientras aún puedes hacer rollback. Las comparaciones automáticas necesitan extractos y claves antiguos estables. Sin snapshots reproducibles, los jobs de paridad se vuelven inestables y la gente deja de confiar en ellos.
Referencias principales: Lakehouse schemas, Lakehouse overview, y la guía de Microsoft Learn sobre Direct Lake y los semantic models para los cutovers de Power BI.
Carga los archivos. Demuestra NULL, cero, valores numéricos, fechas y medidas según reglas que puedas mostrar en una revisión. Una migración a lakehouse tiene éxito cuando el significado sobrevive al cambio de motor, no cuando las carpetas de Delta parecen llenas.
Relacionado
- Calidad de datos en MLV: ¿por qué no hay comprobaciones nativas de unicidad por columna? (comprobaciones de paridad por columna, no solo por tabla)
- Tipado en bronze: ¿es buena idea ingerir todo como cadenas? (tipar cada columna una sola vez para que la paridad dé menos sorpresas)