

Das Wichtigste in Kürze
- Der SQL analytics endpoint und Spark haben alle 7 Abfrageformen bei jedem Lauf beantwortet (jeweils 161 von 161). Der schlechteste kalte Lauf des Endpoints lag bei 37.8 s. Spark braucht zuerst einen Sitzungsstart von etwa drei Minuten.
- Direct Lake war warm bei den meisten Formen am schnellsten, mit etwa 0.6 bis 0.8 s. Der erste erfolgreiche Ladevorgang dauerte aber 40 bis 170 s, und bei 4 von 7 Formen scheiterte jeder kalte Lauf.
- Eventhouse gewann den Point Lookup (0.011 s Engine-Zeit) und war bei Joins am langsamsten (216 bis 248 s).
- Direct Lake hat für dieselben 7 Abfragen mehr als das 10-Fache der CU des SQL analytics endpoints verbraucht.
- Gemessen auf einem Fabric Trial mit 64 CU und synthetischen, von TPC-H abgeleiteten Daten. Keine Aussage über ein bezahltes F64 oder Produktion.
Eine Delta-Tabelle mit einer Milliarde Zeilen, vier Engines, die sie abfragen können, und eine Frage: Welche Engine sollen das Dashboard, der Analyst und der nächtliche Job verwenden? Das ist der dritte Beitrag meiner Serie zum Fabric Trial. Um es herauszufinden, habe ich dieselben sieben Abfragen auf Spark, dem SQL analytics endpoint, einem semantischen Modell mit Direct Lake und einem Eventhouse ausgeführt, kalt und warm.
Welche Fabric Engine solltest du für eine Abfrage über eine Milliarde Zeilen verwenden?
Bei etwa einer Milliarde Zeilen auf einem Fabric Trial mit 64 CU war der SQL analytics endpoint die sichere Standardwahl: Er hat alle sieben Abfrageformen bei jedem Lauf beantwortet, warm in 0.2 bis 8.5 s Engine-Zeit und kalt in höchstens 37.8 s beim Aufrufer. Direct Lake war warm die schnellste Engine für Aggregate, mit etwa 0.6 bis 0.8 s, brauchte aber 40 bis 170 s für den ersten erfolgreichen Ladevorgang und scheiterte bei vier der sieben Formen an jedem kalten Lauf. Eventhouse war beim Point Lookup am schnellsten (0.011 s Engine-Zeit) und bei Joins am langsamsten. Wähle nach Abfrageform und danach, wie warm die Engine sein wird, nicht nach einem einzigen Gesamtsieger.
Ergebnisse: warmer Median, Sekunden
| Abfrageform | Spark | SQL endpoint | Direct Lake | Eventhouse |
|---|---|---|---|---|
| q1 Point Lookup | 0.874 | 1.046 | 0.690 | 0.329 |
| q2 ein Monat, gefiltertes Aggregat | 4.159 | 1.521 | 0.633 | 4.820 |
| q3 Group by Versandart | 17.544 | 1.312 | 0.677 | 59.151 |
| q4 zwei Joins | 47.079 | 9.489 | 0.674 | nicht ausgeführt |
| q5 ein Join | 39.564 | 5.912 | 0.657 | 215.505 |
| q6a Top 100 Zeilen | 15.093 | 1.988 | jeder Lauf gescheitert | nicht gemessen |
| q6b Top 5 Marken pro Versandart | 48.730 | 7.112 | 0.796 | 247.757 |
Zeit beim Aufrufer, Median der warmen Läufe, die bestanden haben. Bei Direct Lake q2 und q4 sind Läufe ausgelassen, die durch Throttling verzögert wurden. Eventhouse hat kein q4 (keine Kopie von orders oder customer), und q6a wurde wegen eines Fehlers in meinem Harness nicht gemessen.
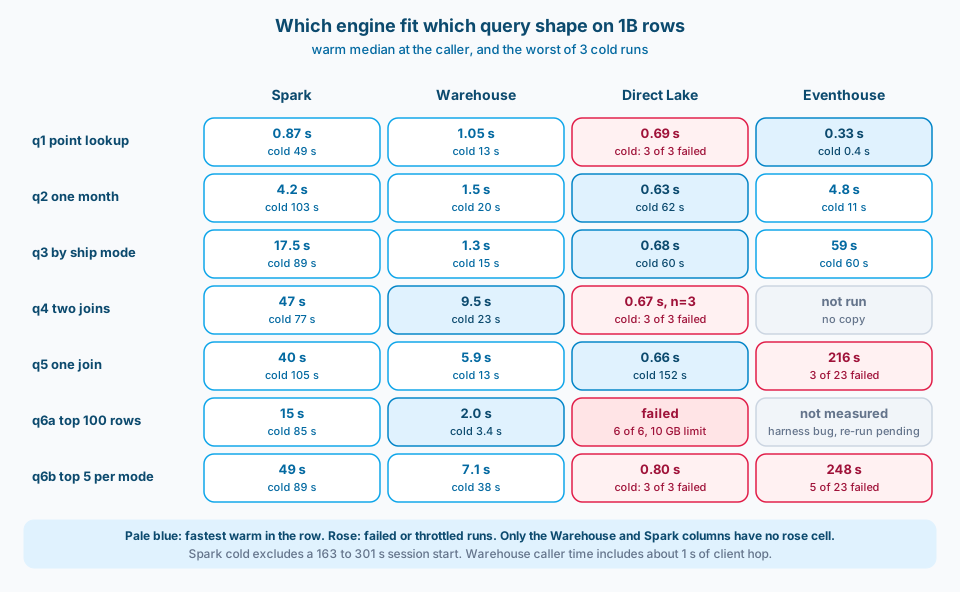
Abbildung 1. Warm ist Direct Lake bei den meisten Formen am schnellsten. Kalt ist es die Engine, die am ehesten scheitert, und der SQL analytics endpoint und Spark haben keine roten Zellen.
Kalt ändert sich das Bild:
- Direct Lake muss zuerst Spalten aus OneLake laden. Das dauerte 60 s für die Aggregate über eine Tabelle und 151 s für den Join auf part. Bei vier Formen scheiterte der kalte Ladevorgang nach zwei bis vier Minuten.
- Die zeilenbasierte Top 100 (q6a) scheiterte bei Direct Lake in 6 von 6 Läufen, kalt und warm, am Speicherlimit von 10 GB pro Abfrage (Power BI Kapazitäts-SKUs). Der SQL analytics endpoint beantwortete sie in etwa 1 s Engine-Zeit.
- Spark zahlt beim Sitzungsstart: 163 bis 301 s für eine neue Sitzung auf einem Custom Pool, dann im Median 40 bis 87 s für die erste Abfrage.
- Eventhouse scheiterte bei den Joins in 8 Läufen, wegen zu wenig Speicher oder weil es 1 Zeile mit HTTP 200 zurückgab. Prüf die Zeilenzahl, nicht den Statuscode.
So wählst du
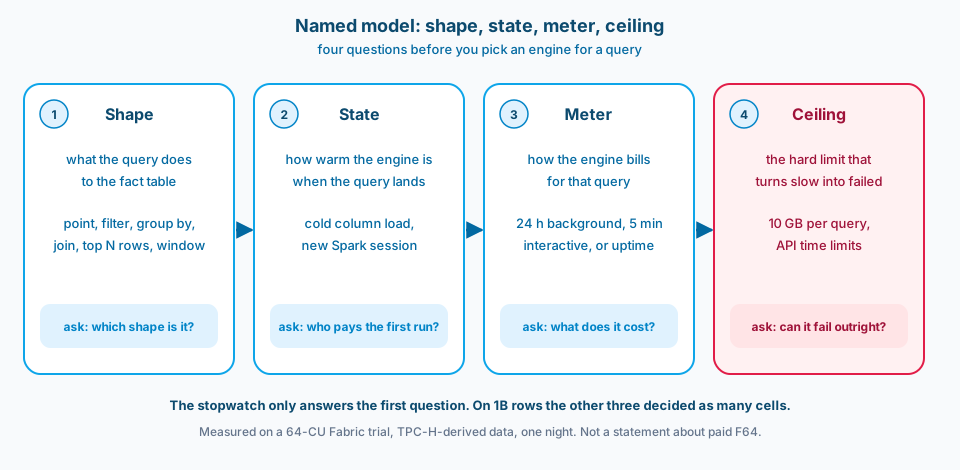
Abbildung 2. Tempo ist nur eine von vier Fragen. In diesem Lauf haben Zustand, Zähler und Obergrenze genauso viele Zellen entschieden wie die Stoppuhr.
| Wenn die Abfrage | Wähle | Warum |
|---|---|---|
| unvorhersehbar ist oder die Engine nicht warm sein wird | SQL analytics endpoint | Keine gescheiterten Läufe, schlechtester kalter Lauf 37.8 s |
| ein wiederholtes Aggregat auf einem Modell ist, das warm bleibt | Direct Lake | Warm etwa 0.6 bis 0.8 s |
| eine zeilenbasierte Top N über die ganze Faktentabelle ist | Nicht Direct Lake | Jeder Lauf traf das Limit von 10 GB pro Abfrage |
| ein Lookup auf einer Tabelle ist | Eventhouse | 0.011 s Engine-Zeit |
| ein Join zwischen großen Tabellen ist | Nicht Eventhouse | 216 bis 248 s, und Läufe scheiterten |
| ein nächtlicher Job ist | Spark ist in Ordnung | Ein Sitzungsstart von etwa drei Minuten spielt einmal pro Nacht keine Rolle |
Was es gekostet hat
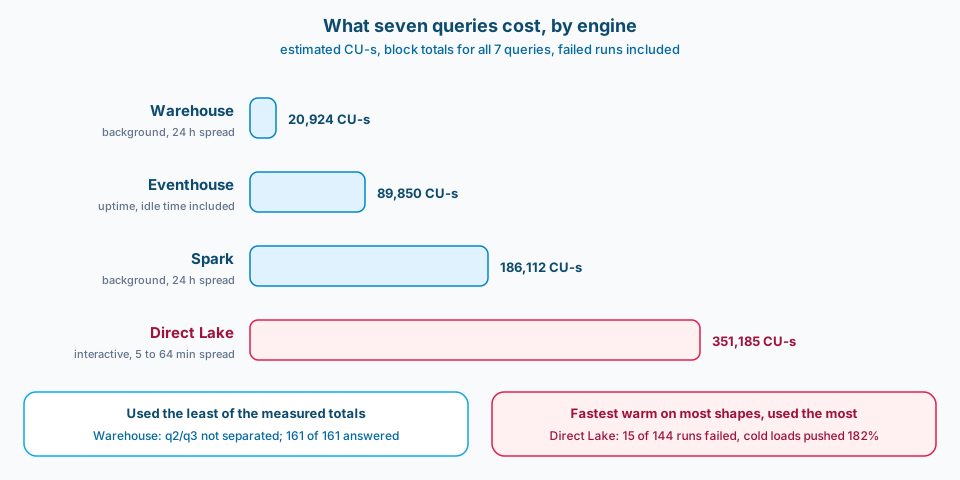
Abbildung 3. Sekunden und CU-s ordnen die Engines unterschiedlich: Die Engine, die warm bei den meisten Formen am schnellsten war, hat die meiste Kapazität verbraucht.
Über dieselben sieben Abfragen hat Direct Lake mehr als das 10-Fache der CU des SQL analytics endpoints verbraucht (etwa das 13-Fache, das 17-Fache mit gescheiterten und abgelaufenen Läufen). Vieles davon ging auf kalte Ladevorgänge, auch auf die gescheiterten: Der Block q6a, sechs Läufe, die alle scheiterten und nichts zurückgaben, verbrauchte trotzdem 67,871 CU-s und trieb das Trial auf 182%.
Auch der Zähler spielt eine Rolle. Arbeit in SQL und Spark läuft im Hintergrund und wird über 24 Stunden geglättet. Direct Lake Abfragen aus einer App sind interaktiv und werden über nur 5 Minuten geglättet, sodass ein paar schwere kalte Ladevorgänge die Kapazität innerhalb von Minuten drosseln können (Throttling). Das ist hier zweimal passiert. Für ein Dashboard, das warm bleibt, zahlst du den kalten Ladevorgang einmal. Für Abfragen, die kommen, nachdem das Modell wieder kalt geworden ist, zahlst du ihn jedes Mal.
Was ich getestet habe
- Etwa eine Milliarde Zeilen: von TPC-H abgeleitete Tabellen mit etwa Skalierungsfaktor 170, in Spark mit festem Seed erzeugt. Synthetische Daten, nicht das offizielle Tool dbgen.
- Ein Fabric Trial mit 64 CU. Spark, der SQL analytics endpoint und Direct Lake lasen dieselben Delta-Tabellen. Eventhouse bekam eine eigene Kopie der Faktentabelle und von part.
- Sieben Abfrageformen mit derselben Absicht in der jeweils eigenen Sprache der Engine: Point Lookup, gefiltertes Aggregat, Group by, ein Join, zwei Joins, zeilenbasierte Top 100 und Join plus Window.
- Jede Kombination aus Engine und Abfrage lief 3 kalte und dann 20 warme Läufe, ein Block nach dem anderen in gemischter Reihenfolge. Eine Nacht (30. bis 31. Oktober 2026), eine Kapazität, ein Datensatz.
Grenzen
- Ein Trial ist kein bezahltes F64. Es hat dieselbe Glättung und dieselben Power BI Limits, aber kein Autoscale, keine Abrechnung von Überschreitungen und keinen Spark Burst.
- Kalt ist nicht überall dasselbe. Die Caches von SQL endpoint und Eventhouse lassen sich nicht leeren, dort heißt kalt also erster Lauf. Kalte Läufe in Spark lassen den Sitzungsstart aus.
- Die Zeiten sind die Wartezeit beim Aufrufer und enthalten daher den Netzwerk-Hop des jeweiligen Clients.
- Die Werte in CU-s sind meine Schätzungen aus den Auslastungsereignissen der Kapazität, als Blocksummen. Es sind keine Werte aus der Capacity Metrics app.
Hinweise zur Methode
- Ein Lauf zählt als gescheitert, wenn er einen Fehler oder die falsche Zeilenzahl zurückgab, auch mit HTTP 200. Gescheiterte Läufe werden gezählt, nie in Mittelwerte eingerechnet.
- Direct Lake Läufe, die durch Throttling verzögert wurden (jeweils pauschal 20.7 s), sind aus den warmen Medianen ausgelassen und wurden nicht wiederholt. Direct Lake q4 hat 3 saubere warme Läufe.
- Nach Engine-Zeit brauchte der SQL analytics endpoint bei q1 bis q3 0.175 bis 0.462 s. Lies diese Werte gegenüber Direct Lake also als Gleichstand.
- Die CU-Summe des SQL analytics endpoints lässt q2 und q3 aus, deren Abrechnungsschritt ich nicht trennen konnte.
- Spark lief auf einem festen Pool aus 8 Medium Nodes, 64 der 128 vCores des Trials, bei jedem Lauf gleich.
Verwandte Notizen
- Microsoft Fabric Serie (alle Fabric-Beiträge, einschließlich der Trial-Experimente)
- Fabric Mirroring Lag: Wohin die Minuten gehen (Trial-Serie 1: dieselbe Trial-Kapazität, gemessen wird Frische statt Tempo)
- Fabric Data Agents: Was eine Baseline mit 20 Fragen zeigt (dasselbe von TPC-H abgeleitete Schema in kleinem Maßstab, in normaler Sprache gefragt)
- Gold + Direct Lake: Direct Lake oder Import für große Faktentabellen? (die Modellierungsseite, wenn eine große Faktentabelle hinter Direct Lake liegt)
Wenn du nur eine Gewohnheit änderst, dann diese: Miss deine Abfrage kalt und warm, auf der Engine und dem Client, die deine Nutzer tatsächlich treffen, und zähl die Läufe, die scheitern.