

Puntos clave
- El SQL analytics endpoint y Spark respondieron a las 7 formas de consulta en todas las ejecuciones (161 de 161 cada uno). La peor ejecución en frío del endpoint fue de 37.8 s. Spark necesita antes un arranque de sesión de unos tres minutos.
- Direct Lake fue el más rápido en caliente en la mayoría de las formas, con unos 0.6 a 0.8 s. Pero su primera carga correcta tardó entre 40 y 170 s, y falló en todas las ejecuciones en frío de 4 de las 7 formas.
- Eventhouse ganó en la búsqueda puntual (0.011 s de tiempo de motor) y fue el más lento en los joins (216 a 248 s).
- Direct Lake consumió más de 10 veces las CU del SQL analytics endpoint para las mismas 7 consultas.
- Medido en una prueba de Fabric de 64 CU con datos sintéticos derivados de TPC-H. No es una afirmación sobre una F64 de pago ni sobre producción.
Una tabla Delta con mil millones de filas, cuatro motores que pueden consultarla y una pregunta: ¿qué motor deberían usar el dashboard, el analista y el job nocturno? Este es el tercer post de mi serie sobre la prueba de Fabric. Para averiguarlo, ejecuté las mismas siete consultas en Spark, el SQL analytics endpoint, un modelo semántico Direct Lake y un Eventhouse, en frío y en caliente.
¿Qué motor de Fabric deberías usar para una consulta sobre mil millones de filas?
Con unos mil millones de filas en una prueba de Fabric de 64 CU, el SQL analytics endpoint fue la opción segura por defecto: respondió a las siete formas de consulta en todas las ejecuciones, en 0.2 a 8.5 s de tiempo de motor en caliente y como mucho 37.8 s en frío desde el cliente. Direct Lake fue el motor más rápido en caliente para agregados, con unos 0.6 a 0.8 s, pero necesitó entre 40 y 170 s para su primera carga correcta y falló en todas las ejecuciones en frío de cuatro de las siete formas. Eventhouse fue el más rápido en una búsqueda puntual (0.011 s de tiempo de motor) y el más lento en los joins. Elige según la forma de la consulta y lo caliente que vaya a estar el motor, no por un único ganador global.
Resultados: mediana en caliente, segundos
| Forma de consulta | Spark | SQL endpoint | Direct Lake | Eventhouse |
|---|---|---|---|---|
| q1 búsqueda puntual | 0.874 | 1.046 | 0.690 | 0.329 |
| q2 un mes, agregado filtrado | 4.159 | 1.521 | 0.633 | 4.820 |
| q3 group by por modo de envío | 17.544 | 1.312 | 0.677 | 59.151 |
| q4 dos joins | 47.079 | 9.489 | 0.674 | no ejecutada |
| q5 un join | 39.564 | 5.912 | 0.657 | 215.505 |
| q6a top 100 filas | 15.093 | 1.988 | falló en todas las ejecuciones | no medida |
| q6b top 5 marcas por modo de envío | 48.730 | 7.112 | 0.796 | 247.757 |
Tiempo en el cliente, mediana de las ejecuciones en caliente que pasaron. En Direct Lake q2 y q4 se excluyen las ejecuciones retrasadas por throttling. Eventhouse no tiene q4 (no hay copia de orders ni de customer), y q6a no se midió por un bug en mi harness.
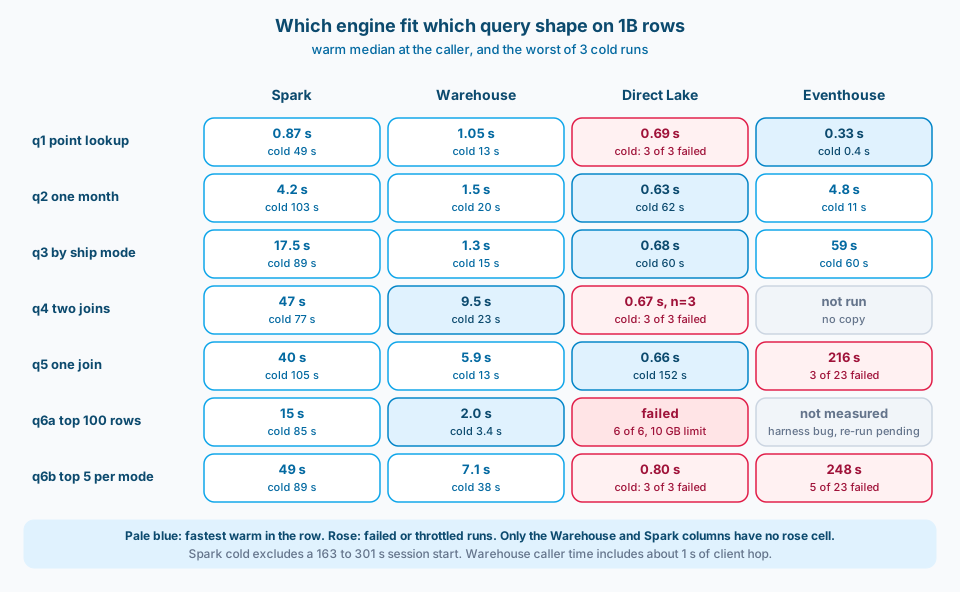
Figura 1. En caliente, Direct Lake es el más rápido en la mayoría de las formas. En frío, es el motor con más probabilidades de fallar, y el SQL analytics endpoint y Spark no tienen celdas en rojo.
En frío es donde cambia el panorama:
- Direct Lake tiene que cargar primero las columnas desde OneLake. Eso tardó 60 s en los agregados sobre una tabla y 151 s en el join con part. En cuatro formas, la carga en frío falló después de dos a cuatro minutos.
- El top 100 a nivel de fila (q6a) falló en 6 de 6 ejecuciones en Direct Lake, en frío y en caliente, al llegar al límite de memoria de 10 GB por consulta (SKU de capacidad de Power BI). El SQL analytics endpoint la respondió en alrededor de 1 s de tiempo de motor.
- Spark paga en el arranque de la sesión: de 163 a 301 s para una sesión nueva en un pool personalizado y después una mediana de 40 a 87 s para la primera consulta.
- Eventhouse falló 8 ejecuciones en los joins, por falta de memoria o devolviendo 1 fila con HTTP 200. Comprueba el número de filas, no el código de estado.
Cómo elegir
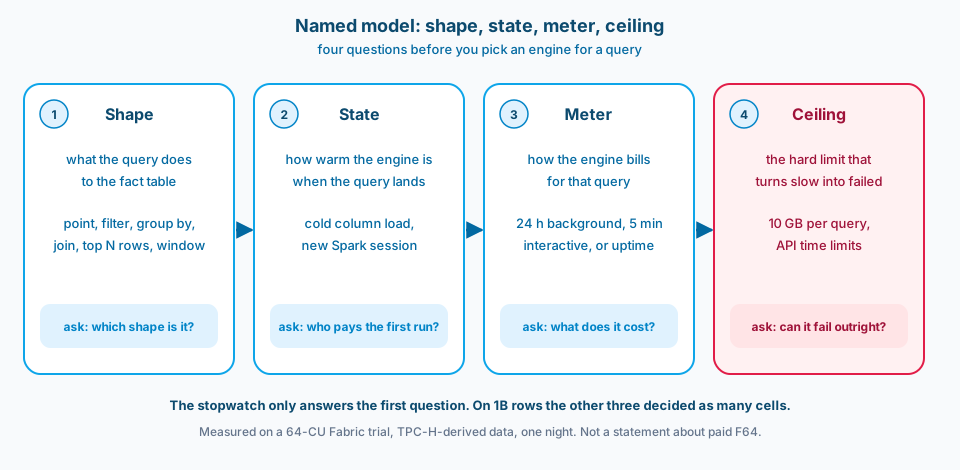
Figura 2. La velocidad es solo una de cuatro preguntas. En esta ejecución, el estado, el contador y el límite decidieron tantas celdas como el cronómetro.
| Si la consulta es | Elige | Por qué |
|---|---|---|
| Impredecible, o el motor no va a estar caliente | SQL analytics endpoint | Ninguna ejecución fallida, peor ejecución en frío 37.8 s |
| Un agregado repetido sobre un modelo que se mantiene caliente | Direct Lake | Unos 0.6 a 0.8 s en caliente |
| Un top N a nivel de fila sobre toda la tabla de hechos | No Direct Lake | Todas las ejecuciones llegaron al límite de 10 GB por consulta |
| Una búsqueda sobre una tabla | Eventhouse | 0.011 s de tiempo de motor |
| Un join entre tablas grandes | No Eventhouse | De 216 a 248 s, y hubo ejecuciones fallidas |
| Un job nocturno | Spark está bien | Un arranque de sesión de unos tres minutos no importa una vez por noche |
Lo que costó
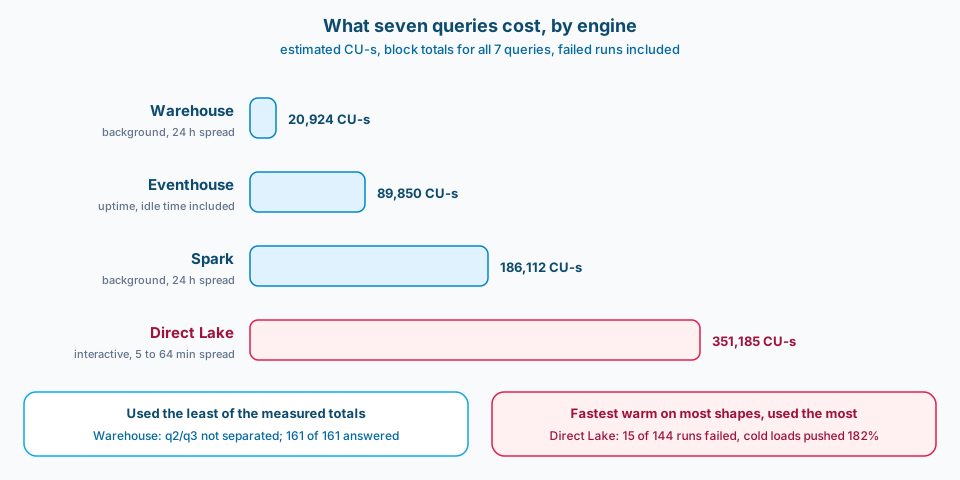
Figura 3. Los segundos y los CU-s ordenan los motores de forma distinta: el motor más rápido en caliente en la mayoría de las formas fue el que más capacidad consumió.
Con las mismas siete consultas, Direct Lake consumió más de 10 veces las CU del SQL analytics endpoint (unas 13 veces, 17 contando las ejecuciones fallidas y las que agotaron el tiempo). Gran parte se fue en cargas en frío, incluidas las que fallaron: el bloque q6a, seis ejecuciones que fallaron todas y no devolvieron nada, consumió aun así 67,871 CU-s y llevó la prueba al 182%.
El contador también importa. El trabajo de SQL y de Spark es de fondo y se suaviza a lo largo de 24 horas. Las consultas de Direct Lake desde una app son interactivas y se suavizan en tan solo 5 minutos, así que unas pocas cargas en frío pesadas pueden estrangular la capacidad en minutos (throttling). Aquí pasó dos veces. Con un dashboard que se mantiene caliente, pagas la carga en frío una vez. Con consultas que llegan cuando el modelo ya se ha enfriado, la pagas cada vez.
Qué probé
- Unos mil millones de filas: tablas derivadas de TPC-H con un factor de escala de unos 170, generadas en Spark con una semilla fija. Datos sintéticos, no la herramienta oficial dbgen.
- Una prueba de Fabric de 64 CU. Spark, el SQL analytics endpoint y Direct Lake leyeron las mismas tablas Delta. Eventhouse recibió su propia copia de la tabla de hechos y de part.
- Siete formas de consulta, con la misma intención en el lenguaje propio de cada motor: búsqueda puntual, agregado filtrado, group by, un join, dos joins, top 100 a nivel de fila y un join con ventana.
- Cada combinación de motor y consulta tuvo 3 ejecuciones en frío y después 20 en caliente, un bloque cada vez en orden aleatorio. Una noche (del 30 al 31 de octubre de 2026), una capacidad, un conjunto de datos.
Límites
- Una prueba no es una F64 de pago. Tiene el mismo suavizado y los mismos límites de Power BI, pero no tiene autoescalado, ni facturación por exceso, ni burst de Spark.
- En frío no significa lo mismo en todas partes. Las cachés del SQL endpoint y de Eventhouse no se pueden vaciar, así que ahí en frío significa primera ejecución. Las ejecuciones en frío de Spark excluyen el arranque de la sesión.
- Los tiempos son lo que esperó el cliente, así que incluyen el salto de red de cada cliente.
- Las cifras de CU-s son mis estimaciones a partir de los eventos de utilización de la capacidad, como totales por bloque. No son cifras de la Capacity Metrics app.
Notas sobre el método
- Una ejecución cuenta como fallida si devolvió un error o un número de filas incorrecto, aunque fuera con HTTP 200. Las ejecuciones fallidas se cuentan, nunca se incluyen en las medias.
- Las ejecuciones de Direct Lake retrasadas por throttling (20.7 s fijos cada una) se excluyen de las medianas en caliente y no se repitieron. Direct Lake q4 tiene 3 ejecuciones en caliente limpias.
- Por tiempo de motor, el SQL analytics endpoint tardó de 0.175 a 0.462 s en q1 a q3, así que, frente a Direct Lake, léelo como un empate.
- El total de CU del SQL analytics endpoint excluye q2 y q3, cuyo paso de facturación no pude separar.
- Spark se ejecutó en un pool fijo de 8 nodos Medium, 64 de los 128 vCores de la prueba, igual en todas las ejecuciones.
Relacionado
- Serie Microsoft Fabric (todos los posts sobre Fabric, incluidos los experimentos de la prueba)
- Latencia de Fabric Mirroring: a dónde van los minutos (serie de la prueba 1: la misma capacidad de prueba, midiendo la frescura en lugar de la velocidad)
- Fabric data agents: lo que demuestra una línea base de 20 preguntas (el mismo esquema derivado de TPC-H a pequeña escala, preguntado en lenguaje natural)
- Gold + Direct Lake: ¿Direct Lake o Import para tablas de hechos grandes? (la parte de modelado de poner una tabla de hechos grande detrás de Direct Lake)
Si solo cambias un hábito, que sea este: mide tu consulta en frío y en caliente, en el motor y el cliente que tus usuarios van a usar de verdad, y cuenta las ejecuciones que fallan.