

Das Wichtigste in Kürze
- Behandle die Bereitschaft für Genie wie die Bereitschaft eines semantischen Modells für jeden KI-Consumer.
- Zertifiziere eine kleine Gold-Fläche; richte den Chat nicht auf Bronze oder Rohdaten.
- Mach die Granularität explizit; eine Zeile bedeutet eine Sache, und das steht in der Tabellenbeschreibung.
- Leg Fachbegriffe und Glossar dorthin, wo der Planner und das Modell beide nachsehen.
- Deklariere echte Beziehungen und je eine einzige Metrikdefinition mit Verantwortlichem.
- Klassifiziere sensible Spalten, bevor du den Zugriff per Chat öffnest.
Teams fragen, wie gut die Daten sein müssen, bevor Conversational Analytics hilft. Die ehrliche Antwort: so gut, dass eine sorgfältige Analystin denselben Tabellen auch ohne Chat-Oberfläche vertrauen würde.
Prompts können keine unklare Granularität, kryptische Spaltennamen oder fehlende Beziehungen retten. Conversational Analytics liest zuerst Metadaten und Struktur. System-Prompts sind nur eine dünne Schicht darüber.
Benanntes Modell: Genie-Bereitschaft ist Modellierungsbereitschaft
- Kuratierte Schemas: eine zertifizierte Gold-Fläche mit expliziter, langweiliger Granularität. Nicht Bronze oder Rohdaten für den Chat der Endnutzer.
- Namen und Glossar: fachlich lesbare Bezeichnungen, Katalogbeschreibungen für Codes, Synonyme direkt neben den Daten, die das Tool lesen kann.
- Beziehungen: deklarierte Schlüssel und Joins, eingegrenzte Exploration. Falsche Joins liefern plausible Zahlen.
- Metriken mit Verantwortlichen: eine Definition, ein benannter Verantwortlicher und ein Ort, den der Agent lesen darf. Sensibilität klassifiziert, bevor der Chat öffnet.
- Vertrag: Prompts sind eine dünne Schicht über Struktur und Metadaten. Unklarheit darunter wird zu flüssig formulierten falschen Antworten.
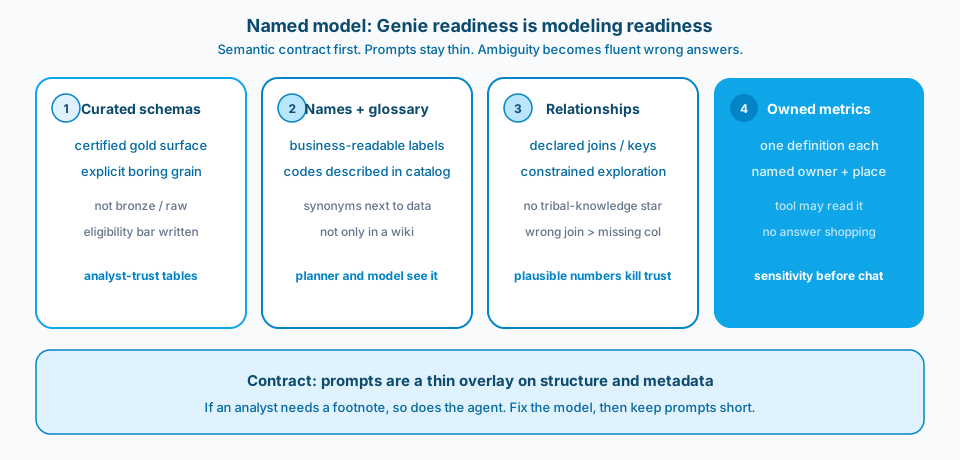
Abbildung 1. Genie-Bereitschaft ist Modellierungsbereitschaft. Kuratierte Schemas, Glossar neben den Daten, deklarierte Beziehungen und Metriken mit Verantwortlichen. Die Prompts bleiben dünn.
Kontext und Rahmenbedingung
Ein bekanntes Muster bei Aufräumprojekten: ein glänzender Genie Space auf halb kuratierten Tabellen, gefolgt von einer Woche Prompt-Bearbeitung, die den falschen Join nie behoben hat. Das Modell war nicht der Engpass. Der semantische Vertrag war es.
Wenn die Granularität unklar ist, Namen physische Codes sind, Beziehungen Stammeswissen sind und Metriken drei Verantwortliche haben, erfindet der Agent Joins und Definitionen. Das sieht aus wie "Halluzination". Oft rechnet das Modell aber nur mit der Unklarheit, die du ausgeliefert hast.
Behandle die Bereitschaft für Genie wie die Bereitschaft eines semantischen Modells für jeden KI-Consumer: kuratierte Schemas, fachlich lesbare Namen, dokumentierte Beziehungen, Metriken mit Verantwortlichen und ein Glossar, das neben den Daten lebt, nicht nur in einem Wiki, das niemand öffnet.
Abbildung 2 zeigt die Learn-Darstellung kuratierter analytischer Strukturen. Conversational-Tools sitzen auf dieser Fläche. Sie erfinden sie nicht.
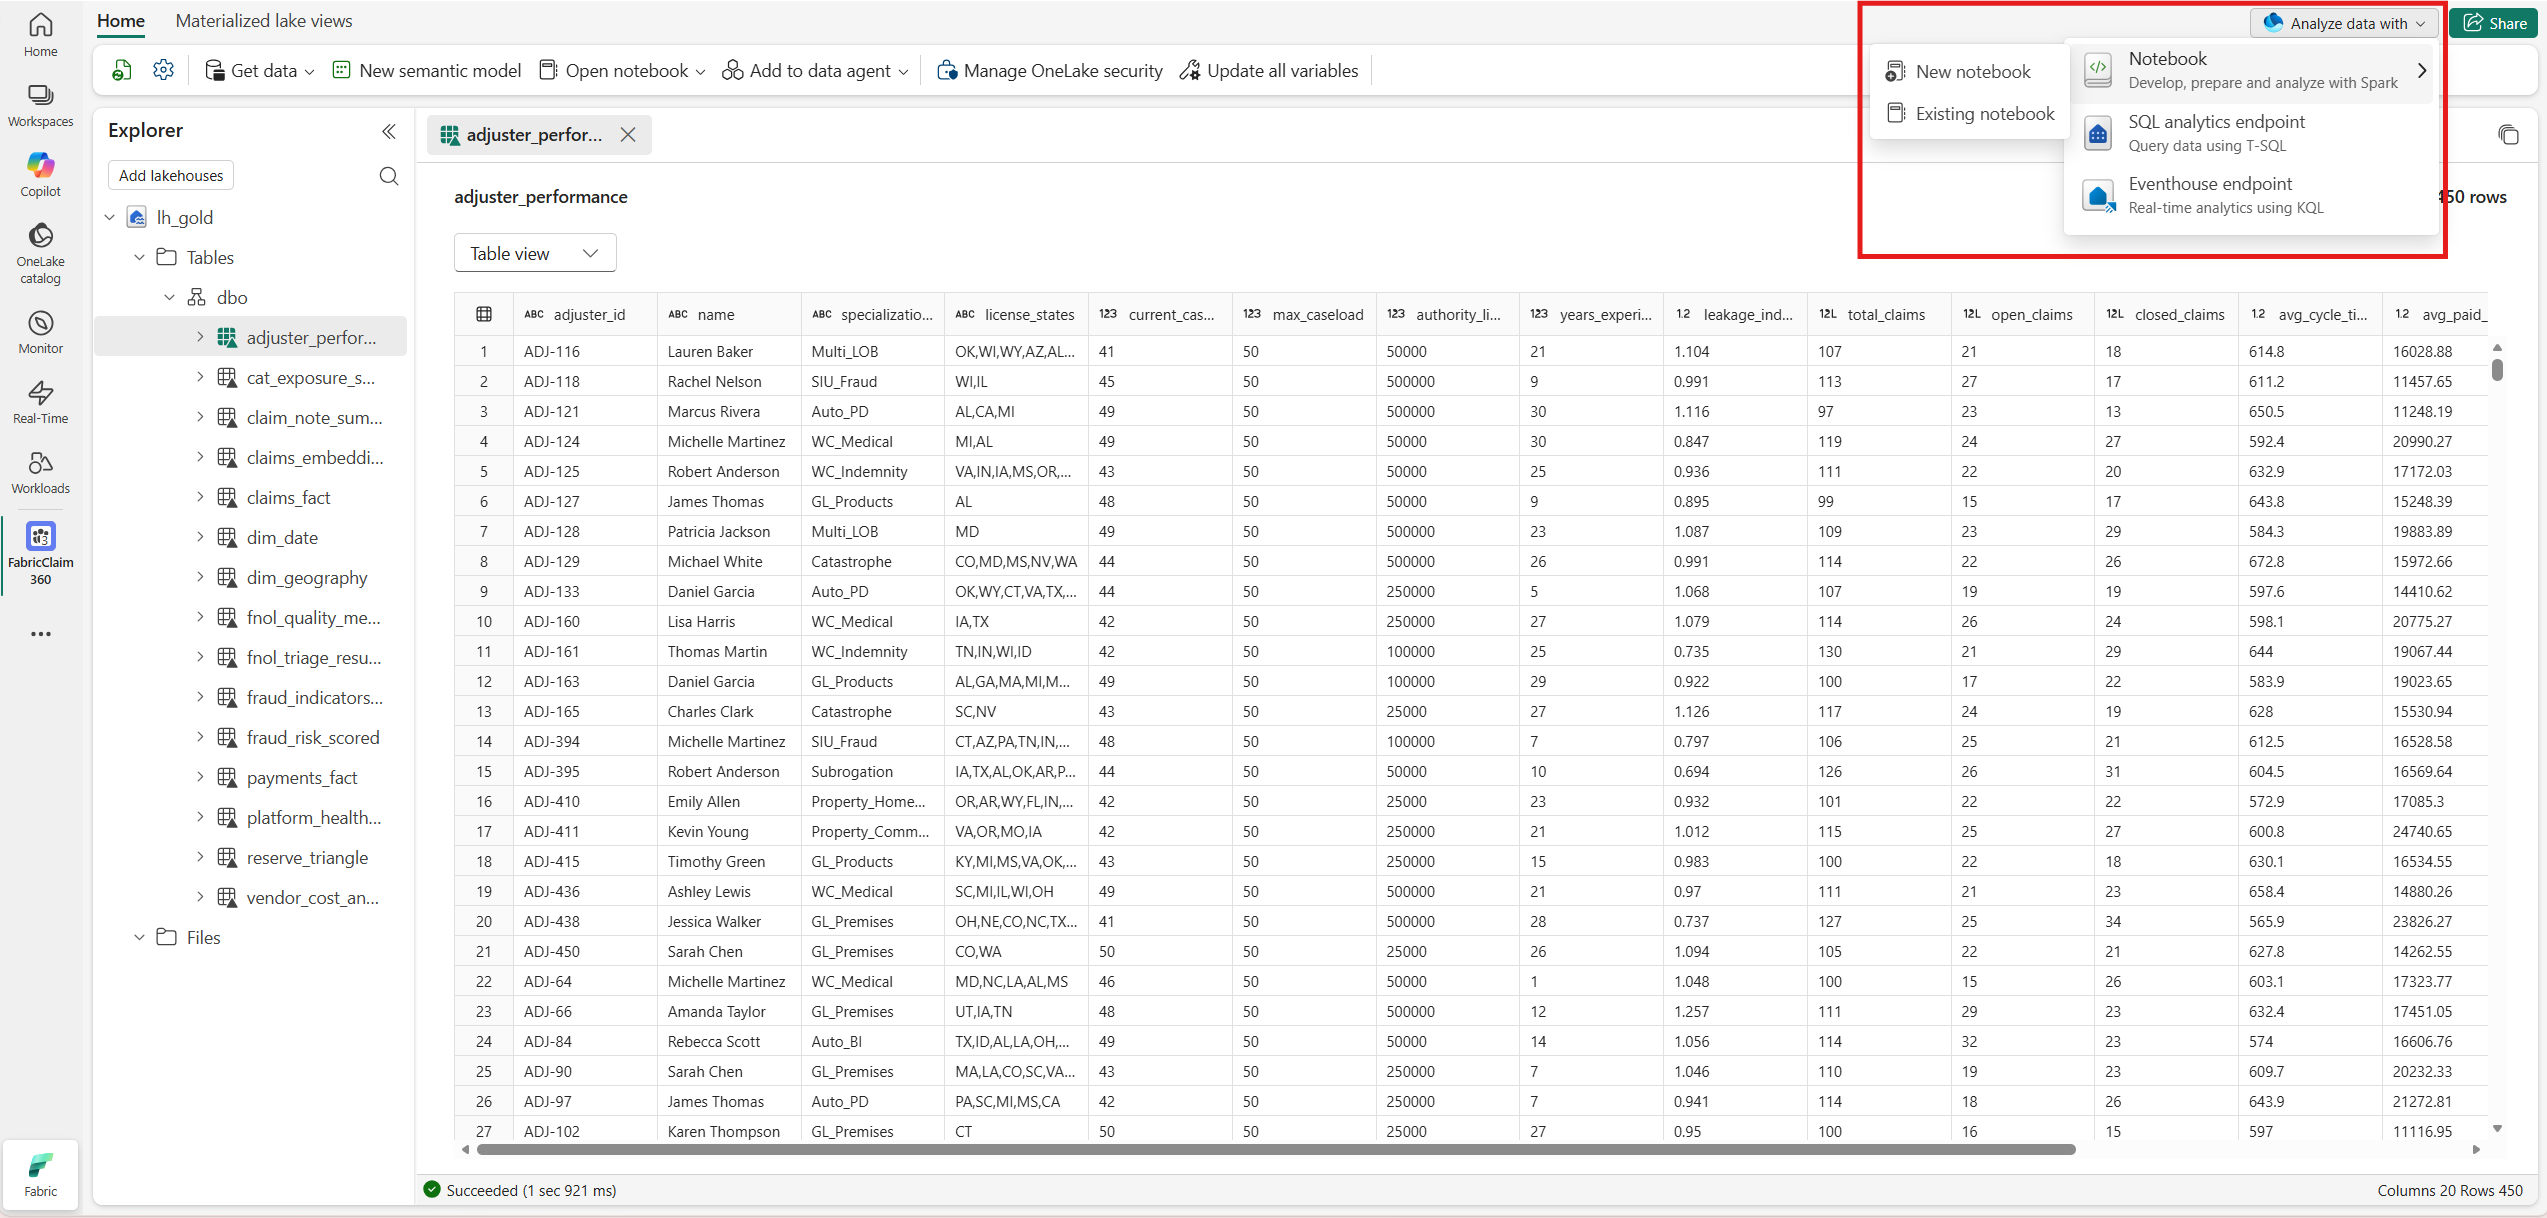
Abbildung 2. Conversational-Tools sitzen auf kuratierten analytischen Strukturen. Quelle: Microsoft Learn: lakehouse overview.
Design
1. Die Granularität ist explizit und langweilig
Eine Zeile bedeutet eine Sache. Schreib das in die Tabellenbeschreibung. Faktentabellen, die Detail- und Kopfzeilen oder Snapshots und Ereignisse mischen, liefern selbstbewusst falsche Antworten, sobald jemand nach einer Anzahl fragt. Wenn eine Analystin eine Fußnote braucht, braucht der Agent sie auch.
In meiner Demo sagt die Faktentabelle es in einer Zeile: eine Zeile pro id, genau ein Segment pro Zeile, und wie der Wert summiert wird. Jeder Spaltenkommentar sagt, was die Spalte enthält, und die Schlüsselspalten sind als Primär- und Fremdschlüssel markiert (Abbildung 3).
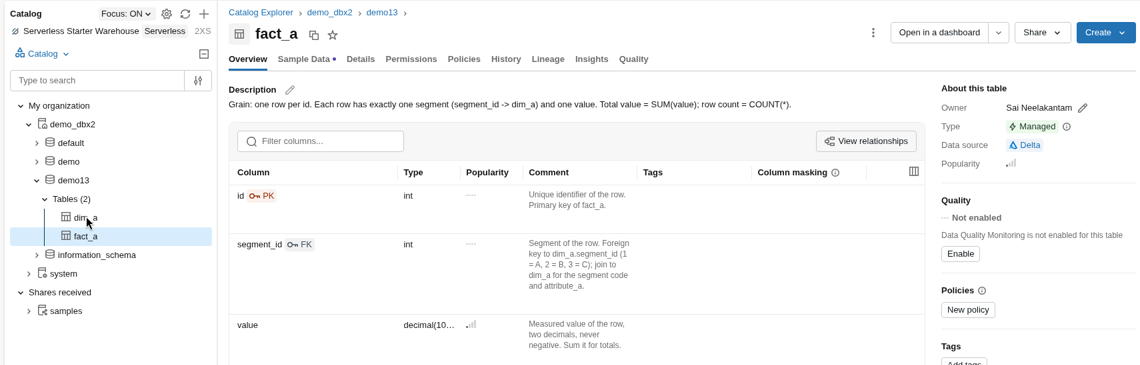
Abbildung 3. Granularität, Schlüssel und Bedeutung der Spalten stehen an der Tabelle selbst, wo jeder Consumer sie lesen kann.
2. Namen und Glossar schlagen clevere Anweisungen
Verwende fachlich lesbare Namen für Tabellen, Spalten und Measures. Codes brauchen Beschreibungen im Katalog. Synonyme dafür, wie Leute wirklich fragen ("amount" gegenüber COL_A), gehören in die semantische Schicht oder in Katalogmetadaten, die das Tool sehen kann. Ein langer System-Prompt, der das Glossar wiederholt, ist eine Wartungsfalle. Leg die Bedeutung dorthin, wo der Query Planner und das Modell beide nachsehen.
Genie übernimmt diese Metadaten. Im Space zeigt dieselbe Faktentabelle die Beschreibung der Granularität aus dem Katalog, die Schlüsselmarkierungen und den Kommentar, der segment_id auf die Dimension verweist (Abbildung 4).
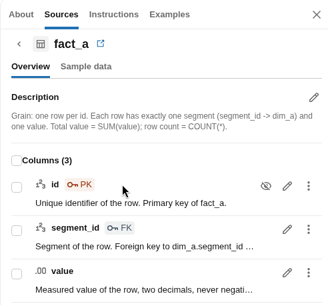
Abbildung 4. Katalogbeschreibung und Schlüssel gehen unverändert in den Genie Space über.
3. Beziehungen sind real, nicht nur gewünscht
Deklariere die Joins, die du erwartest. Primärschlüssel, Fremdschlüssel und eingegrenzte Explorationsräume zählen mehr als Temperatur-Einstellungen. Wenn zwei Datumsspalten beide wie "das" Datum aussehen, wählt das Modell eine davon. Wenn eine Brückentabelle nicht dokumentiert ist, erfindet der Agent ein Sternschema, das es nicht gibt. Falsche Beziehungen sind schlimmer als fehlende Spalten: Sie liefern plausible Zahlen.
In meiner Demo sind die Schlüssel auf einem Fakt und einer Dimension deklariert, die sich segment_id teilen, und der Catalog Explorer zeichnet die Verbindung zwischen ihnen (Abbildung 5).
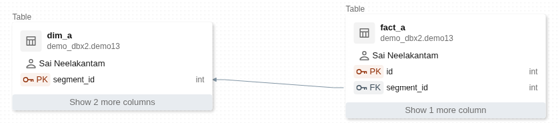
Abbildung 5. Die deklarierten Schlüssel, wie der Catalog Explorer sie zeichnet: fact_a.segment_id zeigt auf den Primärschlüssel von dim_a.
Der Join war auch in der Space-Definition deklariert: ein join_specs-Eintrag, der mit der Genie-Spaces-API gesendet wurde, fact_a zu dim_a über segment_id, many to one. Kein Genie-Bildschirm in diesem Workspace hat diesen Join angezeigt, also sind die deklarierten Schlüssel plus das SQL, das Genie schreibt, der Beweis. Auf die Frage nach dem Gesamtwert für ein Attribut hat Genie fact_a mit einem INNER JOIN über segment_id mit dim_a verknüpft und 97.00 geantwortet (Abbildung 6). Lies das generierte SQL, nicht nur die Antwort, um zu sehen, welchen Join es gewählt hat.
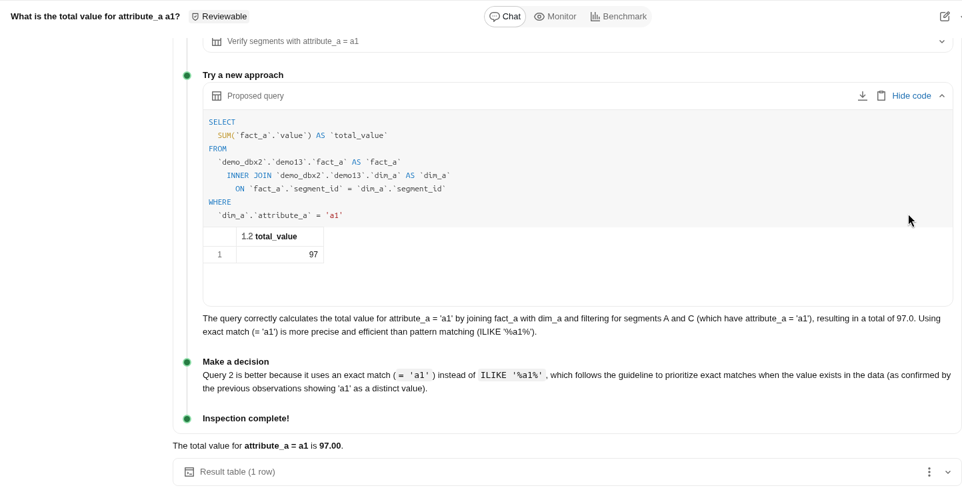
Abbildung 6. Im generierten SQL siehst du, welchen Join Genie gewählt hat: einen INNER JOIN über den deklarierten Schlüssel, dann den Filter auf die Dimension.
Abbildung 7 zeigt, warum ein Aufräumen nur über Prompts scheitert. Das Anweisungstuning wächst. Der falsche Join bleibt.
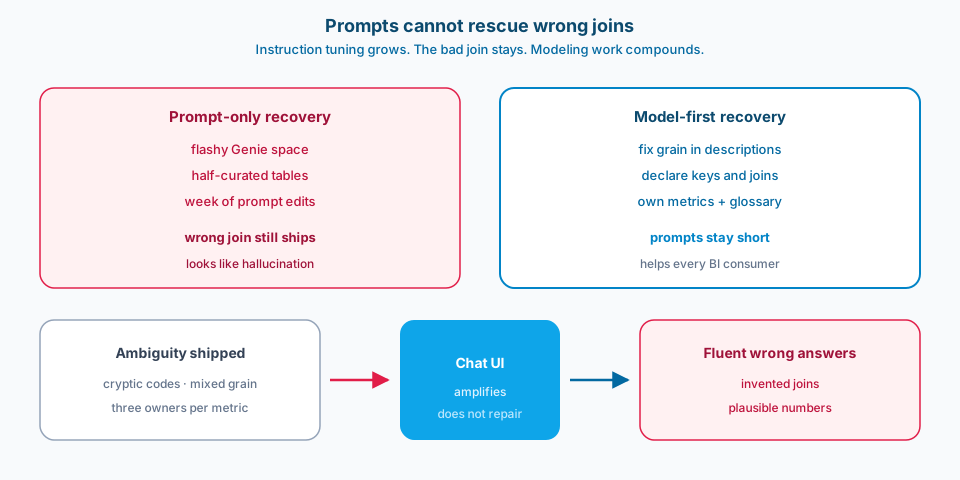
Abbildung 7. Prompts können falsche Joins nicht retten. Unklarheit, die du auslieferst, wird in der Chat-Oberfläche zu flüssig formulierten falschen Antworten. Modellierungsarbeit zahlt sich für jeden BI-Consumer aus.
4. Metriken haben eine einzige Definition mit Verantwortlichem
Jede Metrik braucht eine Definition, einen benannten Verantwortlichen und einen Ort, den das Conversational-Tool lesen darf. Konkurrierende Berechnungen in verschiedenen Gold-Tabellen garantieren, dass sich jeder die passende Antwort aussucht. Zertifizierte Teilmengen helfen: Eine kleine Gold-Fläche für Genie schlägt "die ganze Produktion" mit einem freundlichen Prompt.
5. Klassifiziere sensible Spalten, bevor du den Chat öffnest
Zugriff per Chat ist trotzdem Zugriff. Maskierung, Column-Level Security und zertifizierte Ausschlüsse gehören in die Checkliste für die Bereitschaft. Wenn eine neue Kollegin ein Feld nicht unbeaufsichtigt abfragen sollte, lass es nicht von einem Agenten anzeigen, nur weil sich die Oberfläche sicher anfühlte.
6. Zertifiziere einen Space, richte ihn nicht auf Bronze
Bronze und Rohdaten sind für Engineers. Conversational-Tools brauchen kuratierte analytische Strukturen: saubere Granularität, stabile Namen, getestete Beziehungen. Genie auf Rohdaten zu richten, um "schneller voranzukommen", verschiebt das Aufräumen nur in jede einzelne Nutzerfrage.
Abbildung 8 zeigt die Zulassungshürde. Zertifiziere eine Gold-Fläche für Conversational Analytics. Verbiete Rohdaten, außer in zeitlich begrenzten Spikes ohne Endnutzer-Traffic.
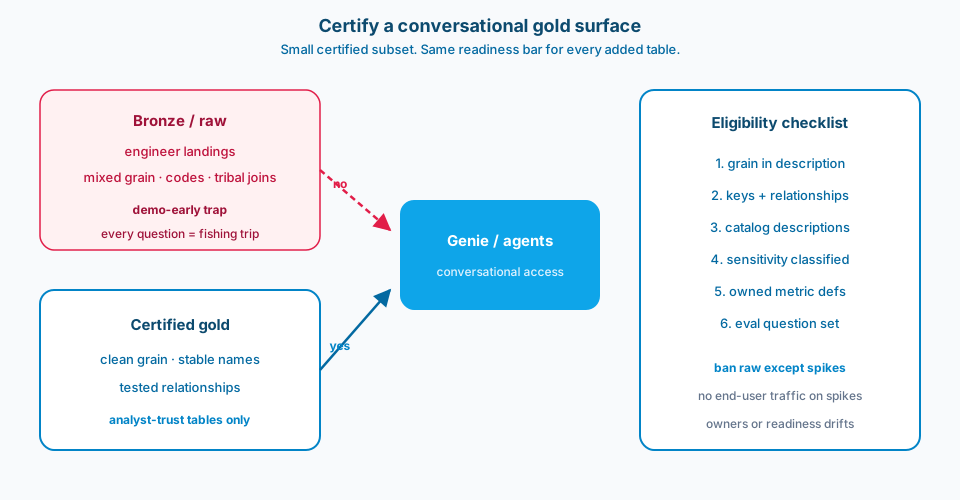
Abbildung 8. Zertifiziere eine Gold-Fläche für Conversational Analytics. Eine kleine, bereite Teilmenge schlägt das Öffnen der gesamten Produktion. Jede zusätzliche Tabelle braucht dieselbe Hürde.
Serving-Schichten, APIs und Chat-Oberflächen reparieren keine Unklarheit darunter. Sie verstärken sie. Wenn das Warehouse- oder Lakehouse-Modell unscharf ist, ist die Conversational-Schicht flüssig unscharf.
Abbildung 9 zeigt die Learn-Darstellung von Serving- und App-Flows. Der Weg über die Oberfläche ist kein Werkzeug zur semantischen Reparatur.
Abbildung 9. Serving-Schichten und APIs beheben keine semantische Unklarheit darunter. Quelle: Microsoft Learn: app scenarios.
Häufige Fehler
Bronze für mehr Tempo. Teams hängen Conversational-Tools an Rohtabellen, um früh eine Demo zu zeigen. Jede Frage wird zur Angeltour. Das Vertrauen erholt sich nie.
Keine zertifizierte Gold-Teilmenge. Alles ist "verfügbar", also ist nichts verlässlich. Nutzer misstrauen den Antworten, selbst wenn eine spätere Abfrage zufällig stimmt.
Beschreibungen, die physische Namen wiederholen.
key_a mit der Beschreibung "key a" bringt dem Modell nichts bei. Die fachliche Bedeutung muss jemand aufschreiben, der die Domäne kennt.
Beziehungen, die nur in jemandes Kopf existieren. Das Modell erfindet Joins. Du debuggst "Halluzinationen", die in Wahrheit fehlende Fremdschlüssel waren.
Metrik-Kriege. Drei Teams definieren jeweils dieselbe Metrik. Genie wählt eine. Der Chat zettelt einen Streit an.
Reparatur nur über Prompts. Wochenlanges Anweisungstuning auf einem chaotischen Modell. Die Anweisungen wachsen. Der falsche Join bleibt.
Sicherheit als Nachgedanke. Der Chat öffnet zuerst; die Klassifizierung der Spalten kommt erst, nachdem jemand nach einer gesperrten Spalte gefragt hat.
So übernehmen oder anpassen
So übernehmen
- Welche Schemas oder semantischen Modelle für den Zugriff per Chat zertifiziert sind.
- Pflichtmetadaten im Katalog, bevor eine Tabelle zugelassen wird (Granularität, Beschreibungen, Schlüssel, Sensibilität).
- Regeln für die Verantwortung für Beziehungen und Metriken, einschließlich der Lösung von Konflikten.
- Ort des Glossars (Katalog oder semantische Schicht, die das Tool lesen kann, nicht nur Confluence).
- Wie die Antwortqualität bewertet wird: fester Fragenkatalog, erwartete Ergebnisse, Prüfung der Joins im generierten SQL, Review-Rhythmus.
- Ein ausdrückliches Verbot, Genie auf Rohdaten oder Bronze zu richten, außer in zeitlich begrenzten Spikes ohne Endnutzer-Traffic.
Vor dem Einsatz anpassen
Ein zertifizierter Genie Space ist kleiner als das Warehouse. Das Produktteam wird drängen, "nur noch eine Tabelle" hinzuzufügen. Jede Ergänzung braucht dieselbe Hürde, sonst führst du still wieder Unklarheit ein.
Modellierungsarbeit ist langsamer als Prompt-Arbeit. Sie zahlt sich aber über die Zeit aus. Eine saubere Granularität und ein Glossar helfen jedem BI-Consumer, nicht nur dem Chat. Prompt-Flicken helfen bis zur nächsten Modellversion oder zur nächsten unklaren Spalte.
Du brauchst Verantwortliche: wer eine Tabelle zertifiziert, wer das Glossar bearbeitet, wer Metrikdefinitionen abzeichnet. Ohne Verantwortliche wird die Bereitschaft zu einem einmaligen Aufräumen, das wieder verwildert.
Evaluationssuiten kosten Zeit. Bevorzuge langweilige Regressionsfragen gegenüber einer einzigen beeindruckenden Live-Demo.
Probier es selbst aus
Die Genie-Readiness-Demo in meinem öffentlichen tech-demos-Repo baut den kleinen Fakt und die Dimension mit Kommentaren zur Granularität und deklarierten Schlüsseln, dazu den Genie Space mit zwei Tabellen, damit du prüfen kannst, welchen Join Genie schreibt.
Wichtigste Quellen: Microsoft Learn zu lakehouse overview und semantic model best practices for data agents sowie die Genie- oder Conversational-Analytics-Dokumentation deiner Plattform zur Konfiguration von Spaces.
Repariere die Modellierung. Dann können die Prompts kurz bleiben.