
Das Wichtigste in Kürze
- Der Kontext ist das Produkt: natives Wissen über Lakehouse und Deployment schlägt mühsames Babysitten eines dünnen MCP.
- Optimiere auf Artefakte, die Leute präsentieren und ausführen (editierbare Decks, gehostete Apps), nicht nur auf Chat-Antworten.
- Bilde PPTX-Vorlagen des Unternehmens als versionierte Skills ab. Markentreue ist kein Wunder beim ersten Prompt.
- Halte die Compute-Form im Deploy-Runbook fest (Serverless oder klassisch, Identität der App, Grants in Unity Catalog).
- Behandle Erfolgsquoten des Herstellers als Signal. Reproduzier sie mit deinen Tabellen, deiner Vorlage und deinem Host.
- Die menschliche Prüfung bleibt auf dem kritischen Pfad, bevor etwas an Führungskräfte oder externe Empfänger geht.
Kann Databricks Genie aus meinen Daten eine PowerPoint machen und dabei eine Unternehmensvorlage einhalten? Kann es eine Web-App entwickeln und bereitstellen, die auf einem Genie Space aufsetzt?
Diese Fragen höre ich nach Demos immer wieder. Ich habe Genie Code mit zwei Aufgaben auf die Probe gestellt: Daten mit Governance in ein editierbares Deck verwandeln und eine kleine Web-App auf der Plattform ausliefern. Damit steigt die Messlatte dafür, was ein Assistent für eine Enterprise-Datenplattform von Anfang bis Ende übernehmen kann.
Benanntes Modell: Kontext → Artefakt → Prüfung
- Kontext: Genie Code sieht bereits, was der Principal sehen darf: Tabellen, Governance und Einschränkungen der Plattform. Du übernimmst die Berechtigungen, statt Auszüge in einen Consumer-Chatbot zu kopieren.
- Artefakt: Der Assistent macht nach dem Chat weiter, mit Decks, Apps und Deployments. Eine korrekte SQL-Antwort ist kein Vorstandspaket. Eine Code-Skizze ist keine gehostete App.
- Prüfung: Editierbare Decks brauchen weiterhin einen Abgleich mit den Metrikdefinitionen. Bereitgestellte Apps brauchen weiterhin Authentifizierung, Secrets, Kostenkontrollen und CI. Der Gewinn ist die Geschwindigkeit beim Entwurf. Ungeprüftes Veröffentlichen ist der typische Fehler.
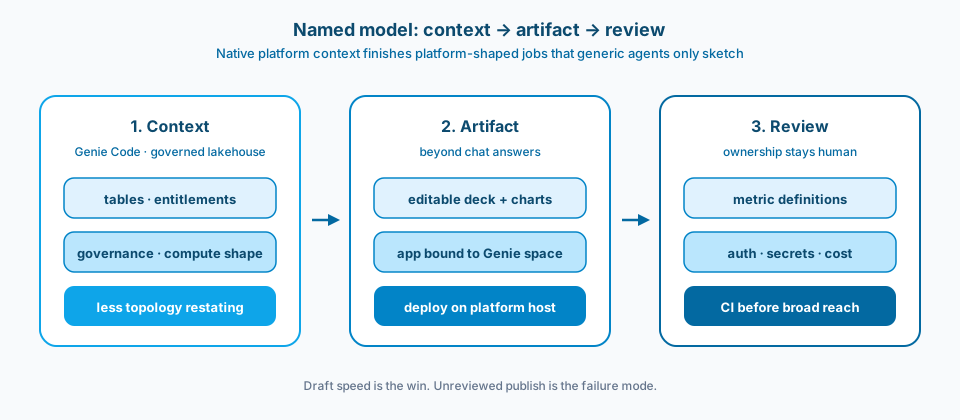
Abbildung 1. Benanntes Modell für die Arbeit mit Genie Code. Nativer Kontext speist die Erzeugung von Artefakten. Die Prüfung entscheidet, was ein Publikum oder einen gemeinsamen Host erreicht.
Kontext und Rahmenbedingung
Der meiste Rummel um Genie Code dreht sich um Datenfragen oder ETL-Gerüste. Mich hat der Alltag interessiert: Kann es Artefakte erzeugen, die Leute tatsächlich präsentieren und ausführen? Nach diesen Tests fühlt es sich näher an Claude Code oder Cursor an als an oberflächlicher Autovervollständigung, mit Datensicherheit auf Enterprise-Niveau, die schon im Raum ist. Nativer Databricks-Kontext zu Tabellen, Governance und Einschränkungen der Plattform heißt weniger verschwendete Tokens, um die Topologie des Warehouse noch einmal zu erklären.
Genie Code zählt, wenn es nach dem Chat mit Artefakten weitermacht. Wenn es die Einschränkungen beim Deployment mitdenkt, verbringst du weniger Zeit als menschlicher MCP-Adapter. Abbildung 2 ist die Aufteilung der Verantwortung, die ich nutze, wenn jemand fragt, ob ein generischer Coding Agent mit dünnem MCP "dasselbe" ist.
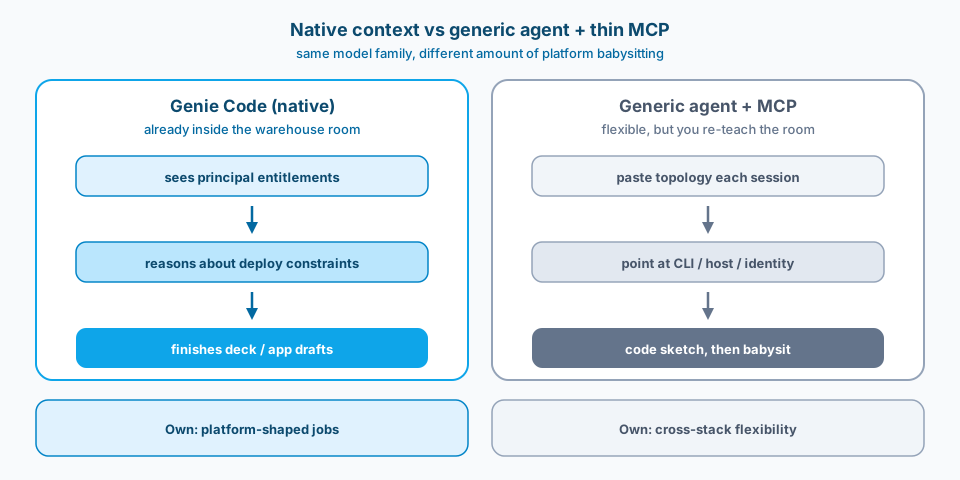
Abbildung 2. Dieselbe Art von Coding-Hilfe, unterschiedlich viel Babysitting. Nativer Kontext erledigt plattformtypische Aufgaben. Generische Agents bleiben über Stacks hinweg flexibel, müssen aber in jeder Sitzung neu lernen, wie Warehouse und Deployment wirklich aussehen.
Design
1. Deck-Erstellung als Workflow mit Skill
Ich habe Genie Code mit einem Open-Source-Skill für PPTX verbunden (aus derselben Familie, die mit Claude Code genutzt wird), um aus Databricks-Daten eine PowerPoint zu bauen. Statt Erkenntnissen nur im Chat hat es ein vollständiges, editierbares Deck mit mehreren Folien und Diagrammen erzeugt. Das ist der Unterschied zwischen einem Screenshot einer Antwort und einem Artefakt, das für monatliche oder quartalsweise Reviews im Besprechungsraum taugt. Abbildung 3 zeigt den Weg: Metriken mit Governance in einen Skill, dann ein editierbares Deck, dann eine redaktionelle Durchsicht.
2. Vorlagen als bewusste Anpassung, nicht als Magie
Wenn du den Skill anpasst, kann er mit einer Unternehmensvorlage arbeiten: die Struktur entpacken, dann für die passenden Daten Folien auswählen und ersetzen. Exakte Markentreue ist eine Frage von Skill und Assets, nicht von Gefühl. Plane Zeit ein, um die Regeln der Vorlage abzubilden. Erwarte nicht, dass ein erster Prompt deinen Unternehmensmaster erfindet.
3. App bauen und bereitstellen mit den Einschränkungen der Plattform
App-Entwicklung und Deployment in Databricks sind aus IDEs wie Cursor oder Claude Code mit Databricks MCP möglich, aber ich muss diese Agents trotzdem auf den richtigen Weg bringen. Genie Code hat den Kontext der Plattform schon. In meinem Lauf hat ein einzeiliger Prompt gereicht, damit es eine leere App anlegt, die Arbeit plant und die App-Seite öffnet, während das Compute startete. Nach einem Anstoß, weiterzumachen, hat es app.py, app.yaml und requirements.txt geschrieben, über die Workspace- und Apps-APIs bereitgestellt, und die App lief auf einem Databricks Apps Host mit dem Status Running.
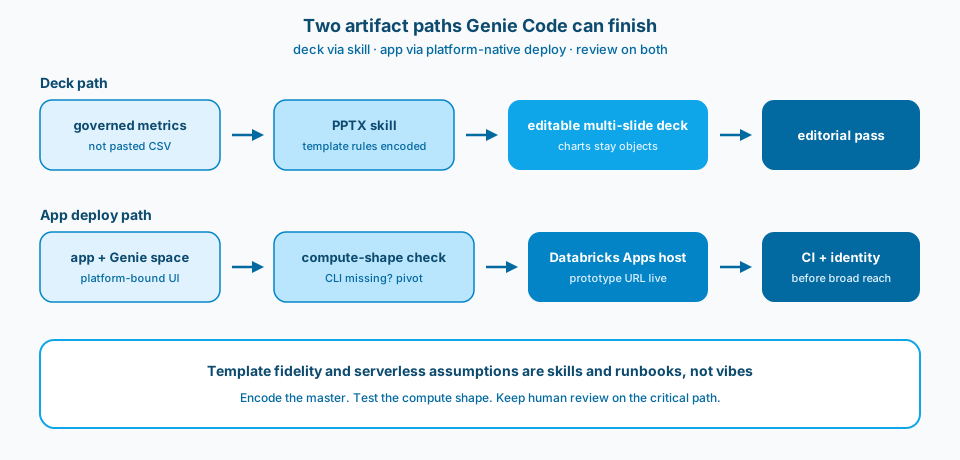
Abbildung 3. Zwei Pfade für Artefakte. Oben: Metriken mit Governance über einen PPTX-Skill in ein editierbares Deck, dann redaktionelle Prüfung. Unten: eine App, die an einen Genie Space gebunden ist, Prüfung der Compute-Form, Deployment auf den Host, dann CI und Identität, bevor sie breit zugänglich wird.
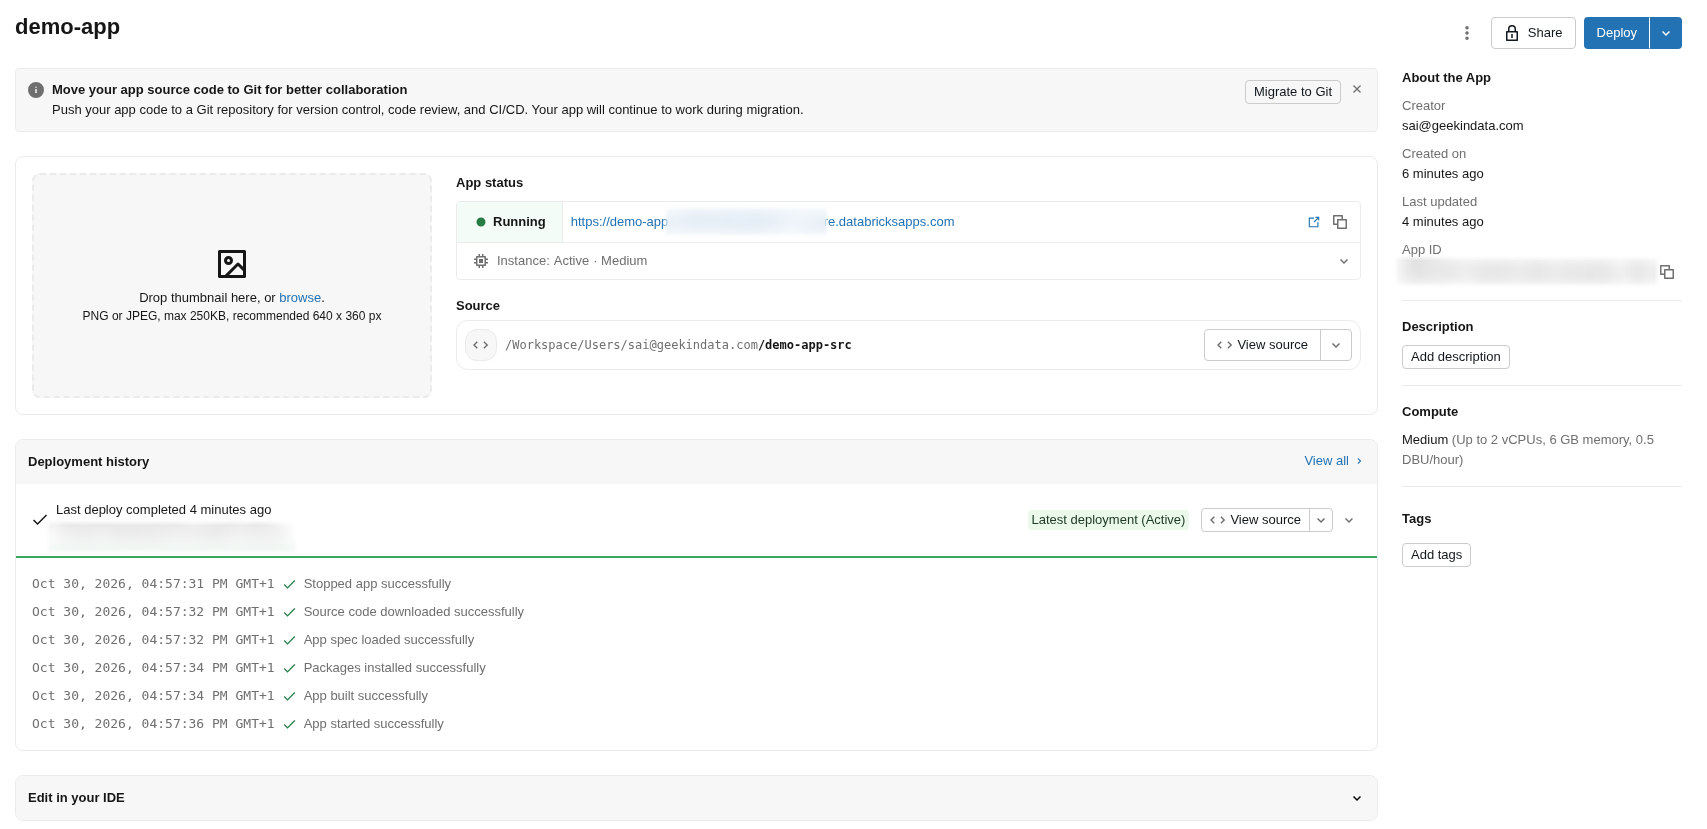
Abbildung 4. Eine Demo-App auf ihrer Detailseite direkt nach dem Deployment. Die Compute-Form (Medium) und der Deployment-Verlauf (Quellpfad, dann jeder Schritt von Stop bis Start) stehen auf einer Seite, deshalb kopiere ich sie von dort ins Deploy-Runbook.
Running heißt nicht, dass es funktioniert. Genie Code hat dem Service Principal der App SELECT auf die Tabelle gegeben, dann angehalten und nachgefragt, bevor es USE CATALOG und USE SCHEMA vergibt. Bis jemand das genehmigt, zeigt das Diagramm "Failed to load data" (Abbildung 5). Das ist das Standardverhalten, das ich von einem Agent will, und es heißt, dass die Grants ins Runbook gehören, nicht in einen späteren Prompt.
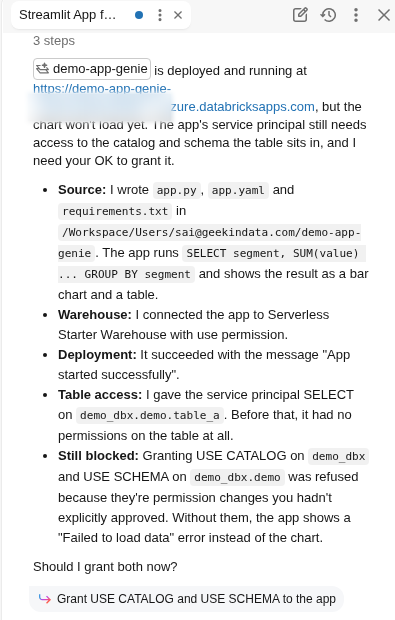
Abbildung 5. Die eigene Zusammenfassung des Agents nach dem Deployment. Der Zugriff auf die Tabelle ist vergeben, aber die Grants für Catalog und Schema warten auf mein OK. Die App läuft also, und das Diagramm kann noch keine Daten laden.
Die App läuft nicht als ich. Sie bekommt ihren eigenen Service Principal, und angemeldete Nutzer laufen über einen separaten OAuth-Client mit eigenen Scopes (Abbildung 6). Entscheide, welche Identität die Daten liest, bevor du den Link teilst.
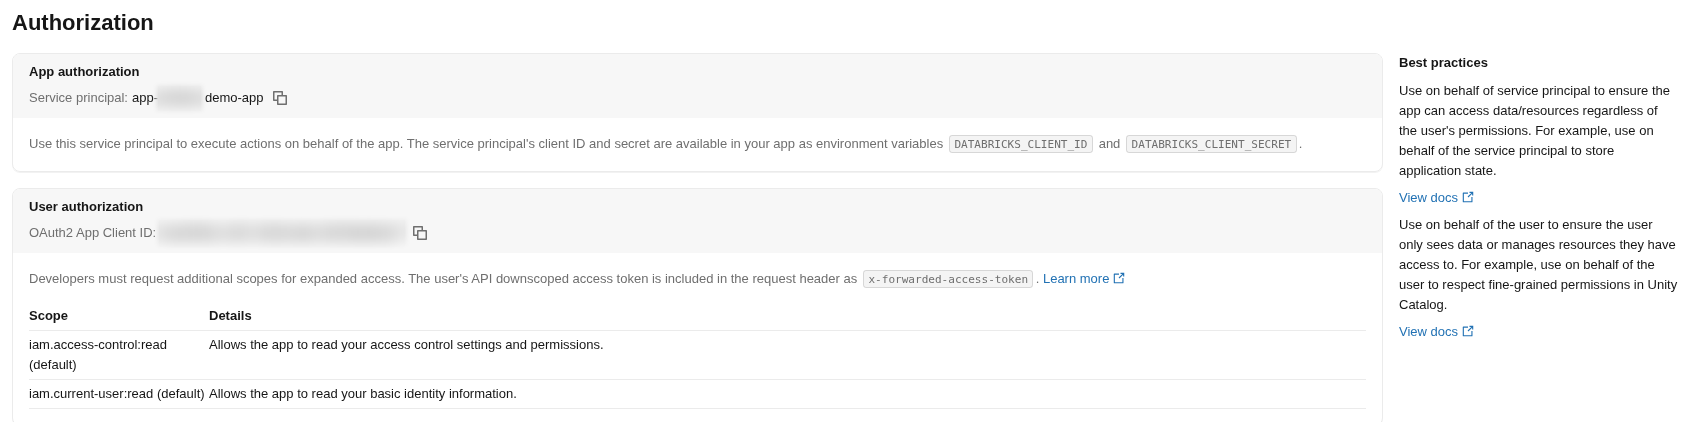
Abbildung 6. Zwei Identitäten in einer App. Der Service Principal handelt für die App, der OAuth-Client für den angemeldeten Nutzer. Wähle bewusst eine davon.
Der Lauf für das Deck ist stattdessen an der Compute-Form gescheitert. Serverless Compute war in diesem Workspace nicht aktiviert, also hat Genie Code den python-pptx-Code in ein Notebook gelegt und ihn einmal auf dem vorhandenen Cluster ausgeführt (Abbildung 7). Halte beide Fakten im Runbook fest, die Grants und das Compute, das du tatsächlich hast, damit die nächste Person sie nicht unter Demo-Druck neu entdeckt.
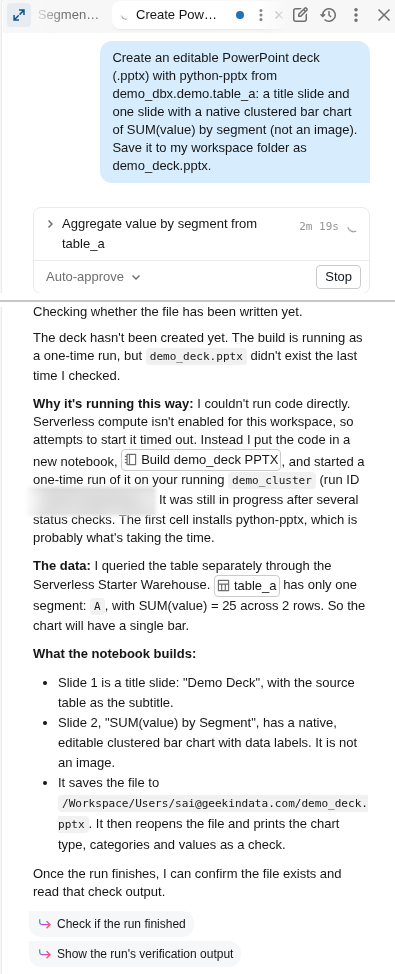
Abbildung 7. Der Bau des Decks weicht auf ein Notebook auf einem klassischen Cluster aus, weil Serverless aus ist. Der Agent erklärt den Kurswechsel, statt still zu scheitern.
Das Diagramm in diesem Deck ist nativ, kein Bild. In einem erneuten Lauf gegen eine Demo-Tabelle mit drei Segmenten enthält die von Genie Code gebaute pptx das Diagramm als Chart-XML mit eingebettetem Arbeitsblatt. Die Werte liegen also hinter dem Diagramm und lassen sich direkt bearbeiten (Abbildung 8).
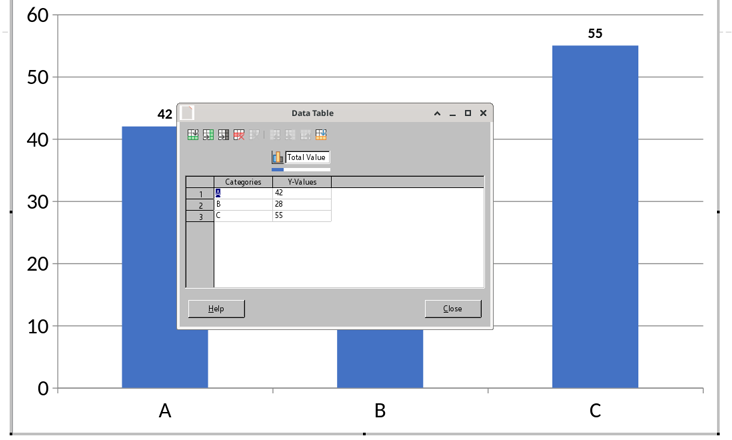
Abbildung 8. Das erzeugte Deck, geöffnet in LibreOffice Impress, unterhalb des Folientitels zugeschnitten. Die Data Table des Diagramms zeigt die eingebetteten Werte (A 42, B 28, C 55). Genau das macht es editierbar statt zu einem Screenshot.
4. Benchmarks als Signal, nicht als Religion
Databricks hat für Genie Code eine Erfolgsquote von etwa 77.1% bei realen Aufgaben gemeldet, gegenüber etwa 32.1% für führende Coding Agents mit MCP. Nimm das als Beleg, dass nativer Kontext die Ergebnisse verändert, nicht als Garantie für dein Ticket am Montag. Reproduzier die Aufgaben, die zählen: ein Deck aus Metriken mit Governance, eine App, die an einen Genie Space gebunden ist, ein Deployment auf dem Compute, das du tatsächlich nutzt.
5. Die menschliche Prüfung bleibt auf dem kritischen Pfad
Editierbare Decks brauchen weiterhin einen Menschen, der Aussagen gegen die Metrikdefinitionen prüft. Bereitgestellte Apps brauchen weiterhin Authentifizierung, Secrets und Kostenkontrollen. Genie Code verkürzt den Weg zum Entwurf. Die Verantwortung schafft es nicht ab.
Häufige Fehler
Chat-Antworten für Vorstandsartefakte halten. Eine korrekte SQL-Antwort ist kein Deck. Entwirf den Skill-Pfad und die Regeln der Vorlage explizit. Abbildung 3 ist die Mindestform.
Auf die Vorlage hoffen, ohne an der Vorlage zu arbeiten. Ein Prompt zur Marke ergibt ein generisches Theme. Exakte Master müssen abgebildet und mit Test-Renderings geprüft werden.
Einen generischen Agent mit dünnem MCP für nativen Kontext halten. Du bekommst Code und babysittest dann die Topologie des Deployments und die Verfügbarkeit der CLI. Abbildung 2 macht dieses Babysitten sichtbar.
Annehmen, dass Serverless da ist. In meinem Workspace war es aus, also ist der Bau des Decks auf ein Notebook auf einem klassischen Cluster ausgewichen. Auch die Verdrahtung der Identität und der ausgehende Netzwerkverkehr unterscheiden sich. Halte die Compute-Form im Deploy-Runbook fest.
Benchmark-Theater. Du zitierst 77.1% und lässt die Smoke-Tests mit deinen Tabellen, deiner Vorlage und deinem App-Host aus.
Ungeprüftes Veröffentlichen. Ein Agent kann bereitstellen. Sichere Promotion, Identität der App und Catalog-Grants ab, bevor etwas breit zugänglich wird. Abbildung 1 setzt die Prüfung absichtlich auf den kritischen Pfad.
So übernehmen oder anpassen
So übernehmen
- Genie Code ist für Entwürfe von Decks und Prototypen von Apps erlaubt. Die Veröffentlichung in Produktion folgt den bestehenden Review- und CI-Gates.
- PPTX-Vorlagen des Unternehmens sind als versionierte Skills oder Assets mit einer Checkliste für Smoke-Renderings abgebildet.
- Automatisch erzeugte Diagramme müssen auf Tabellen mit Governance oder semantische Metriken zurückgehen, nicht auf eingefügte CSV-Auszüge.
- Deploy-Runbooks dokumentieren die Compute-Form, die Identität der App und die Grants in Unity Catalog, die der Service Principal der App braucht. Die Verfügbarkeit von Serverless wird geprüft, nicht angenommen.
- Menschliche Prüfung ist Pflicht, bevor externe Empfänger oder Führungskräfte erzeugte Decks sehen.
- Vergleiche den nativen Assistenten regelmäßig mit MCP aus der IDE anhand eines festen internen Aufgabensets. Verlass dich nicht nur auf die Prozentzahlen des Herstellers.
Vor dem Einsatz anpassen
Native Assistenten verringern den Aufwand, bei plattformtypischer Arbeit den Kontext zusammenzustellen. Du nimmst dafür die Bindung an den Hersteller in Kauf. Externe Coding Agents bleiben über Stacks hinweg flexibel, müssen aber in jeder Sitzung neu lernen, wie Warehouse und Deployment wirklich aussehen.
Decks mit Skills sind mächtig und bei komplexen Mastern und semantischen Diagrammen trotzdem fragil. Plane eine redaktionelle Durchsicht ein. Wenn du die letzte menschliche Prüfung streichst, landen falsche KPIs im Paket für die Betriebsversammlung.
Das Deployment durch den Assistenten beschleunigt Prototypen. Produktion braucht trotzdem CI, Reviews und getrennte Umgebungen. Lichte den ersten Nebel, aber umgeh nicht den release train.
Probier es selbst aus
Beide Demos liegen in meinem öffentlichen Repo tech-demos: eine minimale Databricks App, die du mit der CLI bereitstellst, und ein Skript, das ein Deck mit nativen, editierbaren Diagrammen baut.
Verwandte Notizen
Damit bleibt auch eine Frage an Copilot in Microsoft Fabric: Kommt bald ein Agent-Modus mit Kontext zu Fabric-Items und Daten? Behalte diese Frage im Blick, wenn du Assistenten verschiedener Plattformen vergleichst, nicht nur Databricks Genie.
Wichtigste Quellen: Genie Code, die Dokumentation von Anthropic zu Agent Skills, die Databricks-Dokumentation zu Genie und Databricks Apps und Material von Databricks zur Erfolgsquote von Genie Code mit und ohne nativen Plattformkontext.
Kontext. Artefakt. Prüfung. Drei Schritte. Nativ schlägt naiv, wenn die Aufgabe plattformtypisch ist.