

Das Wichtigste in Kürze
- Der Code ändert sich zwischen Targets nie. Nur die Bindungen ändern sich: Catalog, Host, Zeitpläne, Identität und Berechtigungen.
- Development- und Production-Modus sind Bündel von Presets, keine Leiter. Ein Test-Target ohne Modus bekommt keine ihrer sicheren Standardwerte.
- Eine Einstellung an der Ressource schlägt ein Preset, und ein Preset schlägt den Modus. Schreib einen Zeitplan fest als unpausiert hinein, und er läuft überall.
- Bundle-Variablen werden zum Deploy-Zeitpunkt aufgelöst. Gib den Catalog als Job-Parameter an den Code weiter.
- Deploye als ein Service Principal und führe als ein anderer aus. Wenn sich die beiden unterscheiden, werden nur Jobs und Pipelines unterstützt.
Halte den Code in jedem Target identisch und schreib in jeden Target-Block nur einen kleinen, expliziten Satz an Bindungen: Catalog, Host, Zeitpläne, Run-Identität und Berechtigungen. Der Gewinn: Der Commit, den du in Dev getestet hast, ist derselbe Commit, der in Prod läuft, und ein fest eingetragener Zeitplan oder Host kann nicht von einer Umgebung in die nächste durchsickern.
Ein Bundle nimmt dir diese Trennung nicht ab. Es deployt dieselben Jobs bereitwillig in drei Umgebungen, aber seine Standardwerte sind ungleich verteilt: Der Development-Modus ist vorsichtig, der Production-Modus prüft ein paar Dinge, und ein Test-Target in der Mitte bekommt gar nichts, wenn du es nicht ausdrücklich verlangst.
Benanntes Modell: fester Code, gebundene Targets, getrennte Identitäten
- Fester Code: Notebooks, SQL und Job-Definitionen sind in jedem Target identisch. Keine Hosts, Catalogs oder IDs im Code.
- Gebundene Targets: Jedes Target setzt seinen Catalog, seine Zeitpläne, seine Run-Identität und seine Berechtigungen; der Host kommt aus der Pipeline.
- Getrennte Identitäten: Eine CI-Identität deployt; ein separater Service Principal führt aus; Menschen bekommen Berechtigungen, keine Zugangsdaten.
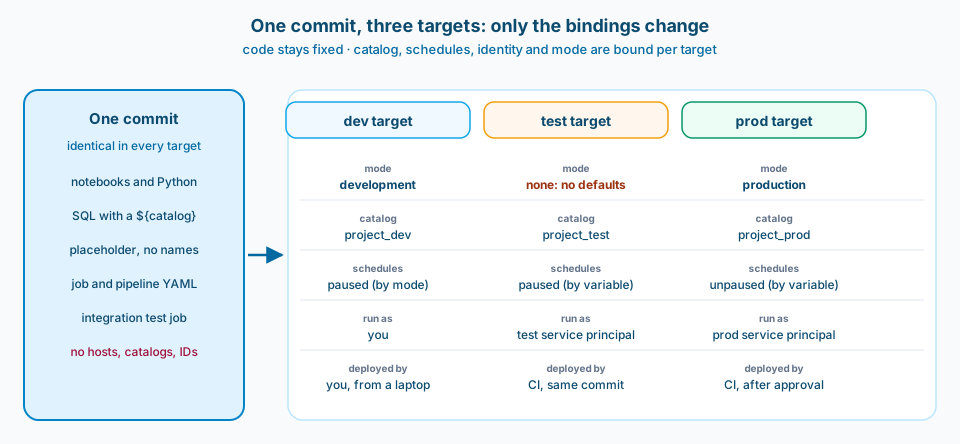
Abbildung 1. Die Code-Spalte ändert sich nie. Wenn sich zwischen Umgebungen etwas unterscheidet, gehört es in den Target-Block.
Kontext und Rahmenbedingung
Declarative Automation Bundles beschreiben Jobs, Pipelines und andere Ressourcen in YAML neben dem Code, und die Databricks CLI deployt sie pro Target. Bis März 2026 hießen sie Databricks Asset Bundles; die Umbenennung bricht nichts (bundle FAQs).
Das Bundle-Template, das ich pflege, ist klein: ein Catalog pro Umgebung, Serverless-Jobs, ein Integrationstest-Job, der mit dem Bundle deployt wird, und eine Azure DevOps Pipeline mit Workload Identity Federation. Es bringt zwei Targets mit, dev und prod. Was folgt, stammt aus der Entscheidung, was in diese Target-Blöcke gehört und was sich ändert, wenn ein drittes dazukommt.
Es ist das Databricks-Gegenstück zu Beitrag 11 (Umgebungsbindungen parametrisieren) und Beitrag 46 (per Commit befördern).
Design
1. Modi als Presets behandeln, nicht als Leiter
mode: development stellt Ressourcennamen deinen Benutzernamen voran, taggt Jobs und Pipelines, pausiert alle Zeitpläne und Trigger, erlaubt parallele Läufe und deaktiviert die Deployment-Sperre. mode: production prüft, dass Pipelines nicht im Entwicklungsmodus sind, prüft optional, dass du vom erwarteten Git-Branch deployst, und erwartet entweder einen Service Principal als run_as oder explizite run_as und permissions (deployment modes).
Modi sind optional, und es gibt keinen Test-Modus. Ein Test-Target ohne Modus bekommt kein Präfix, keine pausierten Zeitpläne und keine Production-Prüfungen, solange du keine Presets ergänzt.
Dann die Vorrangregel von derselben Seite: Ressourceneinstellungen überschreiben Presets, und Presets überschreiben den Modus. Das Beispiel in Learn ist genau das, was einen erwischt: Ein Zeitplan, der am Job auf UNPAUSED steht, bleibt unpausiert, auch wenn das Preset trigger_pause_status des Targets PAUSED sagt. Schreib pause_status: UNPAUSED ins Job-YAML, weil Prod es braucht, und jedes Target, das den Job deployt, lässt ihn nach Zeitplan laufen. Das gilt auch für den Development-Modus: Ein explizites pause_status: UNPAUSED bleibt auch in Dev unpausiert, also setz den Dev-Wert selbst (deployment modes).
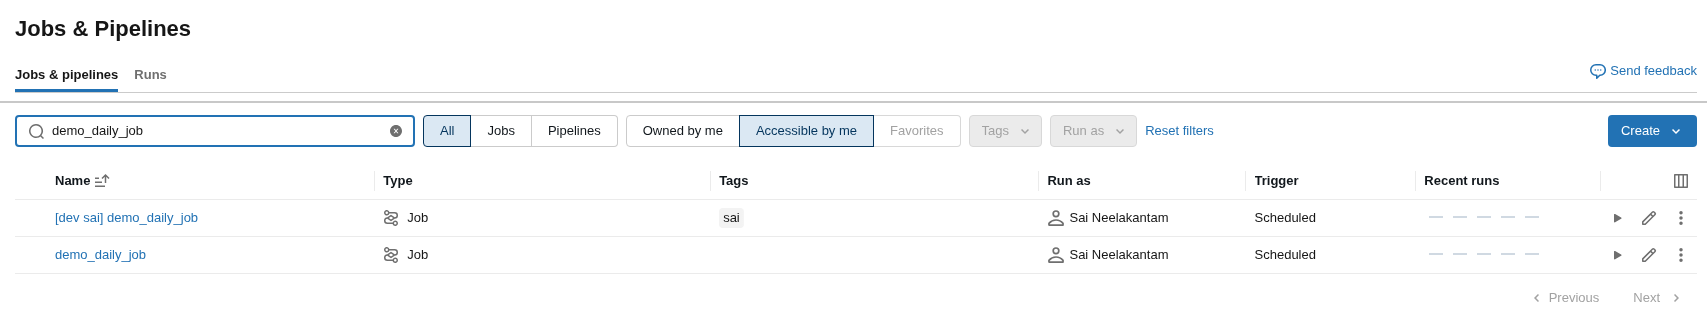
Abbildung 2. Ein Bundle, nach dev und prod deployt, ergibt zwei Jobs. Der Development-Modus hat das Präfix [dev sai] und ein Tag ergänzt, aber der Job setzt pause_status: UNPAUSED, also blieb die Dev-Kopie auf Scheduled. Zum Zeitpunkt dieses Screenshots hatte prod kein run_as und lief als der deployende Benutzer, was ich für ein echtes Prod-Target nicht empfehle. Abbildung 4 zeigt denselben Prod-Job, nachdem ich einen Service Principal ergänzt hatte.
Deshalb mache ich den Zeitplanstatus zu einer Variablen, standardmäßig pausiert, und hebe die Pause nur im Prod-Target auf:
variables:
  catalog:
    description: One Unity Catalog catalog per environment.
  schedule_pause_status:
    default: PAUSED
  test_sp_app_id:
    description: Application ID of the test run principal.
  prod_sp_app_id:
    description: Application ID of the prod run principal.

targets:
  dev:
    mode: development
    default: true
    variables:
      catalog: project_dev
  test:
    variables:
      catalog: project_test
    run_as:
      service_principal_name: ${var.test_sp_app_id}
  prod:
    mode: production
    git:
      branch: main
    variables:
      catalog: project_prod
      schedule_pause_status: UNPAUSED
    run_as:
      service_principal_name: ${var.prod_sp_app_id}
Der Job liest pause_status: ${var.schedule_pause_status}. Vergisst du, es zu setzen, bleibt der Job pausiert, und genau das ist der Fehlerfall, den du willst.
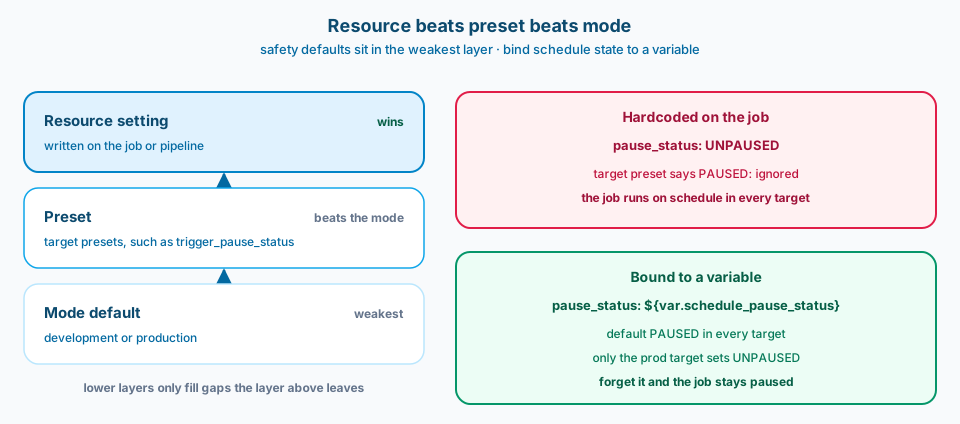
Abbildung 3. Die sicheren Standardwerte liegen auf der schwächsten Ebene. Alles, was du an die Ressource schreibst, gewinnt.
2. Den Catalog zum Deploy-Zeitpunkt binden, zur Laufzeit lesen
Ein Catalog pro Umgebung ist das einfachste Layout in Unity Catalog, das ich kenne, das Umgebungen schon durch seinen Aufbau trennt. Der Haken ist, wie der Catalog in den Code gelangt. Bundle-Variablen sind Werte zum Deploy-Zeitpunkt: Ein Job-Lauf verwendet die Werte seines letzten Deployments, und eine andere Variable zur Laufzeit zu übergeben, hat keine Wirkung. Learn rät, für Laufzeitwerte stattdessen Job-Parameter zu verwenden (substitutions and variables).
Also deklariert der Job einen Parameter catalog mit dem Standardwert ${var.catalog}. SQL verwendet einen Platzhalter ${catalog}, Python liest den Parameter, und keine Datei im Quellordner nennt einen Catalog. Ein kleiner Lint in CI lässt den Build scheitern, wenn er im Code einen Workspace-Host, ein Token, einen Catalog-Namen oder eine Cluster-ID findet.
Noch ein Randfall: Die Vorrangfolge für Variablen reicht von --var über Umgebungsvariablen mit BUNDLE_VAR_ und die Override-Datei pro Target bis zu den Target-Werten und dem Standardwert. Eine verirrte Umgebungsvariable auf einem Build-Agent schlägt still und leise dein YAML.
3. Deploy-Identität und Run-Identität trennen
CI deployt als Service Principal über Workload Identity Federation, es gibt also kein Secret, das rotiert werden muss. In Azure DevOps ist das eine föderierte Service Connection mit dem Azure-CLI-Task und DATABRICKS_AUTH_TYPE=azure-cli (authenticate with Azure DevOps); in GitHub Actions ist es github-oidc mit id-token: write (GitHub Actions). Der Workspace-Host bleibt aus dem Repo heraus und kommt aus Pipeline-Variablen.
Die Workloads laufen dann über run_as als ein anderer Service Principal pro Umgebung. Learn nennt das die sicherste Art, Produktion zu betreiben: Die Run-Identität kann weniger Berechtigungen haben als der Deployer, und nur dieser Principal oder jemand, der ihn verwenden darf, kann damit deployen (run identity).
In meiner Demo zeigt der Prod-Job den Service Principal unter Run as, während ich der Ersteller bleibe (Abbildung 4). Zwei Schritte lagen außerhalb des YAML: Ich brauchte die Rolle Service Principal User darauf, bevor das Deployment ihn als run_as setzen konnte, und der erste Lauf scheiterte mit UnauthorizedError, bis der Service Principal Zugriff auf den Workspace hatte. Der erneute Lauf war erfolgreich.
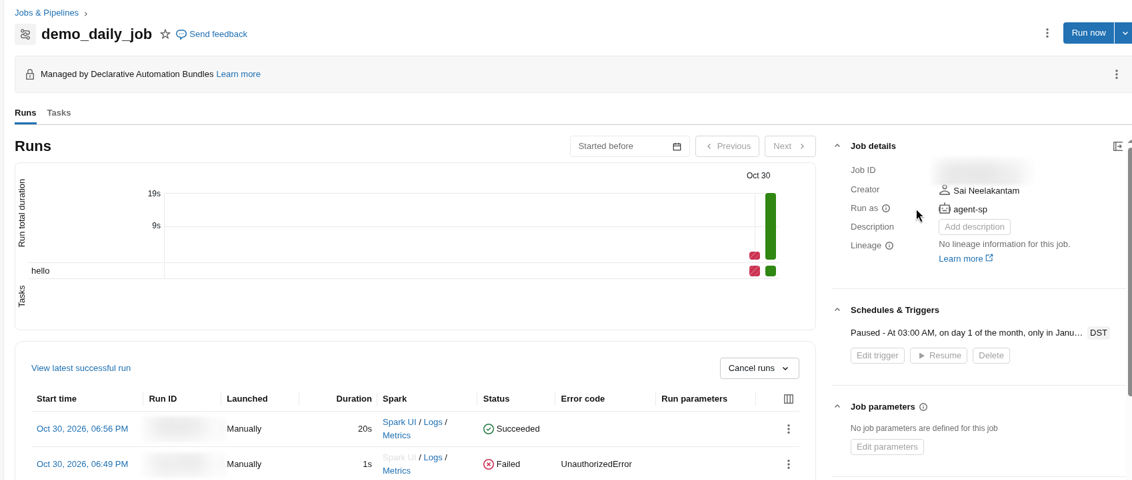
Abbildung 4. Der Prod-Job läuft als agent-sp, nicht als ich. Der erste Lauf scheiterte, bevor der Service Principal Zugriff auf den Workspace hatte; der erneute Lauf war erfolgreich. Der Zeitplan ist nur pausiert, weil die Demo ihn pausiert ausliefert.
Die Tücken stehen ebenfalls auf dieser Seite. Wenn sich die deployende Identität von run_as unterscheidet, werden nur Jobs und Pipelines unterstützt. run_as auf oberster Ebene und im Target nimmt einen Benutzer oder einen Service Principal, keine Gruppe, und Nicht-Admins können es nur auf sich selbst setzen. Model-Serving-Endpunkte schlagen fehl, wenn im selben Bundle run_as gesetzt ist. Wenn das Bundle über Jobs und Pipelines hinauswachsen wird, entscheide früh, wo diese Ressourcen liegen.
4. Berechtigungen auf Jobs sind keine Grants auf Daten
permissions auf oberster Ebene geben Benutzern, Gruppen und Service Principals CAN_VIEW, CAN_RUN oder CAN_MANAGE auf alles, was das Bundle deployt, und Databricks empfiehlt diesen Ansatz. Derselbe Principal darf nicht gleichzeitig im Mapping auf oberster Ebene und in den eigenen permissions einer Ressource stehen (bundle permissions).
Eine Falle bei der Benennung: Das Bundle nimmt CAN_RUN, und bei einem Job zeigt die Oberfläche das als Can Manage Run an (Abbildung 5).
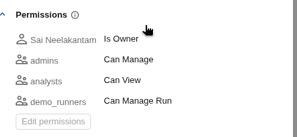
Abbildung 5. Berechtigungen auf dem deployten Prod-Job. Die Gruppe demo_runners hat im Bundle CAN_RUN bekommen und erscheint als Can Manage Run.
Diese Berechtigungen steuern, wer den Job sehen, ausführen oder bearbeiten darf. Was der Job lesen und schreiben darf, entscheiden sie nicht. Das regeln Grants in Unity Catalog für die Run-Identität auf ihrem eigenen Catalog, sodass der Test-Principal den Prod-Catalog nicht anfassen kann, selbst wenn jemand einen Job darauf richtet.
In meiner Demo hat der Run-Service-Principal USE CATALOG, USE SCHEMA, SELECT und MODIFY auf seinem eigenen Catalog (Abbildung 6).
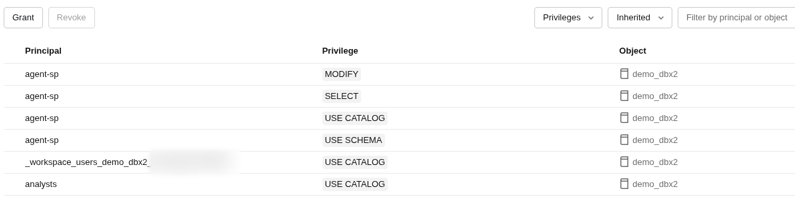
Abbildung 6. Datenzugriff ist ein Grant in Unity Catalog an die Run-Identität, getrennt davon, wer den Job ansehen oder ausführen darf.
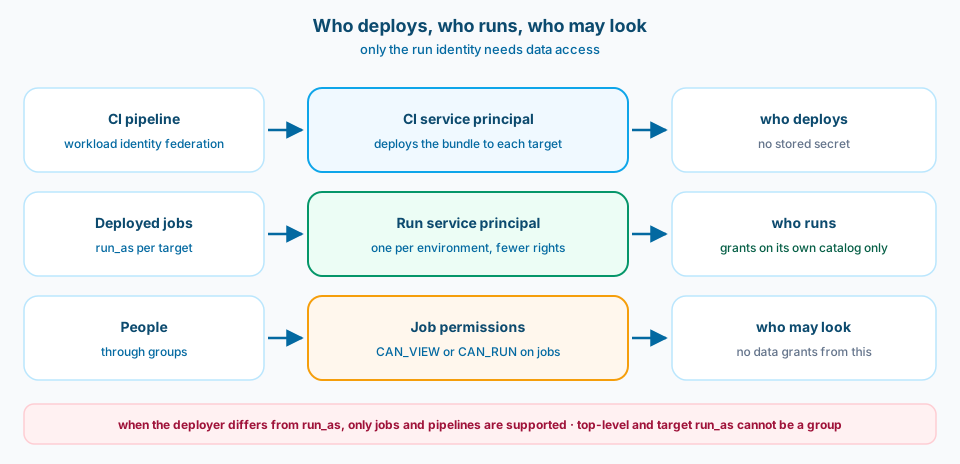
Abbildung 7. Drei verschiedene Fragen: wer deployt, wer ausführt und wer hineinschauen darf. Nur die Run-Identität braucht Datenzugriff.
5. Den Commit befördern und dort testen, wo er laufen wird
Jedes Target deployt denselben Commit. Die Pipeline meines Templates führt Unit-Tests für den Agent ohne Spark aus, deployt nach dev, führt den Integrationstest-Job des Bundles mit databricks bundle run auf Serverless aus und deployt erst dann nach prod, hinter einer Umgebungsfreigabe. Die Prüfung von git.branch im Production-Modus ist eine zweite Sperre: Ein Prod-Deploy von einem anderen Branch scheitert, außer jemand übergibt --force.
Dieselbe Idee wie in Beitrag 46: Was Prod erreicht, ist ein Commit, den du benennen kannst, nicht das, was gerade an der Spitze des Branches liegt.
6. Ein Test-Target nur ergänzen, wenn es etwas bringt
Zwei Targets sind eine echte Option. Ein drittes kostet einen Catalog, einen Run-Principal, Grants, eine Pipeline-Stage und Testdaten. Es lohnt sich, wenn andere Teams die Ausgabe vor Prod nutzen, wenn du Daten in Prod-Form brauchst, die Dev nicht halten darf, oder wenn ein Release auf einer stabilen gemeinsamen Umgebung abgenommen werden muss. Wenn Integrationstests gegen dev gut laufen, schafft ein Test-Target vor allem einen weiteren Ort für Drift.
Wenn ich eines ergänze, übernimmt es die Form von prod, nicht von dev: kein Development-Modus, ein Service Principal als run_as, pausierte Zeitpläne, ein eigener Catalog.
Häufige Fehler
UNPAUSED fest am Job eintragen. Ressourceneinstellungen schlagen Presets, also läuft test nach dem Zeitplan von prod.
Ein Test-Target ohne Modus und ohne Presets. Es bekommt weder die Development-Standardwerte noch die Production-Prüfungen.
Den Catalog zur Laufzeit als Bundle-Variable übergeben. Variablen werden beim Deploy aufgelöst; nimm einen Job-Parameter.
Catalog-Namen in Notebooks. Ein kopiertes Notebook schreibt in die falsche Umgebung.
Ein Service Principal für Deploy und Run. Es funktioniert, aber die Run-Identität braucht jetzt Deploy-Rechte.
Job-Berechtigungen als Datenzugriff. Diese regeln den Job, nicht die Tabellen.
So übernehmen oder anpassen
So übernehmen
- Identischer Code in jedem Target; die Umgebung nur in Target-Blöcken.
- Zeitpläne per Variable pausiert, nur in prod unpausiert.
- Der Catalog als Job-Parameter mit einer Bundle-Variable als Standardwert.
- Workload Identity Federation für CI und ein Service Principal als
run_asfür test und prod.
Vor dem Einsatz anpassen
- Ob du überhaupt ein Test-Target brauchst, anhand der Kosten aus Abschnitt 6.
- Ein Workspace mit einem Catalog pro Umgebung oder zusätzlich ein Workspace pro Umgebung, je nach deinen Anforderungen an Isolation und Netzwerk.
- Ob Jobs und Pipelines sich ein Bundle mit Ressourcen teilen, die kein separates
run_asverwenden können. - Schreibgeschützte Deployment-Ordner: Die Einstellung für unveränderliche Ordner ist in Private Preview und setzt die direkte Deployment-Engine voraus (configuration reference).
Probier es selbst aus
Die Bundle-Demo für dev und prod in meinem öffentlichen Repo tech-demos deployt einen Job in zwei Targets, damit du siehst, was der Development-Modus mit Jobnamen und Zeitplan macht.
Verwandte Notizen
- Fabric CI/CD: Wie begrenzt du den Blast Radius über Dev-Workspaces hinweg? (Umgebungsbindungen in Fabric parametrisieren)
- Fabric CI/CD: Die ganze Leiter mergen oder nur Fertiges per Cherry-Pick? (per Commit befördern)
- Data Agent Readiness: Sind Genie (und Fabric Agents) wirklich ein Modellierungsproblem? (wie der Prod-Catalog aussehen sollte, wenn ihm jemand Fragen stellt)
Das Bundle deployt alles überallhin. Entscheide, was sich pro Target unterscheidet, schreib es einmal auf und lass den Code gleich.