
Puntos clave
- Trata la pose como un bucle continuo de captura → inferencia → render con un único presupuesto de latencia.
- Mide p50 y p95 de extremo a extremo en la máquina de la demo, no solo los milisegundos del modelo.
- Separa el trabajo de inferencia de los overlays para que dibujar no bloquee el siguiente frame.
- Define una política de descarte de frames bajo carga (para UX en vivo, mejor descartar el más antiguo).
- Elige entre el estilo MediaPipe y el estilo YOLOPose por la forma del sistema, no por una diapositiva comparativa.
- Escribe las condiciones de captura (luz, distancia, número de personas) en la especificación del producto.
Apunta una cámara a una persona, dibuja un esqueleto y llámalo en vivo. La demo con un clip grabado aguanta. La retransmisión en vivo muchas veces no: la luz cambia, se pierden frames, el fondo se llena de cosas y la gente nota 80 ms de retraso aunque no sepa poner la cifra.
La precisión de los keypoints sin un bucle estable es una cifra de laboratorio. Lo que vive el usuario es el tiempo desde que se captura el frame hasta que aparece un overlay estable. Captura, inferencia y render son tres trabajos. Cada uno puede fallar mientras los otros dos parecen ir bien.
Modelo con nombre: captura → inferencia → render
- Captura: cámara o stream con una marca de tiempo en el momento de capturar el frame.
- Preproceso / inferencia: redimensiona una vez y calcula los keypoints en su propio worker.
- Render: overlays y reglas de confianza que nunca bloquean la siguiente captura.
- Contrato: un presupuesto de latencia compartido (de la marca de tiempo de captura al overlay), más una política explícita de contrapresión y descarte cuando se llena la cola.
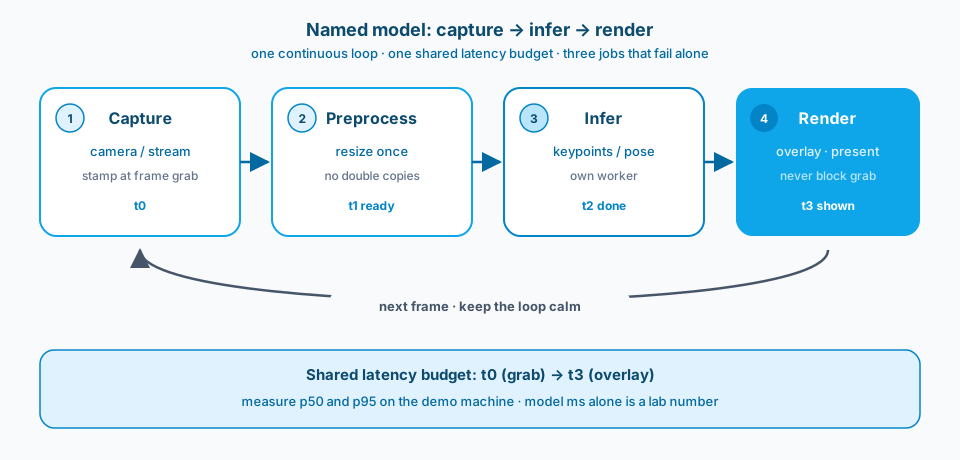
Figura 1. Captura, preproceso, inferencia, render. Las flechas continuas hacen avanzar el frame. El camino de vuelta es el siguiente frame. La banda bajo las etapas es el presupuesto de latencia que el usuario nota de verdad.
Contexto y restricción
Trato las demos de pose como ejercicios de producto. Los frames tienen que entrar en el pipeline. La inferencia tiene que terminar a tiempo. Los resultados tienen que mostrarse sin mentir sobre la confianza. Si cualquiera de esos trabajos se retrasa, la experiencia parece poco fiable aunque la tabla offline de keypoints se vea sólida.
No solo detectas articulaciones. Estás entregando un procesador de streams que tiene que seguir respondiendo cuando cambian las condiciones. Optimiza el bucle. Los milisegundos de un modelo en una GPU caliente siguen siendo una cifra de laboratorio hasta que los mides con la misma cámara y el mismo hardware que usará la aplicación.
Los runtimes de landmarks al estilo MediaPipe y los stacks al estilo YOLOPose, que primero detectan a la persona y luego estiman la pose, responden a preguntas distintas sobre quién se encarga de qué. La figura 2 muestra la diferencia de forma, no un ranking. Los landmarks locales y ligeros dejan menos etapas en el bucle. Detectar y luego estimar la pose aporta la asociación de varias personas y cuesta más etapas que presupuestar y observar. Elige la forma que encaje con tu presupuesto de latencia y de responsabilidad antes de discutir sobre mAP.
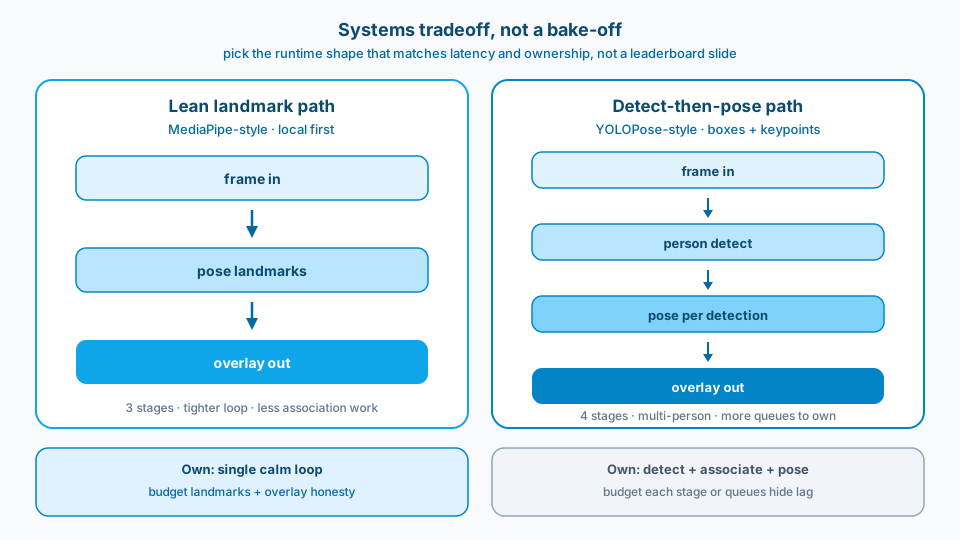
Figura 2. Un compromiso de sistemas, no una competición. A la izquierda, un camino ligero de landmarks. A la derecha se añade la detección de personas antes de la pose. Más etapas significa más sitios donde se esconden colas y errores de asociación.
La misma disciplina aparece en otros productos de visión. La figura 3 es una superficie de análisis de imágenes de Azure AI Vision tomada de Microsoft Learn. Las cajas y las etiquetas son otra salida. La lección se traslada igual: mantén explícito el camino del frame. En el trabajo de pose se cambian las cajas por landmarks, y aun así falla cuando la presentación parpadea o el camino es opaco.
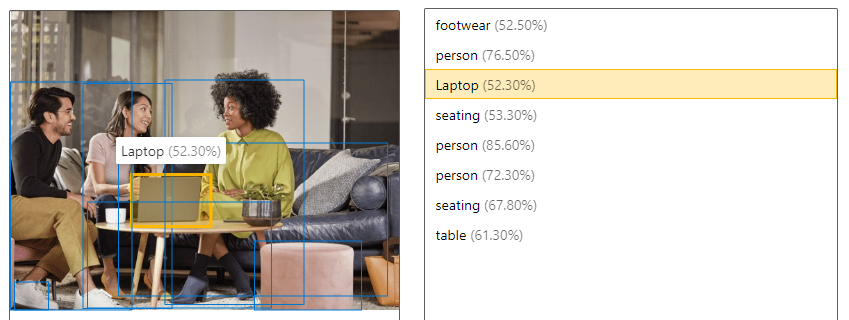
Figura 3. Los pipelines de visión funcionan cuando el camino del frame sigue siendo explícito: capturar, analizar, presentar. El trabajo de pose tiene el mismo bucle, solo que con landmarks en lugar de cajas. Fuente: Microsoft Learn: image analysis overview.
Diseño
1. Presupuesta primero el camino del frame
Fija la resolución objetivo, los FPS objetivo y la latencia máxima de extremo a extremo antes de recurrir a un backbone más pesado. Redimensiona solo lo que necesite el modelo. Evita conversiones de color redundantes y copias dobles entre CPU y GPU. Si la captura ya te da un tamaño útil, no lo amplíes por estética para luego reducirlo para la inferencia. La figura 1 es la superficie del presupuesto: cada etapa consume de la misma banda, desde la captura en t0 hasta el overlay en t3.
2. Separa la inferencia de la visualización
Mantén el worker de inferencia fuera del camino de render. Dibujar el esqueleto, suavizar trazas y los overlays vistosos no deben bloquear la siguiente captura. Cuando la visualización comparte hilo con la inferencia, un efecto bonito se convierte en un bug de latencia. Cuando la confianza parpadea, los overlays claros ganan a los decorativos.
3. Mide de extremo a extremo, en el entorno real
Instrumenta la marca de tiempo de captura, el frame preprocesado listo, la inferencia terminada y el frame presentado. Sigue p50 y p95, no solo medias. Mide en el portátil o el hardware edge en el que harás la demo, con la misma cámara y una carga de fondo parecida. Una cifra de una GPU de escritorio no compensa una máquina de demo que se limita por temperatura.
4. Define la contrapresión antes de que crezca la cola
Los sistemas en vivo necesitan una regla explícita de qué se descarta bajo carga. La figura 4 contrasta la opción para vivo (descartar el más antiguo y seguir mostrando frames frescos) con el fallo accidental (descartar el más nuevo y dejar que la cola se quede obsoleta mientras la captura sigue pareciendo ocupada). Limita la profundidad de la cola. Registra los descartes. No improvises la política en una demo de pasillo.
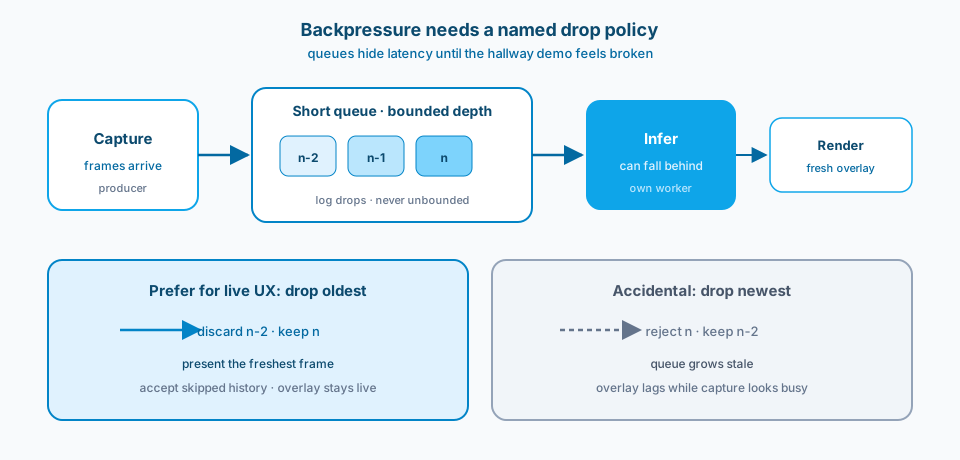
Figura 4. La contrapresión necesita una política de descarte con nombre. Para UX en vivo, mejor descartar el más antiguo. Descartar el más nuevo es como los overlays se retrasan mientras el camino de la cámara sigue pareciendo ocupado.
5. Diseña para una confianza inestable
Los modelos de pose se tambalean con oclusiones, ángulos raros y movimientos rápidos. Decide cómo se comporta la UI cuando baja la confianza: mantener brevemente la última pose buena, atenuar el esqueleto o marcar las articulaciones de baja confianza. Un temblor silencioso parece IA rota. La incertidumbre explícita parece un sistema honesto.
6. Mantén el pipeline lo bastante simple como para entenderlo
Menos etapas significa menos sitios donde esconder retrasos acumulados. Prefiere un camino aburrido: captura, preproceso ligero, inferencia, overlay, visualización. Añade tracking, asociación de varias personas o grabación solo cuando puedas nombrar la necesidad de producto. Cada etapa extra necesita su propia historia de contrapresión, o descartarás frames en el sitio equivocado sin saber por qué. Por eso la figura 2 importa antes de añadir un segundo detector "gratis".
7. Trata las condiciones de la demo como requisitos
La luz, la distancia a la cámara, el contraste de la ropa y el número de personas en el encuadre van en la especificación. Escríbelos. Un pipeline ajustado con una toma limpia de estudio falla en el pasillo de una conferencia. Si el producto tiene que funcionar en pasillos, recoge allí clips de fallos y ajusta contra esos clips, no contra imágenes de marketing.
Errores comunes
Optimizar solo el modelo. Recortas 3 ms de inferencia e ignoras 40 ms de sobrecarga de preproceso y copias. El usuario no nota nada. La diapositiva queda mejor.
Demos en condiciones ideales. Luz perfecta, una persona, de frente a la cámara, sin oclusiones. Los stakeholders aplauden. El primer usuario real se pone de lado bajo fluorescentes y el esqueleto se desmorona.
Un hilo compartido para inferir y dibujar. El código de los overlays frena la captura. Los FPS aparentes se hunden. Le echas la culpa al modelo.
Sin política de contrapresión. Las colas crecen, la latencia sube y luego descartas el más nuevo en lugar del más antiguo (o al revés) sin haberlo decidido. La figura 4 hace visible ese fallo.
Una UI que oculta la incertidumbre. Las articulaciones de baja confianza se siguen dibujando con opacidad total. La gente se fía de codos equivocados. Más tarde esa deuda de confianza aparece como "la visión artificial no funciona aquí".
Entornos que no coinciden. Entrenas y evalúas con datasets limpios. Lo despliegas en webcams donde la exposición automática pelea con la cara. El domain shift es lo normal, no una sorpresa.
Competición sin forma de producto. Comparas MediaPipe y YOLOPose en una tabla estática de precisión y nunca decides entre algo ligero para una persona o detectar y luego estimar la pose para varias. El ganador de la diapositiva pierde en el hardware en el que haces la demo.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Un presupuesto de latencia de extremo a extremo (de la captura al overlay) con un objetivo de p95 en el hardware de destino.
- Etapas del pipeline y responsables explícitos: captura, preproceso, inferencia, render.
- Una política de contrapresión y descarte de frames bajo carga (descartar el más antiguo o el más nuevo, con nombre).
- Reglas de visualización de la confianza para articulaciones de baja calidad y tracks perdidos.
- Condiciones de captura admitidas (luz, distancia, número de personas) como requisitos de producto.
- Una checklist de demo que encaje con esas condiciones, no un camino solo para estudio.
- Separación entre el trabajo de inferencia y los efectos de UI, para que los overlays no puedan frenar el bucle.
- La elección del runtime planteada como forma del sistema (landmarks ligeros o detectar y luego estimar la pose), no como un ranking.
Adáptalo antes de usarlo
Una resolución menor y modelos más simples te dan latencia y estabilidad. A cambio renuncias a precisión fina en las articulaciones. Para coaching, ergonomía o demos interactivas, suele ganar la estabilidad. Para análisis offline en los que puedes esperar, puede ganar la precisión. Nombra el producto antes de discutir sobre mAP.
La inferencia local reduce idas y vueltas y la superficie de privacidad. La inferencia en la nube puede ofrecer modelos más pesados y actualizaciones más fáciles. La UX en tiempo real rara vez perdona un salto de red inestable. Si tienes que ir a la nube, presupuesta el jitter y diseña un modo local degradado, o acepta que el tiempo real se convierte en casi tiempo real con reintentos.
El tracking de varias personas multiplica los errores de asociación y el coste de CPU. Haz bien el caso de una persona antes de prometer una multitud. Un único esqueleto nítido gana a tres que parpadean en todas las revisiones con stakeholders que he hecho.
Referencias principales: la documentación del runtime de pose que despliegues de verdad (por ejemplo MediaPipe Pose o un stack de keypoints equivalente), las guías de OpenCV sobre captura y tiempos, y la model card con las definiciones de keypoints y los casos de fallo conocidos. Prefiere la documentación del fabricante para tu destino de despliegue, no un benchmark de blog hecho con otra GPU. Para la superficie de Learn de la figura 3, consulta Microsoft Learn: image analysis overview.
Captura. Inferencia. Render. Tres etapas. Un presupuesto de latencia. Honestidad cuando baja la confianza.
Relacionado
- Azure Custom Vision: ¿cómo entrenas y ejecutas la clasificación de imágenes en una Azure Function? (la misma honestidad ante la baja confianza, detrás de una Azure Function)