
Das Wichtigste in Kürze
- Behandle Pose als kontinuierliche Schleife aus Erfassung → Inferenz → Rendering unter einem gemeinsamen Latenzbudget.
- Miss p50 und p95 Ende zu Ende auf dem Demo-Rechner, nicht nur die Millisekunden des Modells.
- Trenne die Inferenz von den Overlays, damit das Zeichnen nicht den nächsten Frame blockiert.
- Leg eine Regel für verworfene Frames unter Last fest (für Live-UX lieber den ältesten verwerfen).
- Wähle zwischen MediaPipe-Stil und YOLOPose-Stil nach der Form des Systems, nicht nach einer Vergleichsfolie.
- Schreib die Aufnahmebedingungen (Licht, Abstand, Anzahl der Personen) in die Produktspezifikation.
Kamera auf eine Person richten, ein Skelett zeichnen, das Ganze live nennen. Die Demo mit dem aufgezeichneten Clip übersteht das. Der Livestream oft nicht: Das Licht schwankt, Frames fallen weg, der Hintergrund wird unruhig, und Leute spüren 80 ms Verzögerung, auch wenn sie die Zahl nicht benennen können.
Keypoint-Genauigkeit ohne ruhige Schleife ist eine Laborzahl. Was Nutzer erleben, ist die Zeit vom Erfassen des Frames bis zu einem stabilen Overlay. Erfassung, Inferenz und Rendering sind drei Aufgaben. Jede kann scheitern, während die anderen beiden gut aussehen.
Benanntes Modell: Erfassung → Inferenz → Rendering
- Erfassung: Kamera oder Stream mit einem Zeitstempel beim Erfassen des Frames.
- Vorverarbeitung / Inferenz: einmal skalieren, Keypoints in einem eigenen Worker berechnen.
- Rendering: Overlays und Regeln zur Konfidenz, die nie das nächste Erfassen blockieren.
- Vertrag: ein gemeinsames Latenzbudget (vom Zeitstempel der Erfassung bis zum Overlay) plus eine explizite Regel für Backpressure und verworfene Frames, wenn die Queue voll läuft.
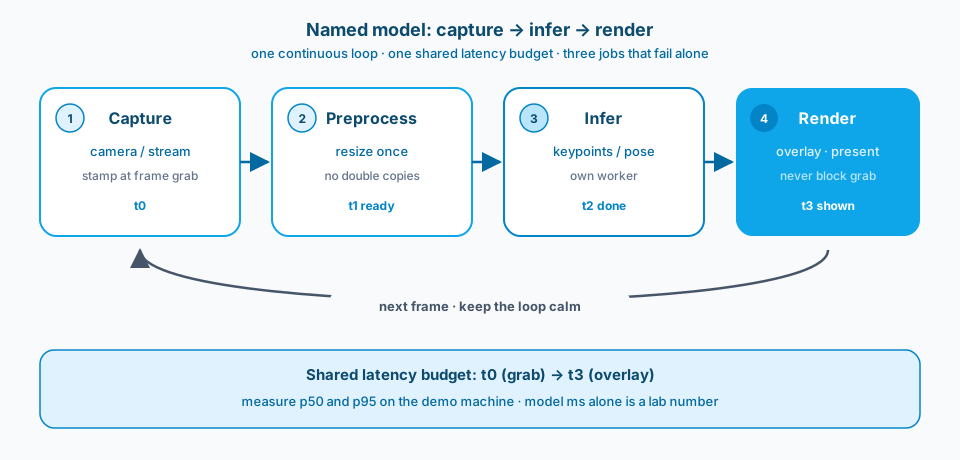
Abbildung 1. Erfassung, Vorverarbeitung, Inferenz, Rendering. Durchgezogene Pfeile bringen den Frame voran. Der Rückweg ist der nächste Frame. Das Band unter den Stufen ist das Latenzbudget, das Nutzer tatsächlich spüren.
Kontext und Rahmenbedingung
Ich behandle Pose-Demos als Produktübungen. Frames müssen in die Pipeline kommen. Die Inferenz muss rechtzeitig fertig werden. Ergebnisse müssen angezeigt werden, ohne bei der Konfidenz zu lügen. Wenn eine dieser Aufgaben hinterherhinkt, wirkt das Erlebnis unzuverlässig, auch wenn die Offline-Tabelle der Keypoints stark aussieht.
Du erkennst nicht nur Gelenke. Du lieferst einen Stream-Prozessor aus, der reaktionsschnell bleiben muss, wenn sich die Bedingungen ändern. Optimiere die Schleife. Die Millisekunden eines Modells auf einer warmen GPU bleiben eine Laborzahl, bis du sie mit derselben Kamera und Hardware misst, die die App nutzen wird.
Landmark-Runtimes im MediaPipe-Stil und Stacks im YOLOPose-Stil, die erst Personen erkennen und dann die Pose schätzen, beantworten unterschiedliche Fragen zur Verantwortung. Abbildung 2 zeigt den Unterschied in der Form, keine Rangliste. Schlanke lokale Landmarks halten weniger Stufen in der Schleife. Erst erkennen, dann Pose bringt die Zuordnung mehrerer Personen und kostet mehr Stufen, die du budgetieren und beobachten musst. Wähle die Form, die zu deinem Budget für Latenz und Verantwortung passt, bevor du über mAP streitest.
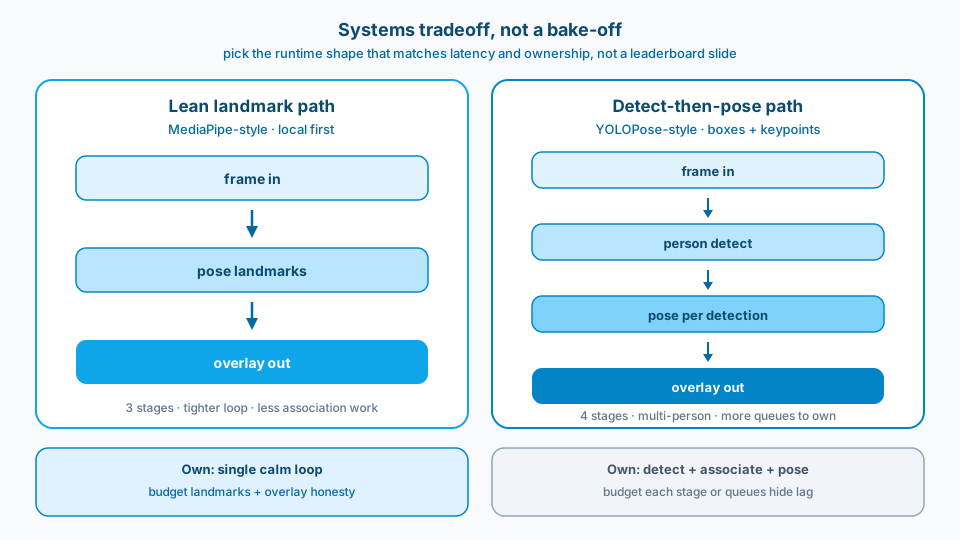
Abbildung 2. Ein Abwägen zwischen Systemen, kein Modellvergleich. Links ein schlanker Landmark-Pfad. Rechts kommt vor der Pose eine Personenerkennung dazu. Mehr Stufen heißt mehr Stellen, an denen sich Queues und Zuordnungsfehler verstecken.
Dieselbe Disziplin zeigt sich bei anderen Vision-Produkten. Abbildung 3 ist eine Oberfläche zur Bildanalyse mit Azure AI Vision aus Microsoft Learn. Boxen und Tags sind eine andere Ausgabe. Die Lehre lässt sich trotzdem übertragen: Halte den Pfad des Frames explizit. Bei Pose-Arbeit werden Boxen durch Landmarks ersetzt, und sie scheitert trotzdem, wenn die Darstellung flackert oder der Pfad undurchsichtig ist.
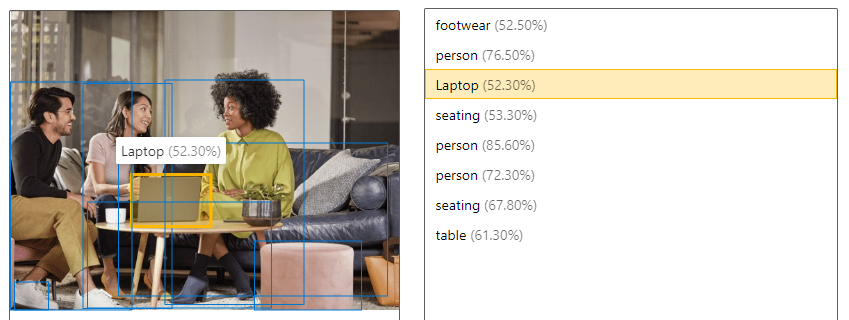
Abbildung 3. Vision-Pipelines funktionieren, wenn der Pfad des Frames explizit bleibt: erfassen, analysieren, darstellen. Pose-Arbeit hat dieselbe Schleife, nur mit Landmarks statt Boxen. Quelle: Microsoft Learn: image analysis overview.
Design
1. Zuerst den Pfad des Frames budgetieren
Leg Zielauflösung, Ziel-FPS und maximale Ende-zu-Ende-Latenz fest, bevor du zu einem schwereren Backbone greifst. Skaliere nur so weit, wie das Modell es braucht. Spar dir überflüssige Farbkonvertierungen und doppelte Kopien zwischen CPU und GPU. Wenn die Erfassung schon eine brauchbare Größe liefert, skaliere nicht der Optik wegen hoch und für die Inferenz wieder herunter. Abbildung 1 ist die Fläche des Budgets: Jede Stufe zehrt vom selben Band, vom Erfassen bei t0 bis zum Overlay bei t3.
2. Inferenz und Visualisierung trennen
Halte den Inferenz-Worker aus dem Render-Pfad heraus. Das Zeichnen des Skeletts, geglättete Spuren und aufwendige Overlays dürfen das nächste Erfassen nicht blockieren. Wenn sich Visualisierung und Inferenz einen Thread teilen, wird ein hübscher Effekt zum Latenz-Bug. Klare Overlays schlagen dekorative, wenn die Konfidenz flackert.
3. Ende zu Ende messen, in der echten Umgebung
Instrumentiere den Zeitstempel der Erfassung, den fertig vorverarbeiteten Frame, das Ende der Inferenz und den dargestellten Frame. Verfolge p50 und p95, nicht nur Durchschnitte. Miss auf dem Laptop oder der Edge-Hardware, auf der du die Demo zeigst, mit derselben Kamera und ähnlicher Hintergrundlast. Eine Zahl von einer Desktop-GPU entschuldigt keinen Demo-Rechner, der thermisch drosselt.
4. Backpressure benennen, bevor die Queue wächst
Live-Systeme brauchen eine explizite Regel, was unter Last verworfen wird. Abbildung 4 stellt die Wahl für Live-Betrieb (den ältesten verwerfen, weiter frische Frames zeigen) dem versehentlichen Fehler gegenüber (den neuesten verwerfen, die Queue veralten lassen, während die Erfassung noch beschäftigt aussieht). Begrenze die Tiefe der Queue. Logge verworfene Frames. Denk dir die Regel nicht erst bei einer Demo auf dem Flur aus.
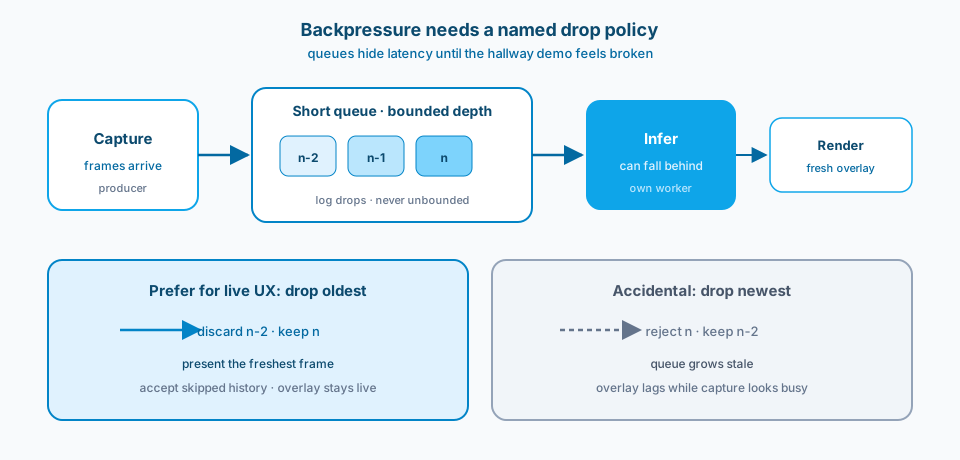
Abbildung 4. Backpressure braucht eine benannte Regel für das Verwerfen. Für Live-UX lieber den ältesten verwerfen. Den neuesten zu verwerfen, ist der Grund, warum Overlays hinterherhinken, während der Kamerapfad noch beschäftigt aussieht.
5. Für instabile Konfidenz entwerfen
Pose-Modelle wackeln bei Verdeckungen, ungewöhnlichen Winkeln und schnellen Bewegungen. Leg fest, wie sich die UI verhält, wenn die Konfidenz sinkt: die letzte gute Pose kurz halten, das Skelett ausblenden oder Gelenke mit niedriger Konfidenz markieren. Stilles Zittern wirkt wie kaputte KI. Explizite Unsicherheit wirkt wie ein ehrliches System.
6. Die Pipeline schlank genug halten, um sie zu verstehen
Weniger Stufen heißt weniger Stellen, an denen sich Rückstau versteckt. Setz auf einen langweiligen Pfad: Erfassung, leichte Vorverarbeitung, Inferenz, Overlay, Anzeige. Füg Tracking, die Zuordnung mehrerer Personen oder Aufzeichnung nur hinzu, wenn du den Produktbedarf benennen kannst. Jede zusätzliche Stufe braucht ihre eigene Antwort auf Backpressure, sonst verwirfst du Frames an der falschen Stelle und weißt nicht, warum. Deshalb zählt Abbildung 2, bevor du einen zweiten Detektor "gratis" dazunimmst.
7. Demo-Bedingungen als Anforderungen behandeln
Licht, Abstand zur Kamera, Kontrast der Kleidung und Anzahl der Personen im Bild gehören in die Spezifikation. Schreib sie auf. Eine Pipeline, die auf eine saubere Studioaufnahme abgestimmt ist, scheitert auf dem Flur einer Konferenz. Wenn das Produkt auf Fluren funktionieren muss, sammle dort Clips mit Fehlern und stimm gegen diese Clips ab, nicht gegen Marketingbilder.
Häufige Fehler
Nur das Modell optimieren. Du sparst 3 ms bei der Inferenz und ignorierst 40 ms Overhead für Vorverarbeitung und Kopien. Der Nutzer spürt nichts. Die Folie sieht besser aus.
Demos unter Idealbedingungen. Perfektes Licht, eine Person, frontal zur Kamera, keine Verdeckung. Die Stakeholder applaudieren. Der erste echte Nutzer steht seitlich unter Neonlicht, und das Skelett fällt auseinander.
Ein gemeinsamer Thread für Inferenz und Zeichnen. Der Overlay-Code bremst die Erfassung aus. Die sichtbare FPS bricht ein. Du gibst dem Modell die Schuld.
Keine Regel für Backpressure. Queues wachsen, die Latenz steigt, und dann verwirfst du den neuesten statt den ältesten Frame (oder umgekehrt), ohne dich bewusst dafür entschieden zu haben. Abbildung 4 macht genau diesen Fehler sichtbar.
Eine UI, die Unsicherheit versteckt. Gelenke mit niedriger Konfidenz werden trotzdem voll deckend gezeichnet. Leute vertrauen falschen Ellbogen. Später zeigt sich diese Vertrauensschuld als "Computer Vision funktioniert hier nicht".
Umgebungen, die nicht passen. Training und Evaluierung auf sauberen Datensätzen. Ausgeliefert auf Webcams, bei denen die automatische Belichtung gegen das Gesicht arbeitet. Domain Shift ist der Normalfall, keine Überraschung.
Modellvergleich ohne Produktform. Du vergleichst MediaPipe und YOLOPose anhand einer statischen Genauigkeitstabelle und entscheidest nie zwischen schlank für eine Person und erst erkennen, dann Pose für mehrere Personen. Der Sieger auf der Folie verliert auf der Hardware, auf der du die Demo tatsächlich zeigst.
So übernehmen oder anpassen
So übernehmen
- Ein Ende-zu-Ende-Latenzbudget (von der Erfassung bis zum Overlay) mit einem p95-Ziel auf der Zielhardware.
- Explizite Pipeline-Stufen und Verantwortlichkeiten: Erfassung, Vorverarbeitung, Inferenz, Rendering.
- Eine Regel für Backpressure und verworfene Frames unter Last (den ältesten oder den neuesten verwerfen, ausdrücklich benannt).
- Regeln zur Darstellung der Konfidenz für Gelenke von geringer Qualität und verlorene Tracks.
- Unterstützte Aufnahmebedingungen (Licht, Abstand, Anzahl der Personen) als Produktanforderungen.
- Eine Demo-Checkliste, die zu diesen Bedingungen passt, nicht nur ein Pfad fürs Studio.
- Trennung der Inferenz von UI-Effekten, damit Overlays die Schleife nicht ausbremsen können.
- Die Wahl der Runtime als Form des Systems formuliert (schlanke Landmarks oder erst erkennen, dann Pose), nicht als Rangliste.
Vor dem Einsatz anpassen
Geringere Auflösung und einfachere Modelle bringen Latenz und Stabilität. Dafür gibst du feinkörnige Präzision bei den Gelenken auf. Für Coaching, Ergonomie oder interaktive Demos gewinnt meist die Stabilität. Für Offline-Analysen, bei denen du warten kannst, kann die Genauigkeit gewinnen. Benenne das Produkt, bevor du über mAP streitest.
Lokale Inferenz spart Roundtrips und verkleinert die Angriffsfläche für den Datenschutz. Inferenz in der Cloud kann schwerere Modelle und einfachere Updates bieten. Echtzeit-UX verzeiht einen wackligen Netzwerksprung selten. Wenn du in die Cloud musst, plane Jitter ein und entwirf einen eingeschränkten lokalen Modus, oder akzeptier, dass aus Echtzeit nahezu Echtzeit mit Retries wird.
Tracking mehrerer Personen vervielfacht Zuordnungsfehler und CPU-Kosten. Liefere eine Person gut aus, bevor du eine Menschenmenge versprichst. Ein scharfes einzelnes Skelett schlägt in jedem Stakeholder-Review, das ich gemacht habe, drei flackernde.
Wichtigste Quellen: die Dokumentation der Pose-Runtime, die du tatsächlich auslieferst (zum Beispiel MediaPipe Pose oder ein gleichwertiger Keypoint-Stack), die Hinweise von OpenCV zu Erfassung und Timing und die Model Card mit den Definitionen der Keypoints und bekannten Fehlerfällen. Setz auf die Herstellerdokumentation für dein Deployment-Ziel, nicht auf einen Blog-Benchmark von einer anderen GPU. Zur Learn-Oberfläche in Abbildung 3 siehe Microsoft Learn: image analysis overview.
Erfassung. Inferenz. Rendering. Drei Stufen. Ein Latenzbudget. Ehrlichkeit, wenn die Konfidenz sinkt.
Verwandte Notizen
- Azure Custom Vision: Wie trainierst und betreibst du Bildklassifikation in einer Azure Function? (dieselbe Ehrlichkeit bei niedriger Konfidenz, hinter einer Azure Function)