

Puntos clave
- Mantén la UI aburrida: subir, predecir, mostrar etiqueta y confianza.
- Valida el tipo, el tamaño y que la imagen se pueda decodificar en el servidor antes de la inferencia.
- Las credenciales de predicción se quedan en el backend; el navegador solo habla con la API de la aplicación.
- Trata la confianza baja como un resultado de pleno derecho en la UI, no como una victoria silenciosa de la etiqueta principal.
- Registra en cada llamada el correlation id, el id de la iteración, la latencia y las N etiquetas principales.
- Publica las iteraciones de Custom Vision como releases de la aplicación: con un conjunto de smoke test y rollback.
Custom Vision te lleva rápido de imágenes etiquetadas a un endpoint de predicción. El trabajo de producto empieza después del camino feliz: subidas malas, respuestas con poca confianza, iteraciones que rompen el endpoint publicado y ninguna pista cuando la etiqueta es incorrecta.
Mantén la UI aburrida: subir, predecir, mostrar etiqueta y confianza. Pon la complejidad en la calidad de los datos, la validación, los límites de peticiones, el logging y un camino de publicación controlado para las nuevas iteraciones.
Modelo con nombre: subir → predecir → explicar → iterar
- Subir: comprobaciones en el servidor de tipo, tamaño y decodificación antes de gastar una llamada de inferencia.
- Predecir: la API de la aplicación se encarga de los timeouts, los reintentos y las credenciales (claves o managed identity).
- Explicar: la UI siempre muestra la etiqueta y la confianza; una puntuación baja es un resultado de pleno derecho.
- Iterar: entrenar, pasar un smoke test con un conjunto fijo de imágenes, publicar la iteración y mantener un camino de rollback.
- Contrato: Custom Vision se encarga de la puntuación; la aplicación web, de la higiene, las claves y las pistas.
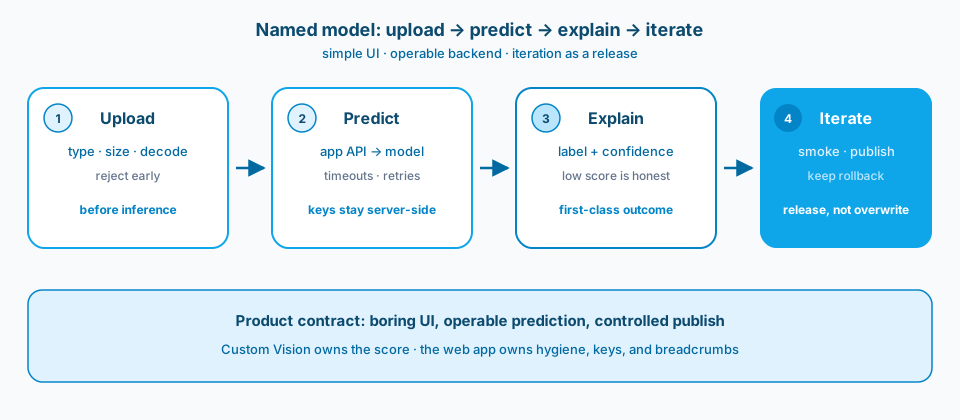
Figura 1. Subir, predecir, explicar, iterar. La UI se mantiene simple a propósito. La operabilidad está en la validación, el límite de la API, una confianza honesta y un camino de publicación que puedas revertir.
Contexto y restricción
He visto demasiadas demos de visión que parecen pulidas hasta la primera subida mala, la primera respuesta con poca confianza o la primera iteración del modelo que rompe el endpoint publicado. Una buena demo se convierte en producto cuando la validación de entradas, los límites de peticiones, el logging y un camino para reentrenar están ahí desde el primer día.
Custom Vision (o el camino equivalente de clasificación de imágenes en Azure que elijas dentro de Microsoft Foundry / Azure AI Services) debe encargarse de la predicción. La aplicación web debe encargarse de la higiene de las subidas, de la autenticación si la necesitas, de presentar etiquetas y confianza y de las pistas operativas que te permitan depurar después las respuestas incorrectas. Si la UI intenta ser ingeniosa, la gente deja de fiarse de la puntuación. Si el backend se salta lo básico, no puedes operar el ingenio que has entregado.
La figura 2 es la superficie de Learn que hace visible el contrato con el usuario: etiquetas y confianza, no una segunda historia inventada en la capa de la aplicación.
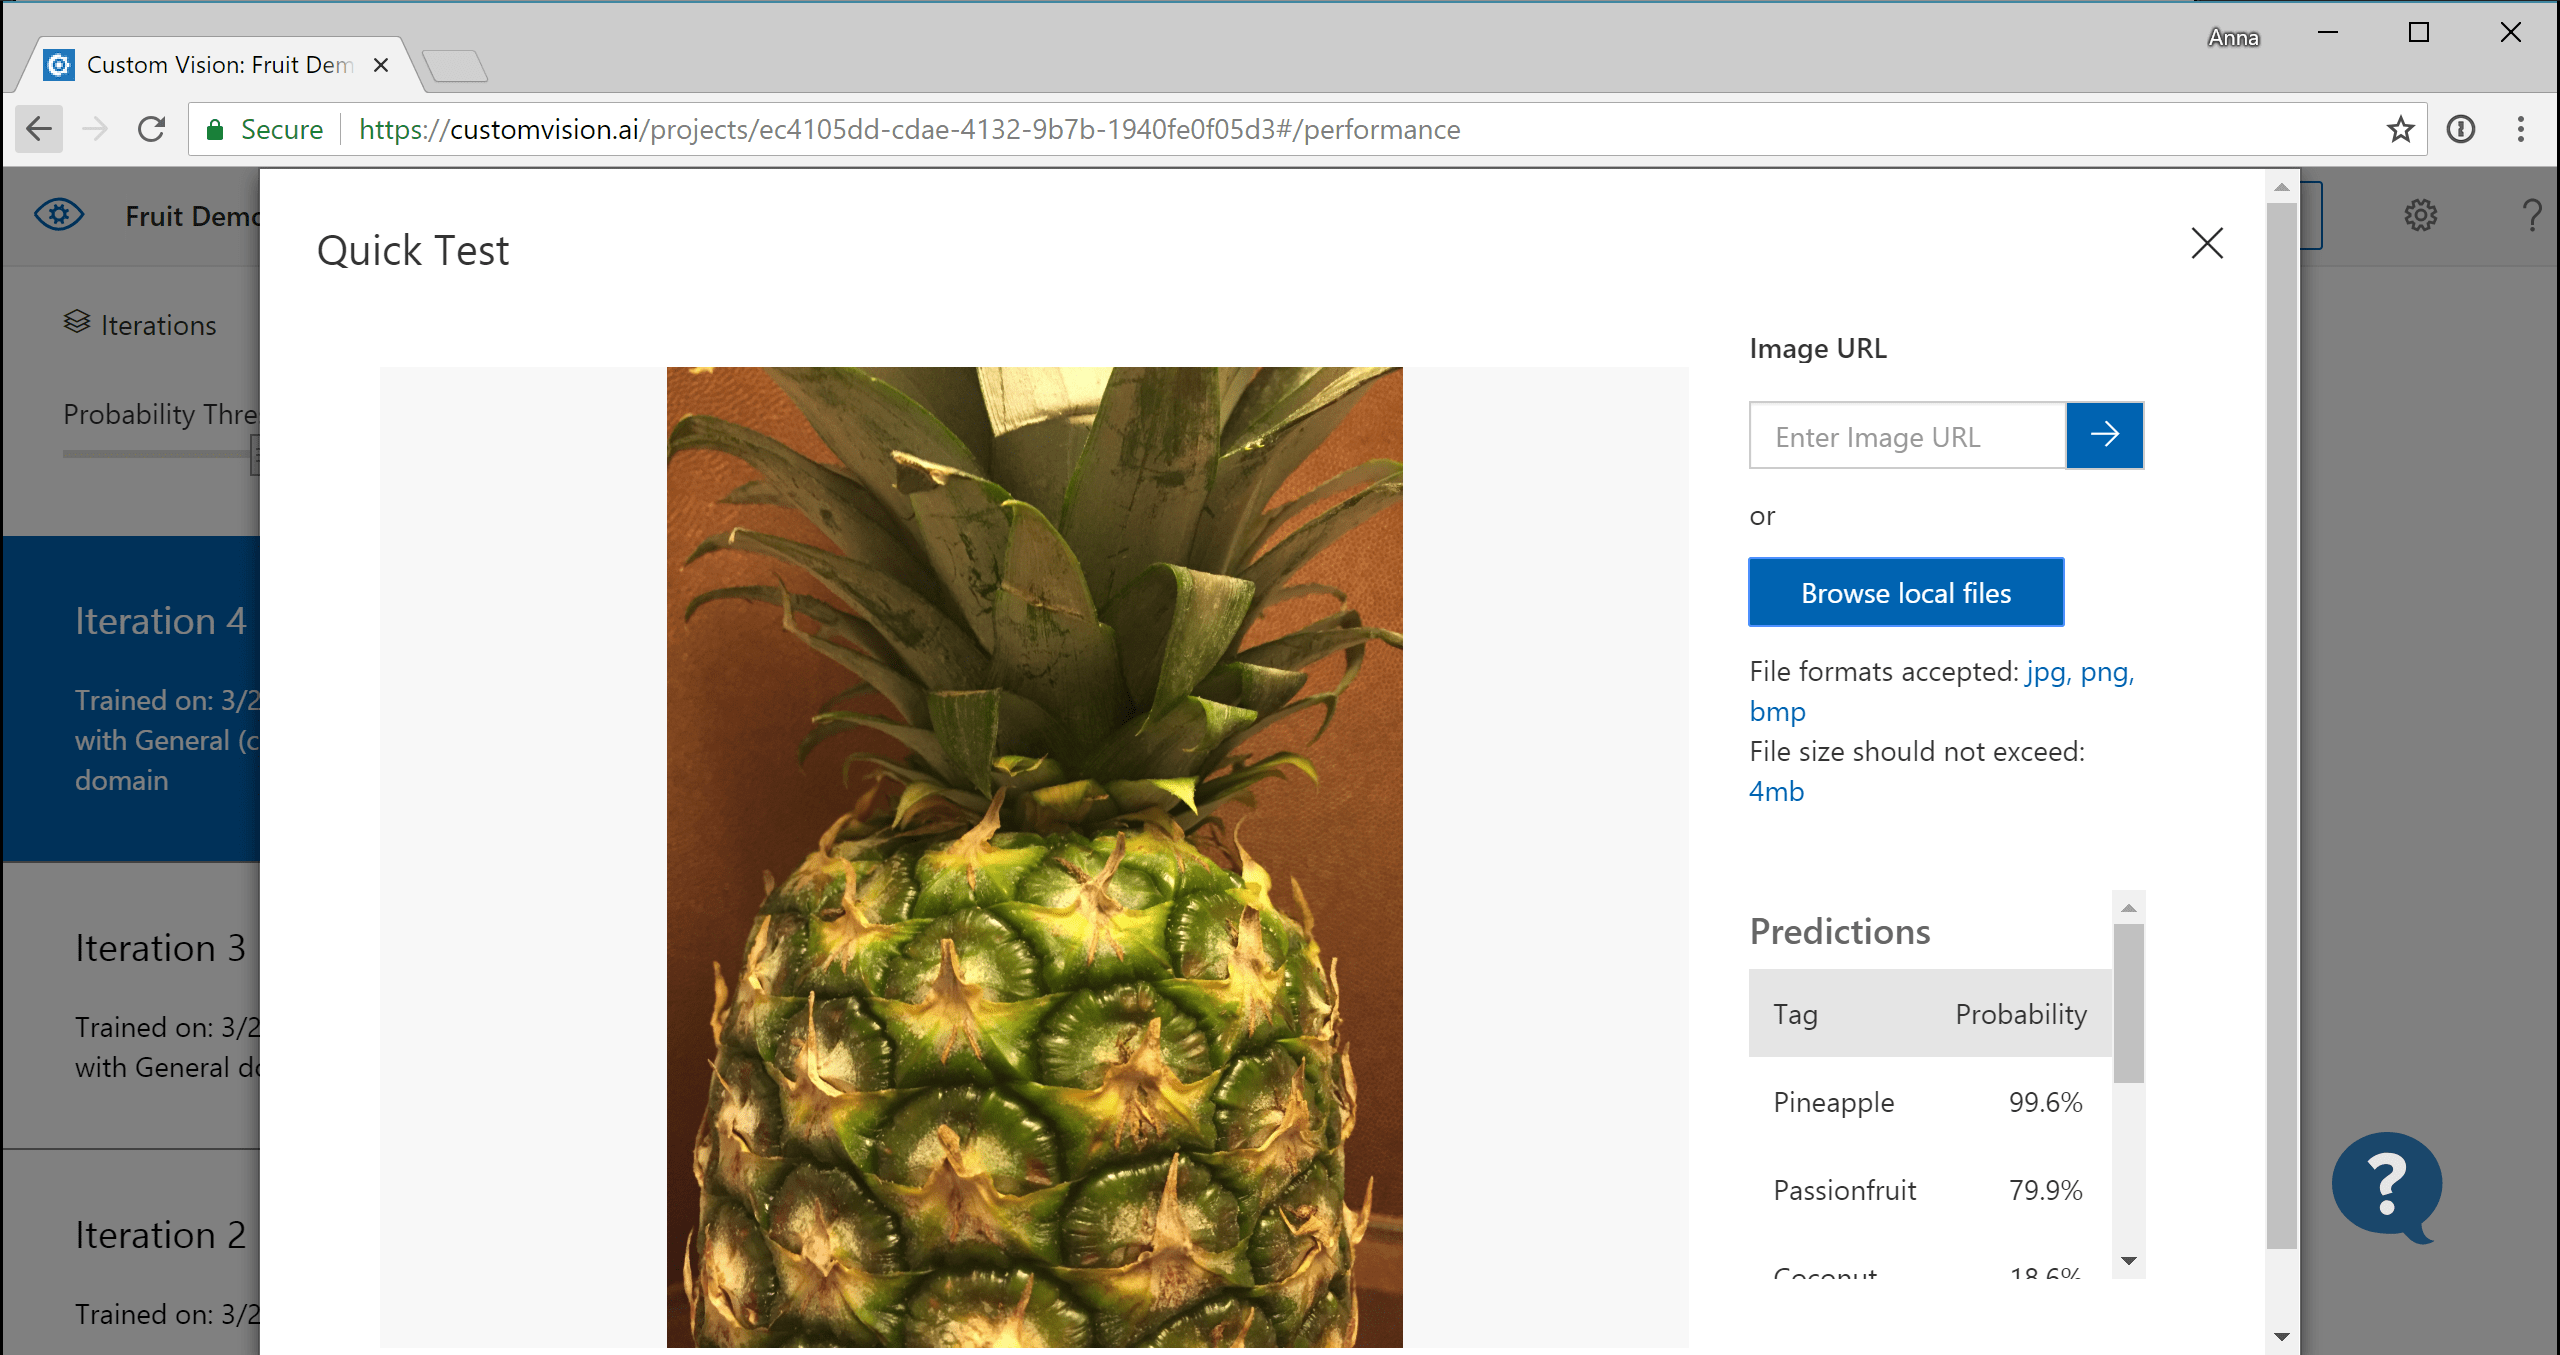
Figura 2. Las etiquetas y la confianza son el contrato con el usuario. La UI de entrenamiento es donde se itera; la aplicación web no debería inventar una segunda historia. Fuente: Microsoft Learn: Custom Vision overview.
La figura 3 es la página principal del proyecto, donde viven las iteraciones. Trata un endpoint publicado como un artefacto de release, no como algo que se sobrescribe a la ligera después de comer.
Figura 3. Las iteraciones viven en la superficie del proyecto. Trata los endpoints publicados como artefactos de release, no como algo que se sobrescribe a la ligera. Fuente: Microsoft Learn: Custom Vision overview.
1. Empieza por el flujo del usuario, no por la model card
El recorrido debe ser evidente: elegir una imagen, enviarla, ver el resultado. Un diseño mínimo mantiene el foco en la interacción principal. Los interruptores extra, los paneles avanzados y los gráficos decorativos pueden esperar hasta que el camino feliz sea aburridamente fiable. Si el flujo es complicado, la funcionalidad de IA parece más difícil de lo que es. La figura 1 es ese camino aburrido dibujado como cuatro trabajos.
2. Valida antes de gastar una llamada de inferencia
Comprueba en el servidor el tipo de archivo, el tamaño y que la imagen se pueda decodificar. Rechaza con claridad. No mandes blobs arbitrarios al endpoint de predicción con la esperanza de que salga bien. La validación protege el coste, protege el servicio de la basura y da al usuario un fallo más rápido que un timeout disfrazado de "something went wrong".
3. Envuelve la predicción en un comportamiento de backend aburrido y predecible
Los timeouts, los reintentos ante fallos transitorios y las respuestas de error mapeadas van en la capa de la API. Devuelve fallos en lenguaje claro cuando la inferencia falle. Muestra la etiqueta y la confianza en lenguaje claro cuando funcione. La confianza baja es un resultado de pleno derecho: dilo en la UI en lugar de fingir que la etiqueta principal es palabra sagrada.
4. Mantén los secretos y las claves fuera del navegador
Las claves de predicción y de entrenamiento van en el servidor o en patrones con managed identity, no en los bundles del frontend. Una página estática que llama directamente a Custom Vision es el camino corto hacia la filtración de claves y un consumo de cuota sin control. El navegador sube a tu aplicación; tu aplicación llama a Azure. La figura 4 es el reparto de responsabilidades que mantiene la clave fuera del código fuente de la página.
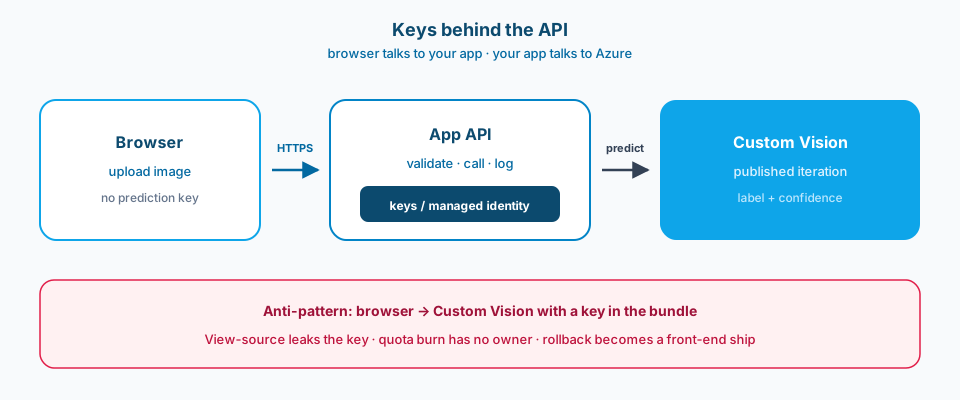
Figura 4. El navegador habla con tu aplicación. Tu aplicación habla con Custom Vision. Las claves y la managed identity se quedan en el servidor. Una clave en el navegador es como el consumo de cuota acaba teniendo un dueño silencioso.
5. Registra lo suficiente para depurar malos resultados
Guarda los correlation ids, el nombre del modelo o el id de la iteración, la latencia, las etiquetas principales y, si lo recoges, si el usuario aceptó o corrigió el resultado. No necesitas la imagen original para siempre en todos los entornos, pero sí un camino para reproducir cada tipo de fallo. Sin ids de iteración en los logs, el análisis de causa raíz se convierte en folclore tras la siguiente publicación.
6. Trata cada iteración de Custom Vision como una release
Las etiquetas nuevas, las nuevas imágenes de entrenamiento y una iteración recién publicada cambian el comportamiento del producto. Promociona las iteraciones como promocionas las builds de la aplicación: anota qué ha cambiado, pasa un smoke test con un conjunto fijo de imágenes y mantén un rollback a la iteración publicada anterior. Los clasificadores estrechos se desvían cuando el mundo cambia. Planifica esa desviación en lugar de descubrirla en una reunión con stakeholders. La figura 5 es la forma de la release.
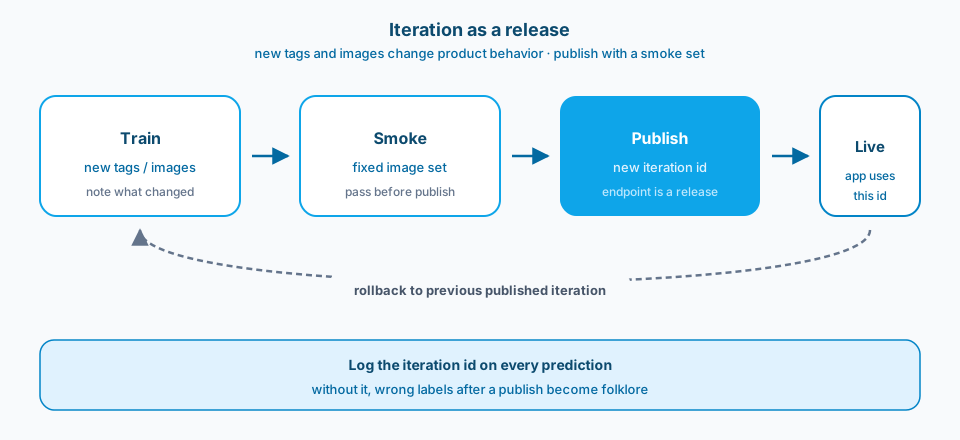
Figura 5. Entrenar, smoke test, publicar, en vivo. El retorno discontinuo es el rollback a la iteración publicada anterior. Registra el id de la iteración en cada predicción para poder diagnosticar una publicación mala.
Errores comunes
Solo el camino feliz de la demo. Un PNG de un objeto claro sobre fondo blanco. Los usuarios reales suben fotos HEIC del móvil, capturas de pantalla y escaneos de cinco megas. La aplicación se atraganta o el modelo se encoge de hombros.
Ignorar la confianza. Mostrar siempre la etiqueta principal en negrita. Los usuarios se fían de 0.41 igual que de 0.97. Así es como las malas decisiones operativas acaban teniendo una UI bonita.
Claves en el navegador. Alguien mira el código fuente, copia la clave de predicción y tu factura del mes siguiente lo explica todo. La figura 4 hace visible ese fallo.
Sin disciplina en las iteraciones. Reentrenar en el portal, publicar y cruzar los dedos. Las imágenes de smoke test de ayer ahora se clasifican mal y nadie sabe qué publicación lo causó. La figura 5 es la disciplina que lo evita.
Logging sin identidad del modelo. Sabes que la petición falló o se vio rara. No sabes qué iteración la sirvió. El soporte se convierte en arqueología.
Subidas sin límite. Sin límite de tamaño, sin rate limit y sin autenticación en una herramienta interna que de algún modo acabó siendo externa. El coste de inferencia y el abuso llegan juntos.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Validación en el servidor de tipo, tamaño y decodificación antes de la predicción.
- Credenciales de predicción solo en el backend; el navegador habla con la API de la aplicación.
- La UI siempre muestra etiqueta y confianza; el umbral de confianza baja lo define el producto.
- Los logs incluyen el correlation id, el id de la iteración o del modelo, la latencia y las N etiquetas principales.
- Las iteraciones publicadas se tratan como releases con un conjunto de smoke test y rollback.
- Los rate limits y la postura de autenticación están documentados para la exposición interna y la pública.
- La responsabilidad del reentrenamiento y las reglas de retención de datos están por escrito antes de la primera subida en producción.
Adáptalo antes de usarlo
Custom Vision se monta rápido para una tarea acotada. No sustituye a un stack de visión bien diseñado cuando necesitas detección, segmentación o una latencia estricta en el edge. Elígelo cuando unos ejemplos etiquetados y una respuesta de clasificación basten para la decisión de producto.
Una aplicación web ligera es fácil de explicar y fácil de reemplazar. Una capa de producto más completa (autenticación, historial, cola de revisión humana) lleva más tiempo, pero es lo que suelen necesitar las herramientas internas a partir de la segunda semana. No finjas que la página de subida es todo el sistema si los revisores tienen que corregir etiquetas para el reentrenamiento.
Alojar el modelo en Azure o exportarlo a runtimes de edge cambia cómo resuelves las actualizaciones y el funcionamiento offline. Decide según adónde pueden viajar las imágenes, no según qué quickstart pegaste primero.
Referencias principales: Microsoft Learn sobre Custom Vision, clasificación de imágenes y los patrones de autenticación de Azure AI / AI Services para mantener las claves fuera del navegador. Usa los nombres actuales de Microsoft Foundry cuando tu destino de despliegue haya pasado a esa marca.
Subir. Predecir. Explicar. Iterar. Cuatro trabajos. Una puntuación en la que el usuario pueda confiar de verdad.
Relacionado
- Estimación de poses: ¿MediaPipe o YOLOPose para clasificar poses en tiempo real? (un bucle de visión en tiempo real con su propio presupuesto de latencia)