

Puntos clave
- Fabric ejecuta el trabajo; Airflow se encarga de la planificación, el grafo, los reintentos y las alertas.
- Éxito significa estado final en Fabric, no que se aceptara el disparo.
- Prefiere muchas tareas ligeras con el nombre del paso del pipeline.
- Pon los quality gates en el DAG, donde se vean.
- No reconstruyas las transformaciones de Fabric dentro de operadores de Airflow.
- Recurre a Airflow cuando las dependencias entre jobs necesiten un grafo honesto.
Sí, si los tratas como dos planos. Fabric debe hacer el trabajo. Airflow debe encargarse de la planificación, el grafo de dependencias, los reintentos y lo que ve la guardia de cada ejecución.
Airflow se gana su sitio cuando un entorno de Fabric se ve bien en el portal y aun así se viene abajo porque tres jobs tienen que terminar antes de que pueda empezar un cuarto. Las planificaciones nativas cubrían jobs sueltos. No explicaban un grafo. Meter la coordinación en notebooks hacía que cada cambio pareciera más arriesgado que la propia transformación.
Modelo con nombre: dos planos
- Plano de ejecución (Fabric): notebooks, pipelines, trabajo en el lakehouse, operaciones de warehouse, refresh semántico.
- Plano de orquestación (Airflow): planificación, dependencias, reintentos, alertas, un historial de ejecuciones que las personas puedan leer.
- Contrato: cada tarea de Airflow espera al estado final en Fabric, no a que se acepte el disparo.
- Forma: muchas tareas ligeras con el nombre del paso del pipeline; los quality gates son pasos visibles del DAG.
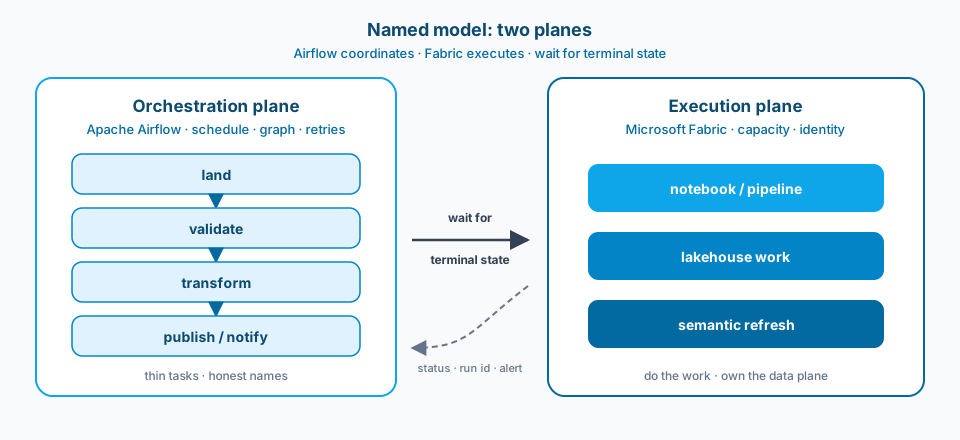
Figura 1. Airflow coordina, Fabric ejecuta. La flecha continua es esperar al estado final. El retorno discontinuo es el estado, el run id y el texto de la alerta. Nada de disparar y olvidarse.
Contexto y restricción
Los notebooks y pipelines de Fabric son muy buenos haciendo trabajo. Son más flojos como calendario y grafo de dependencias de todo lo que los rodea. En cuanto el camino es cargar, validar, transformar y publicar, necesitas un plano de orquestación que no finja ser otro motor de transformación.
Airflow encaja cuando quieres un DAG honesto. Mantén las tareas ligeras. Llama a Fabric. No reconstruyas Fabric dentro de los operadores porque un viernes resultara cómodo. Si empiezas a reimplementar transformaciones en Python de Airflow, has creado una segunda fuente de verdad. La comodidad es lo que hace que las capas de orquestación engorden y luego se vuelvan opacas.
Los Airflow jobs de Fabric hacen concreta esa separación en el propio producto. La figura 2 es el mosaico de Learn que inicia un DAG cuya tarea es ejecutar un elemento de Fabric, no alojar la lógica de Spark. El orquestador se mantiene ligero a propósito.
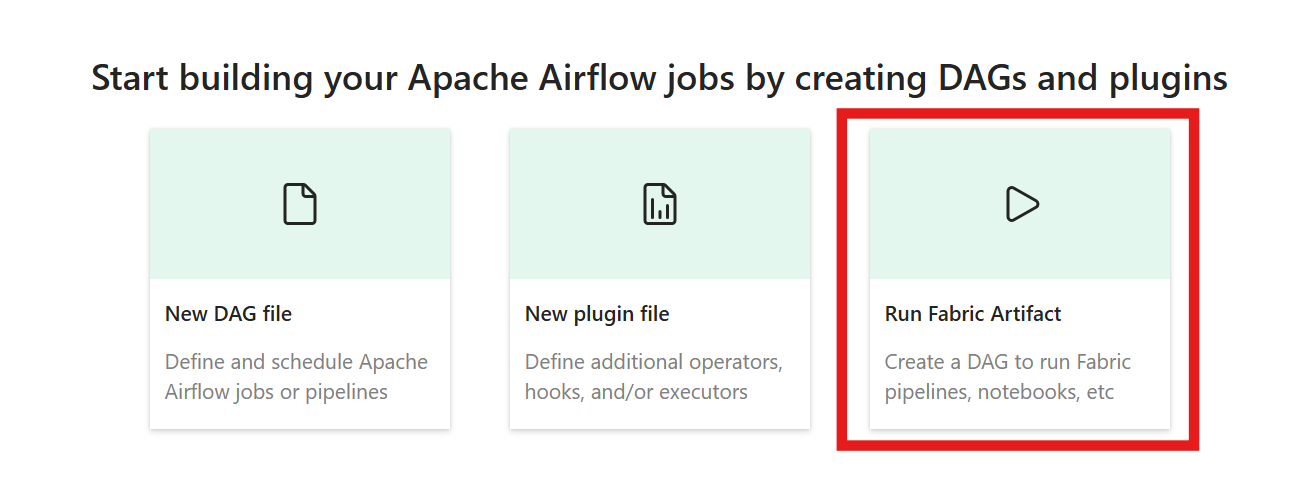
Figura 2. Empieza por Run Fabric Artifact cuando el DAG deba disparar notebooks o pipelines sin meter lógica de transformación en el orquestador. Fuente: Microsoft Learn: run a Fabric item using Apache Airflow.
Diseño
1. Un DAG, tareas ligeras, nombres honestos
Dibuja el flujo para que alguien recién llegado lo lea sin que se lo expliquen: cargar, validar, transformar, publicar, notificar. Cada tarea debe hacer una sola cosa clara. Si una tarea crece hasta ser "todo lo que viene después de bronze", pierdes los reintentos limpios y la capacidad de decir qué paso falló de verdad. Prefiere muchos operadores pequeños que llamen a Fabric antes que un operador gigante que esconde un workflow privado. La figura 3 muestra la diferencia de forma.
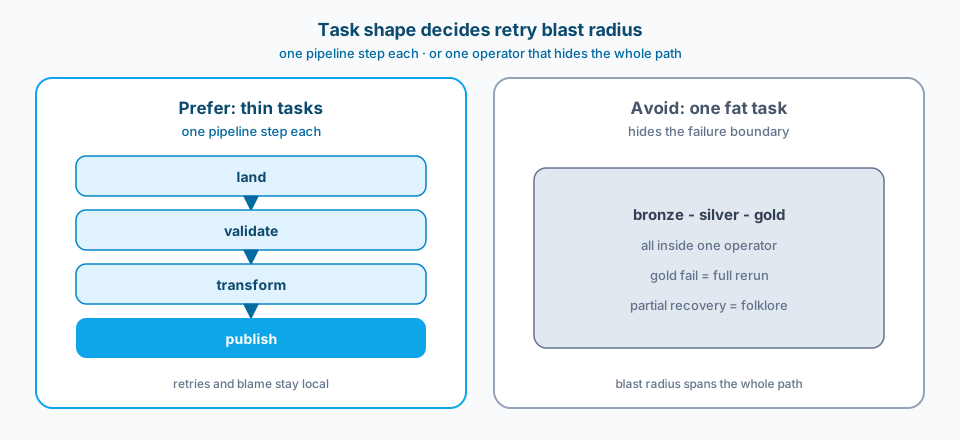
Figura 3. Las tareas ligeras mantienen locales los reintentos y la responsabilidad. Un único operador grueso de bronze a gold convierte un fallo en gold en una reejecución completa.
2. Fabric ejecuta; Airflow coordina
Dispara jobs, pipelines o notebooks de Fabric desde Airflow. No copies la lógica de Spark en Python de Airflow para ir más rápido. El plano de ejecución se queda en Fabric, donde ya viven la capacidad, las identidades y los vínculos con el lakehouse. Airflow debe pasar parámetros, esperar a que termine y reaccionar al estado. Cuando el estado sea ambiguo, arregla el contrato del job de Fabric. No lo tapes con sleeps más largos. La figura 1 es el reparto de responsabilidades; la figura 2 es el punto de entrada del producto que mantiene las transformaciones fuera del DAG.
3. Contratos explícitos de éxito y fallo
Cada tarea necesita una definición de terminado que se pueda comprobar: recuentos de filas, presencia de archivos, quality gate superado, estado del pipeline, estado del refresh semántico. "Se ejecutó" no es un contrato. El éxito parcial sin un gate con nombre es como las tablas gold acaban refrescándose a partir de un silver incompleto. Pon el gate en el DAG, donde se vea, no solo en un comentario del notebook. La figura 4 es el contrato que más importa entre los dos planos.
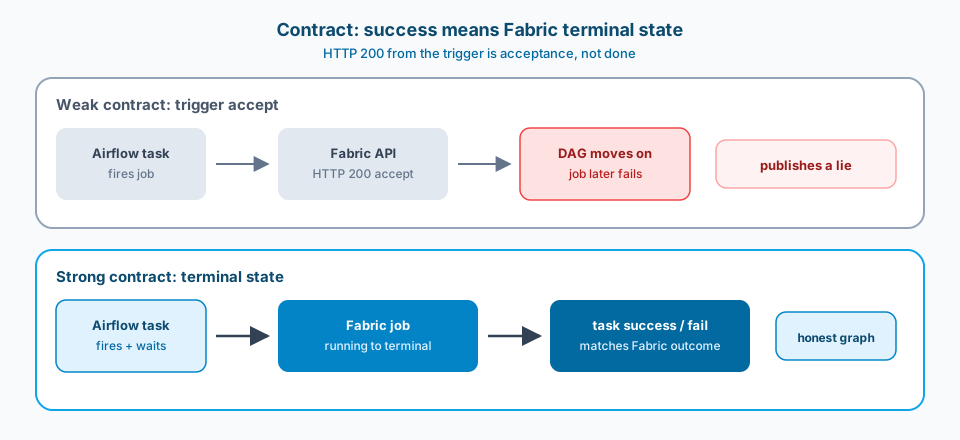
Figura 4. Un HTTP 200 del disparo no significa terminado. Espera al estado final en Fabric y luego marca la tarea de Airflow como correcta o fallida.
4. Reintentos acordes al tipo de fallo
Los fallos pasajeros de la plataforma merecen un reintento automático con backoff. Los datos malos y los esquemas rotos, no. Trata los fallos de validación como definitivos para esa ejecución, salvo que tengas una ruta de cuarentena deliberada. Los reintentos a ciegas ante fallos de calidad queman capacidad y esconden el incidente real bajo una tormenta de reintentos que parece verde.
5. Observabilidad que nombra el paso
Los operadores, los run ids y el texto de las alertas deben señalar en el mismo mensaje el artefacto de Fabric que falló y la tarea del DAG. Un aviso que dice "pipeline failed" sin el id de la tarea ni la URL de la ejecución en Fabric obliga a reconstruir el contexto bajo presión. Diseña la alerta como parte del DAG, no como algo añadido a última hora en una regla de un buzón compartido.
La figura 5 es la superficie de monitorización que hace legible ese contrato: id de la tarea, operador, estado y duración de la ejecución de un elemento de Fabric. Cuando el DAG espera al estado final, esta vista y el historial de ejecuciones de Fabric deberían coincidir.
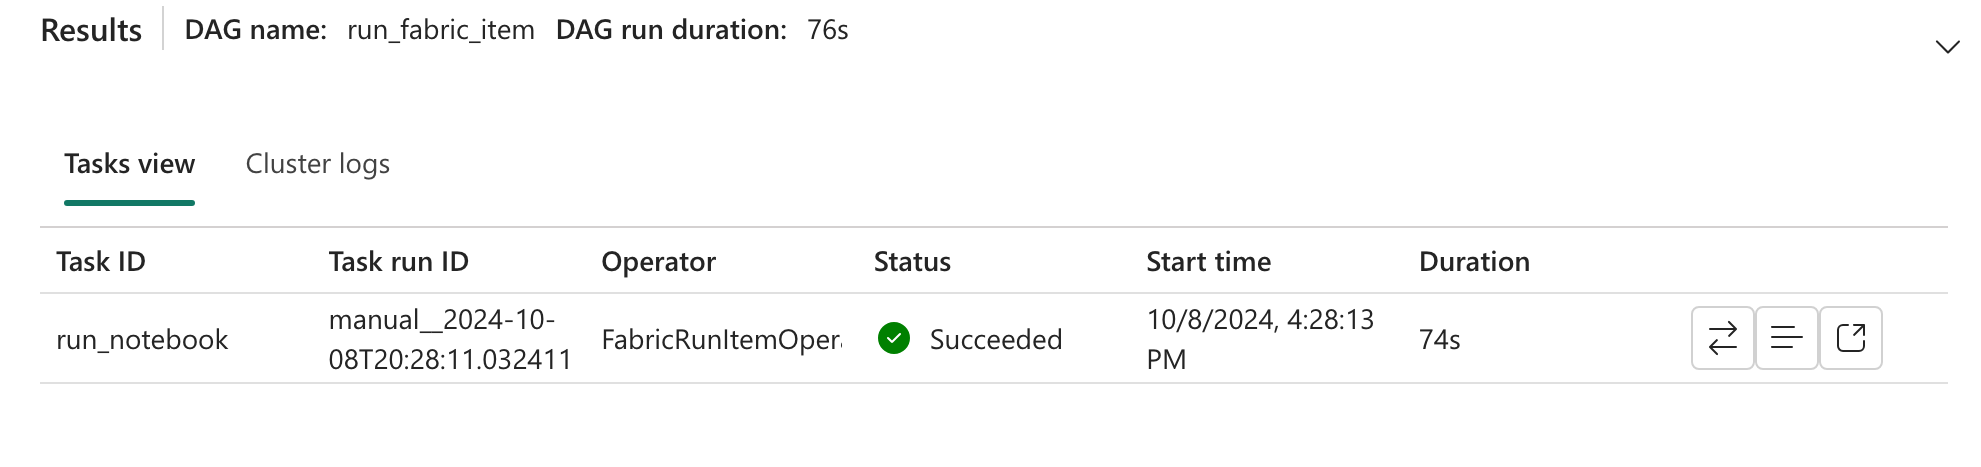
Figura 5. Vista de tareas de la ejecución de un elemento de Fabric: id de la tarea, operador, estado y duración en un solo sitio. Fuente: Microsoft Learn: run a Fabric item using Apache Airflow (Monitor your DAG).
6. Entornos como parámetros, no como forks
Dev, Test y Prod deberían tener la misma forma de DAG con distintos destinos de Fabric, identidades y planificaciones. Los DAG copiados y pegados por entorno se desvían en el primer hotfix. Parametriza los ids de workspace, lakehouse y conexión igual que parametrizarías un despliegue de Fabric. Los nombres bonitos cambian. Los ids deben ser el contrato.
Errores comunes
El orquestador hace la transformación. Los notebooks de Airflow o los operadores de Python van recreando poco a poco lo que Fabric ya gestiona. Ahora tienes dos sitios donde parchear la lógica y ningún responsable único. La figura 2 existe para que no tomes ese camino por defecto.
Una tarea gruesa para todo el camino medallion. Un fallo en gold obliga a reejecutar todo desde bronze. El tiempo y el coste se disparan. La recuperación parcial se convierte en folclore. La figura 3 hace visible el blast radius.
Dependencias ocultas fuera del DAG. Un refresh de un semantic model que alguien lanza después de comer sigue siendo una dependencia. Si no está en el grafo, la guardia se enterará por un informe roto, no por Airflow.
Éxito significa un HTTP 200 del disparo. El disparo aceptó el job. El job falló después. Tu DAG ya había seguido adelante. Espera al estado final o publicarás datos falsos. La figura 4 es el contrato débil frente al fuerte.
Secretos e identidades en dos sitios. Las conexiones de Airflow y las identidades del workspace de Fabric no coinciden. Las ejecuciones funcionan con la planificación de un portátil y fallan en el entorno compartido. Centraliza cómo se vinculan los service principals y las referencias a Key Vault.
Alertas sin nombre de paso. Un aviso en el buzón que no puede nombrar la tarea del DAG ni la ejecución de Fabric deja a la gente reconstruyendo el contexto bajo presión. La figura 5 es la superficie mínima a la que debería remitir la alerta.
Úsalo tal cual o adáptalo
Úsalo tal cual
- Fabric se encarga del trabajo del plano de datos; Airflow, de los contratos de planificación, dependencias, reintentos y alertas.
- Las tareas tienen un único propósito y llevan el nombre del paso del pipeline, no de la llamada a la herramienta.
- El estado final del job de Fabric es la condición de éxito de la tarea, no la aceptación del disparo.
- Los quality gates son tareas explícitas del DAG con un comportamiento de fallo definido.
- Los destinos de cada entorno están parametrizados; nada de DAG duplicados por etapa.
- Las alertas incluyen el id de la tarea del DAG, la URL de la ejecución en Fabric y el artefacto que falló.
- Nada de lógica de transformación duplicada en operadores de Airflow sin una excepción por escrito.
Adáptalo antes de usarlo
Airflow añade otro runtime que operar: workers, schedulers, versiones de paquetes y rutas de red hacia las API de Fabric. Ese coste es real. Para un único notebook nocturno sin dependientes, puede bastar con la planificación nativa de Fabric. Recurre a Airflow cuando aparezcan dependencias entre jobs, SLA compartidos o coordinación entre varios sistemas.
También tendrás que negociar la responsabilidad. Los equipos de plataforma suelen querer orquestación nativa de Fabric. Los data engineers suelen querer DAG legibles y los operadores del ecosistema. Decide según el grafo de dependencias que tienes que explicar, no según qué demo quedó más fluida en un taller.
El throttling de la API importa cuando muchos DAG atacan el mismo entorno de Fabric. Fija límites de concurrencia antes de escalar jobs cada hora.
Relacionado
Una buena lectura siguiente cuando el contrato de orquestación ya es honesto: las decisiones de topología del lakehouse. Empieza por Un lakehouse con esquemas frente a muchos lakehouses cuando los límites de workspaces y esquemas sean la siguiente decisión.
Referencias principales: Microsoft Learn sobre Fabric Data Factory y pipelines, notebooks en Fabric, run a Fabric item using Apache Airflow, y la documentación de Apache Airflow sobre DAG y tareas.
Carga de trabajo. Planificación. Contrato. Tres preocupaciones. Dos herramientas. Un DAG legible.