

Das Wichtigste in Kürze
- Fabric führt die Arbeit aus. Airflow verantwortet Zeitplan, Graph, Retries und Alerts.
- Erfolg heißt Endzustand in Fabric, nicht angenommener Trigger.
- Setz lieber auf viele schlanke Tasks, benannt nach dem Pipeline-Schritt.
- Platzier Quality Gates im DAG, wo sie sichtbar sind.
- Bau Fabric-Transformationen nicht in Airflow-Operatoren nach.
- Greif zu Airflow, wenn Abhängigkeiten zwischen Jobs einen ehrlichen Graphen brauchen.
Ja, wenn du die beiden als zwei Ebenen behandelst. Fabric soll die Arbeit machen. Airflow soll den Zeitplan, den Abhängigkeitsgraphen, die Retries und die On-Call-Sicht auf den Lauf verantworten.
Airflow lohnt sich, wenn eine Fabric-Umgebung im Portal gut aussieht und trotzdem auseinanderfällt, weil drei Jobs fertig sein müssen, bevor ein vierter starten kann. Die nativen Zeitpläne haben einzelne Jobs abgedeckt. Einen Graphen haben sie nicht erklärt. Die Koordination in Notebooks zu stopfen, hat jede Änderung riskanter wirken lassen als die Transformation selbst.
Benanntes Modell: zwei Ebenen
- Ausführungsebene (Fabric): Notebooks, Pipelines, Arbeit im Lakehouse, Warehouse-Operationen, semantischer Refresh.
- Orchestrierungsebene (Airflow): Zeitplan, Abhängigkeiten, Retries, Alerts, eine Laufhistorie, die Menschen lesen können.
- Vertrag: Jeder Airflow-Task wartet auf den Endzustand in Fabric, nicht auf den angenommenen Trigger.
- Form: viele schlanke Tasks, benannt nach dem Pipeline-Schritt. Quality Gates sind sichtbare Schritte im DAG.
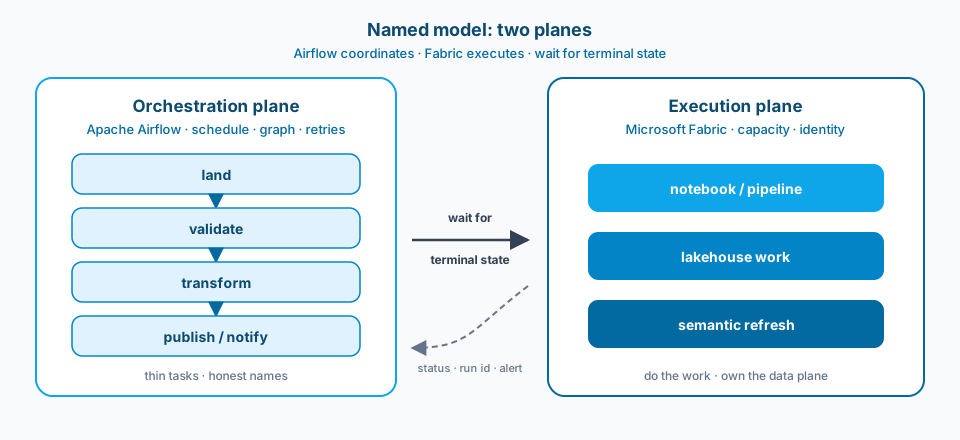
Abbildung 1. Airflow koordiniert, Fabric führt aus. Der durchgezogene Pfeil ist das Warten auf den Endzustand. Der gestrichelte Rückweg sind Status, Run-ID und Alert-Text. Kein Fire and Forget.
Kontext und Rahmenbedingung
Fabric Notebooks und Pipelines sind stark darin, Arbeit zu erledigen. Als Kalender und Abhängigkeitsgraph für alles drumherum sind sie schwächer. Sobald der Weg Laden, Validieren, Transformieren, Veröffentlichen heißt, brauchst du eine Orchestrierungsebene, die nicht so tut, als wäre sie noch eine Transformations-Engine.
Airflow passt, wenn du einen ehrlichen DAG willst. Halte die Tasks schlank. Ruf Fabric auf. Bau Fabric nicht in Operatoren nach, nur weil es an einem Freitag bequem war. Wenn du anfängst, Transformationen in Python in Airflow neu zu implementieren, hast du eine zweite Source of Truth geschaffen. Bequemlichkeit ist der Weg, auf dem Orchestrierungsschichten dick und dann undurchsichtig werden.
Fabric Airflow Jobs machen diese Trennung in der Produktoberfläche konkret. Abbildung 2 ist die Kachel aus Learn, mit der ein DAG startet, dessen Aufgabe es ist, ein Fabric-Item auszuführen, nicht die Spark-Logik zu beherbergen. Der Orchestrator bleibt absichtlich schlank.
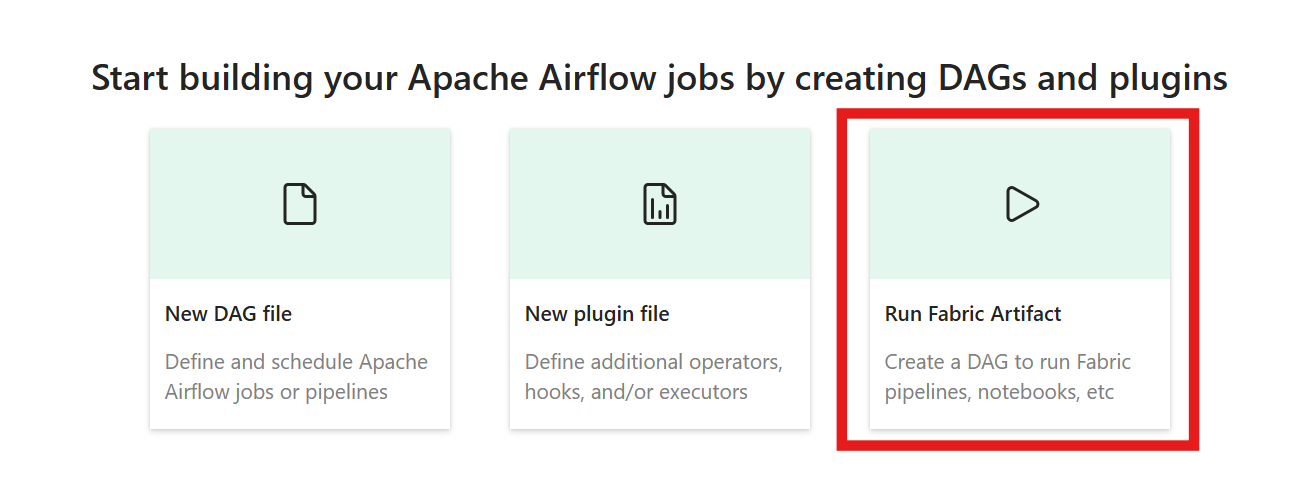
Abbildung 2. Starte mit Run Fabric Artifact, wenn der DAG Notebooks oder Pipelines auslösen soll, ohne Transformationslogik in den Orchestrator zu stopfen. Quelle: Microsoft Learn: run a Fabric item using Apache Airflow.
Design
1. Ein DAG, schlanke Tasks, ehrliche Namen
Bild den Ablauf so ab, dass eine neue Kollegin ihn ohne Einführung lesen kann: Laden, Validieren, Transformieren, Veröffentlichen, Benachrichtigen. Jeder Task soll eine klare Sache tun. Wenn ein Task zu "alles nach Bronze" anwächst, verlierst du saubere Retries und die Möglichkeit zu sagen, welcher Schritt tatsächlich fehlgeschlagen ist. Setz lieber auf viele kleine Operatoren, die Fabric aufrufen, als auf einen riesigen Operator, der einen privaten Workflow versteckt. Abbildung 3 zeigt den Unterschied in der Form.
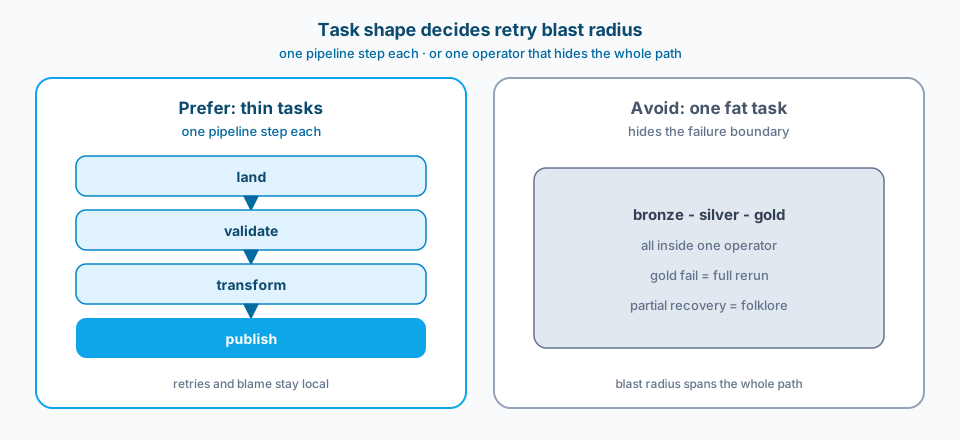
Abbildung 3. Schlanke Tasks halten Retries und Verantwortung lokal. Ein dicker Operator von Bronze bis Gold macht aus einem Fehler in Gold einen kompletten Neulauf.
2. Fabric führt aus, Airflow koordiniert
Löse Fabric Jobs, Pipelines oder Notebooks aus Airflow aus. Kopier die Spark-Logik nicht der Geschwindigkeit wegen in Python-Code in Airflow. Die Ausführungsebene bleibt in Fabric, wo Kapazität, Identitäten und Lakehouse-Bindungen ohnehin liegen. Airflow soll Parameter übergeben, auf den Abschluss warten und auf den Status reagieren. Wenn der Status unklar ist, korrigier den Vertrag des Fabric Jobs. Überdeck es nicht mit längeren Sleeps. Abbildung 1 ist die Aufteilung der Verantwortung, Abbildung 2 der Einstieg im Produkt, der Transformationen aus dem DAG heraushält.
3. Explizite Verträge für Erfolg und Fehler
Jeder Task braucht eine prüfbare Definition von fertig: Zeilenzahlen, vorhandene Dateien, bestandenes Quality Gate, Pipeline-Status, Zustand des semantischen Refresh. "Es ist gelaufen" ist kein Vertrag. Teilerfolg ohne benanntes Gate ist der Weg, auf dem Gold-Tabellen aus unvollständigem Silver aktualisiert werden. Platzier das Gate im DAG, wo es sichtbar ist, nicht nur in einem Notebook-Kommentar. Abbildung 4 ist der Vertrag, der zwischen den Ebenen am meisten zählt.
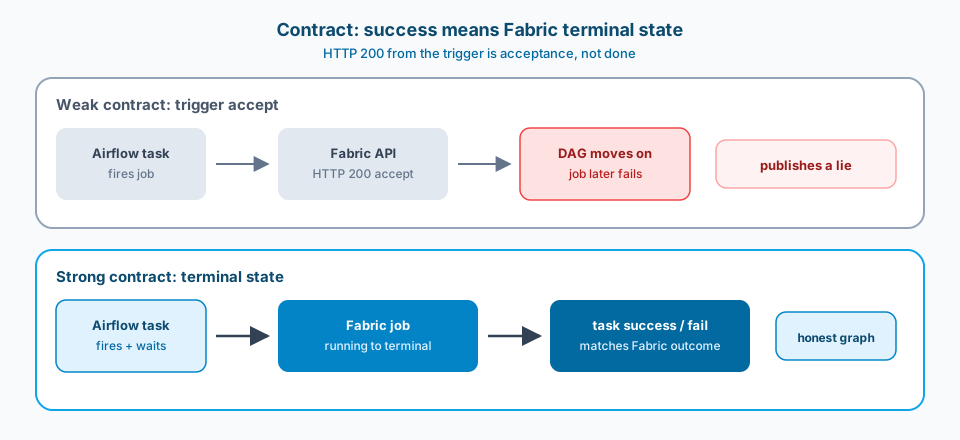
Abbildung 4. HTTP 200 vom Trigger heißt nicht fertig. Warte auf den Endzustand in Fabric und markier dann den Airflow-Task als erfolgreich oder fehlgeschlagen.
4. Retries, die zur Fehlerart passen
Vorübergehende Aussetzer der Plattform verdienen einen automatischen Retry mit Backoff. Schlechte Daten und kaputte Schemas nicht. Behandle Validierungsfehler für diesen Lauf als endgültig, es sei denn, du hast einen bewussten Quarantäne-Pfad. Blinde Retries bei Qualitätsfehlern verbrennen Kapazität und verstecken den eigentlichen Vorfall unter einem grün aussehenden Retry-Sturm.
5. Observability, die den Schritt benennt
Operatoren, Run-IDs und Alert-Text sollen in derselben Nachricht auf das fehlgeschlagene Fabric-Artefakt und den DAG-Task zeigen. Eine Meldung "pipeline failed" ohne Task-ID und ohne URL des Fabric-Laufs zwingt Leute, den Kontext unter Druck zu rekonstruieren. Entwirf den Alert als Teil des DAG, nicht als nachträgliche Regel in einem geteilten Postfach.
Abbildung 5 ist die Monitoring-Oberfläche, die diesen Vertrag lesbar macht: Task-ID, Operator, Status und Dauer für den Lauf eines Fabric-Items. Wenn der DAG auf den Endzustand wartet, sollten diese Ansicht und die Laufhistorie in Fabric übereinstimmen.
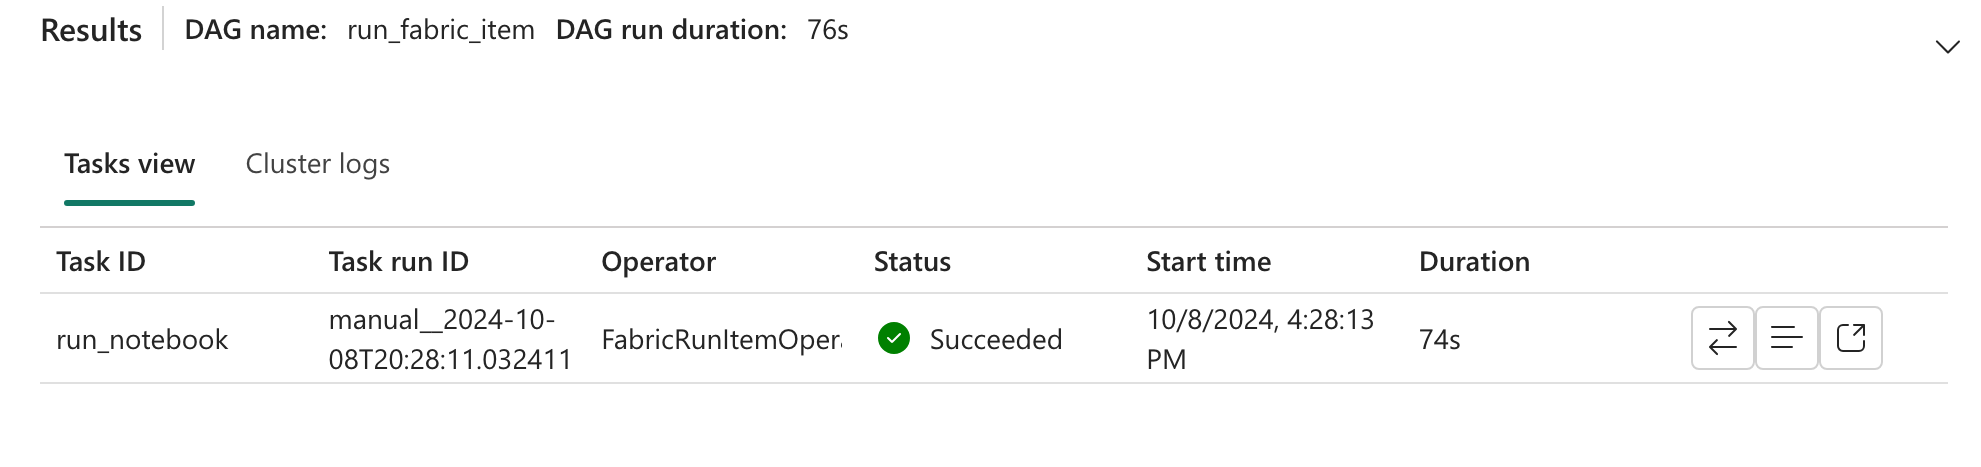
Abbildung 5. Tasks-Ansicht für den Lauf eines Fabric-Items: Task-ID, Operator, Status und Dauer an einem Ort. Quelle: Microsoft Learn: run a Fabric item using Apache Airflow (Monitor your DAG).
6. Umgebungen als Parameter, nicht als Forks
Dev, Test und Prod sollten dieselbe DAG-Form haben, mit anderen Fabric-Zielen, Identitäten und Zeitplänen. Pro Umgebung kopierte DAGs driften beim ersten Hotfix auseinander. Parametrisiere Workspace-, Lakehouse- und Connection-IDs genauso, wie du ein Fabric-Deployment parametrisieren würdest. Hübsche Namen ändern sich. IDs sollten der Vertrag sein.
Häufige Fehler
Der Orchestrator macht die Transformation. Airflow-Notebooks oder Python-Operatoren bilden nach und nach ab, was Fabric schon verantwortet. Jetzt gibt es zwei Stellen, an denen du Logik patchst, und keinen einzelnen Verantwortlichen. Abbildung 2 gibt es, damit du diesen Weg nicht standardmäßig einschlägst.
Ein dicker Task für den ganzen Medallion-Pfad. Ein Fehler in Gold erzwingt einen kompletten Neulauf ab Bronze. Zeit und Kosten explodieren. Teilweise Wiederherstellung wird zur Folklore. Abbildung 3 macht den Blast Radius sichtbar.
Versteckte Abhängigkeiten außerhalb des DAG. Ein Refresh des semantic model, den jemand nach dem Mittagessen startet, ist trotzdem eine Abhängigkeit. Wenn er nicht im Graphen steht, erfährt On-Call davon durch einen kaputten Bericht, nicht durch Airflow.
Erfolg heißt HTTP 200 vom Trigger. Der Trigger hat den Job angenommen. Der Job ist später fehlgeschlagen. Dein DAG ist längst weitergelaufen. Warte auf den Endzustand, sonst veröffentlichst du Falsches. Abbildung 4 zeigt den schwachen Vertrag gegenüber dem starken.
Secrets und Identitäten an zwei Orten. Airflow-Connections und Workspace-Identitäten in Fabric widersprechen sich. Läufe funktionieren nach dem Zeitplan auf einem Laptop und scheitern in der gemeinsamen Umgebung. Zentralisiere, wie Service Principals und Key-Vault-Referenzen gebunden werden.
Alerts ohne Schrittnamen. Eine Meldung im Postfach, die weder den DAG-Task noch den Fabric-Lauf benennen kann, lässt Leute den Kontext unter Druck rekonstruieren. Abbildung 5 ist die Mindestoberfläche, auf die der Alert zurückverweisen sollte.
So übernehmen oder anpassen
So übernehmen
- Fabric verantwortet die Arbeit auf der Datenebene. Airflow verantwortet die Verträge für Zeitplan, Abhängigkeiten, Retries und Alerts.
- Tasks haben genau einen Zweck und sind nach dem Pipeline-Schritt benannt, nicht nach dem Tool-Aufruf.
- Der Endzustand des Fabric Jobs ist die Erfolgsbedingung des Tasks, nicht der angenommene Trigger.
- Quality Gates sind explizite DAG-Tasks mit festgelegtem Verhalten bei Fehlern.
- Umgebungsziele sind parametrisiert. Keine geforkten DAGs pro Stage.
- Alerts enthalten DAG-Task-ID, URL des Fabric-Laufs und das fehlgeschlagene Artefakt.
- Keine Transformationslogik, die in Airflow-Operatoren dupliziert wird, ohne schriftlich festgehaltene Ausnahme.
Vor dem Einsatz anpassen
Airflow bringt eine weitere Laufzeit mit, die du betreiben musst: Worker, Scheduler, Paketversionen und Netzwerkpfade zu den Fabric APIs. Diese Kosten sind real. Für ein einzelnes nächtliches Notebook ohne Abhängige reicht vielleicht das native Scheduling von Fabric. Greif zu Airflow, wenn Abhängigkeiten zwischen Jobs, gemeinsame SLAs oder Koordination über mehrere Systeme dazukommen.
Du wirst auch über Verantwortung verhandeln. Plattformteams wollen oft Fabric-native Orchestrierung. Data Engineers wollen oft lesbare DAGs und die Operatoren aus dem Ökosystem. Entscheide nach dem Abhängigkeitsgraphen, den du erklären musst, nicht danach, welche Demo in einem Workshop glatter aussah.
API-Throttling spielt eine Rolle, wenn viele DAGs dieselbe Fabric-Umgebung ansprechen. Leg Concurrency-Limits fest, bevor du stündliche Jobs skalierst.
Verwandte Notizen
Eine gute nächste Lektüre, sobald der Orchestrierungsvertrag ehrlich ist: Entscheidungen zur Lakehouse-Topologie. Fang mit Ein Lakehouse mit Schemas oder viele Lakehouses an, wenn Grenzen von Workspaces und Schemas die nächste Entscheidung sind.
Wichtigste Quellen: Microsoft Learn zu Fabric Data Factory und Pipelines, Notebooks in Fabric, run a Fabric item using Apache Airflow und die Dokumentation von Apache Airflow zu DAGs und Tasks.
Workload. Zeitplan. Vertrag. Drei Anliegen. Zwei Tools. Ein lesbarer DAG.